网站被 AI 收录要多久?从被抓取到被引用的完整时间表
「上周发的文章,我昨天在豆包里问了一圈,一个字都没提到。」
这是最近被问得最多的一句话。发完内容第二天就去问 AI,没结果,于是判断「GEO 没用」。这个判断错在哪?错在把三件完全不同的事混成了一件事:抓取、索引、引用。
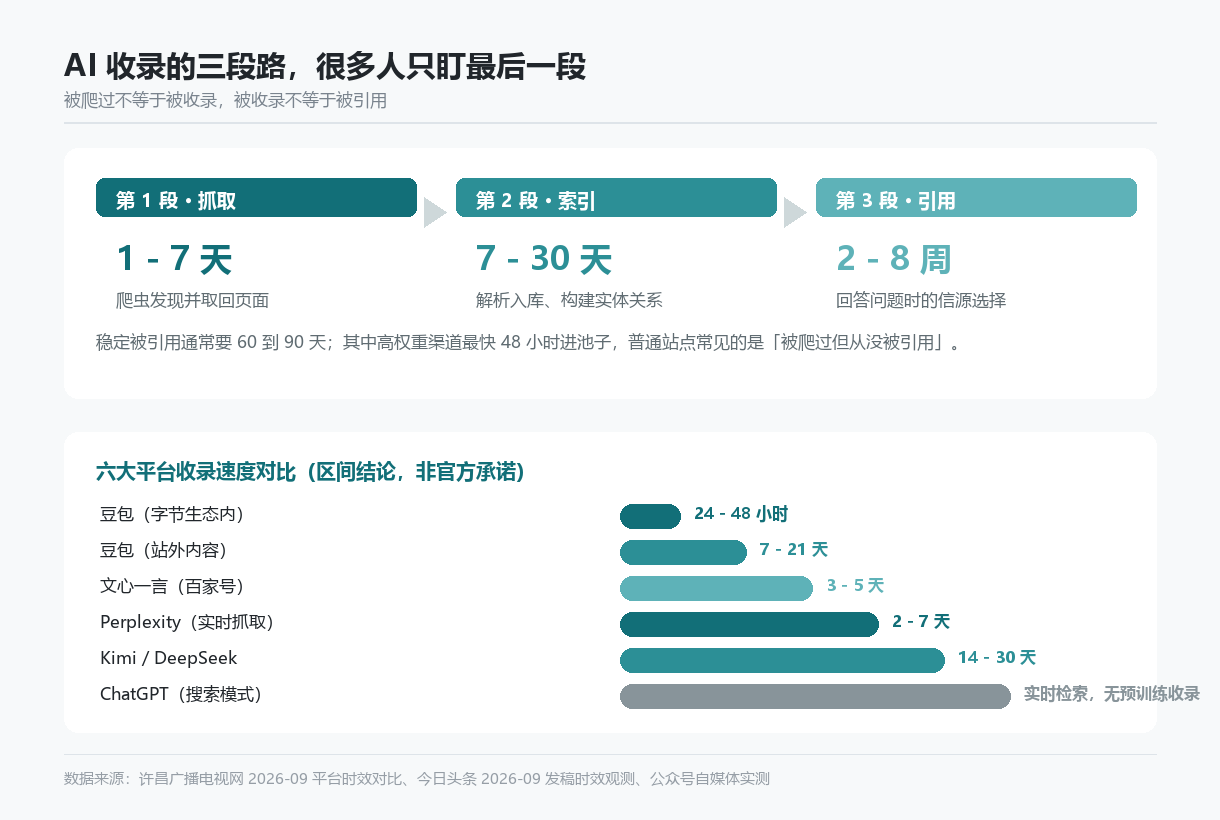
先说结论,方便你对号入座:抓取通常 1 到 7 天,索引 7 到 30 天,真正被引用从 2 到 4 周起步,稳定引用一般要 60 到 90 天。高权重渠道能压缩到 48 小时进池子,普通站点常见的结果是「被爬过,但从没被引用」。
AI 收录的三个阶段,分别发生了什么?
AI 不是把网页「学」进模型再背出来,而是走一条实时链路:抓取 → 索引入库 → 检索引用。任何一段断了,都不会出现在答案里。
| 阶段 | 机器在做什么 | 常见耗时 | 卡住的典型表现 |
|---|---|---|---|
| 抓取 | 爬虫发现链接、取回页面内容 | 1 到 7 天 | 日志里完全没有这个爬虫的记录 |
| 索引 | 解析结构、提取实体、建立关系入库 | 7 到 30 天 | 日志有访问,但搜索品牌名毫无反应 |
| 引用 | 用户提问时,从候选池里择优采信 | 2 到 4 周起,稳定需 60 到 90 天 | 能搜到,但 AI 回答里换成别家的内容 |
把这张表记住,后面所有的抱怨都能对上号。90% 的「没效果」,其实停在第二阶段和第三阶段之间。
为什么别人 48 小时就进池子,我要等一个月?
因为收录速度不是随机的,它由五个信号决定。你能控制其中的四个。
| 信号 | 作用机制 | 对速度的影响 |
|---|---|---|
| 渠道权重 | 高权重信源被爬虫优先调度 | 生态内内容快 3 到 10 倍 |
| 可抓取性 | 公开可访问、不被 robots 拦、正文服务端直出 | 被拦则直接归零 |
| 结构化程度 | 标题层级清晰、结论前置、有 FAQ 与 Schema | 决定能否被低成本切成片段 |
| 时效与更新频率 | 常更新的站点爬虫来访更勤 | 定期更新站点快 40% 左右 |
| 主动提交 | 站长平台、IndexNow 等主动触发抓取 | 加速 30% 到 60% |
有一点要提前说清楚:AI 的引用集合本身是滚动轮换的,周度轮换率大致在七成到八成。这意味着「今天没被引用」和「永远不被引用」是两件事,别拿一次提问的结果下结论。
六大平台的收录速度差多少?
不同平台的检索方式不一样,快慢差得很多。做投放和内容分发时,按平台特性排优先级,比平均用力有效。
| 平台 | 收录速度 | 说明 |
|---|---|---|
| 豆包(字节生态内) | 24 到 48 小时 | 抖音、头条、头条号内容几乎天然在池 |
| 豆包(站外内容) | 7 到 21 天 | 2026 年 6 月后外站收录量提升约一成半,是窗口期 |
| 文心一言 | 3 到 5 天(百家号) | 背靠百度索引,站外通常 1 到 3 周 |
| Perplexity | 2 到 7 天 | 全平台实时抓取,对新鲜度最敏感 |
| Kimi / DeepSeek | 14 到 30 天 | 去生态化,偏好垂直媒体、知乎与学术来源 |
| ChatGPT | 搜索模式实时检索 | 无实时收录一说,靠联网抓取;预训练更新以季度计 |
注意这些是区间结论,不是平台的官方承诺。行业里比较可靠的观测口径是:同一提示词在同一平台重复提问不少于 20 次,统计引用率,而不是看单次有没有命中——AI 回答有随机性,单次命中说明不了任何问题。
一份可以照着做 30 天的观察表
与其焦虑,不如把过程记录下来。这张表适用于任何一篇文章。
| 时点 | 看什么 | 说明 |
|---|---|---|
| T + 6 小时 | 服务器日志里有没有爬虫 | 看是否有 GPTBot、Bytespider、ClaudeBot 等爬虫访问 |
| T + 24 小时 | 站点地图是否被读取 | sitemap 有访问记录说明发现通路正常 |
| T + 3 天 | 搜索品牌名 + 文章标题 | 能被搜到 = 索引基本完成 |
| T + 7 天 | 在目标平台问相关问题 20 次 | 记录被提及次数,形成基线 |
| T + 15 天 | 同上,看是否出现引用 | 出现引用说明进入候选池 |
| T + 30 天 | 对比基线与当前 | 引用率上升、或来源里出现自家站点 |
这张表的价值在于:它把「玄学」变成了可以判断的节点。到 30 天还是零引用,问题一定出在内容结构或信源布局上,而不是「AI 不喜欢我」。
想让收录更快,按顺序做这五件事
一、先把发现通路打通
提交 sitemap、用 IndexNow 主动推送、检查 robots.txt 有没有误拦 AI 爬虫。这一步的效果最直接——行业观察显示主动提交能把抓取提前 30% 到 60%。
二、给新页面接上几条内链
从已有权重的高流量页面链接到新页面,是最便宜的加速方式。爬虫顺着链接走,比等着它自己发现要快得多。
三、保持稳定更新节奏
爬虫的来访频率和站点的更新频率正相关。每月稳定更新 8 到 20 篇的站点,新内容被发现的平均时间明显短于半年不动的站点。
四、答案前置,别让机器猜
开头三行给结论、每个 H2 下 40 到 60 字直接回答、对比用表格。这一条决定的是第三阶段——能不能被引用,而不只是被收录。
五、多信源印证同一件事
同一组事实和数据,在官网、行业媒体、问答社区各出现一次,且口径一致。多源一致会显著提高被采信的概率,这也是「孤证不利」的实操解法。
三个最容易踩的误判
- 「日志里有爬虫,就说明收录了」——抓取只是第一段,索引和引用都还没发生
- 「改一下发布日期就算更新」——爬虫会对比新旧版本,没有实质变化反而会被视为操纵,只改日期是负分
- 「问了一次没有,就是没被引用」——引用有随机性,必须重复提问取比例,否则等于抛硬币
延伸阅读
常见问题
Q1:为什么我搜品牌名能搜到,问 AI 却从不提我?
说明你已经过了抓取和索引两关,卡在引用关。常见原因有三个:内容里没有可直接摘取的答案;全网信息口径不一致;缺少第三方来源印证。先修这三样,再谈时间。
Q2:新站要多久才能被 AI 引用?
新域名通常需要 60 到 90 天才能形成跨平台的抓取覆盖,之后才会出现零星引用。老站换新内容要快得多,因为爬虫的访问频率已经建立。这也是为什么「用老站发新内容」是起步阶段更划算的做法。
Q3:一天发多篇会不会更快被收录?
不会。收录速度看的是站点更新频率的量级,不是单日爆发。更高效的做法是保持稳定节奏(比如每周固定发 3 到 5 篇),并且每篇都做结构化处理。
Q4:怎么判断自己是被拦住了,还是只是还没轮到?
查服务器日志。如果一个月内完全没有 AI 爬虫的记录,就是被拦或未被发现;如果有访问记录但排名和引用都没有,问题在内容与信源层。这两个判断会指向完全不同的修复动作,别猜。
GEO 的时间账很好算:抓取按天算,索引按周算,引用按月算。用月的耐心做天的事,只会得出错误的结论。
把「多久见效」拆成三段,焦虑就变成了待办清单。
今天先做一件小事:给你最新发布的那篇文章,在日志里查一下它有没有被爬虫访问过。
《网站被 AI 收录要多久?从被抓取到被引用的完整时间表》有2个想法