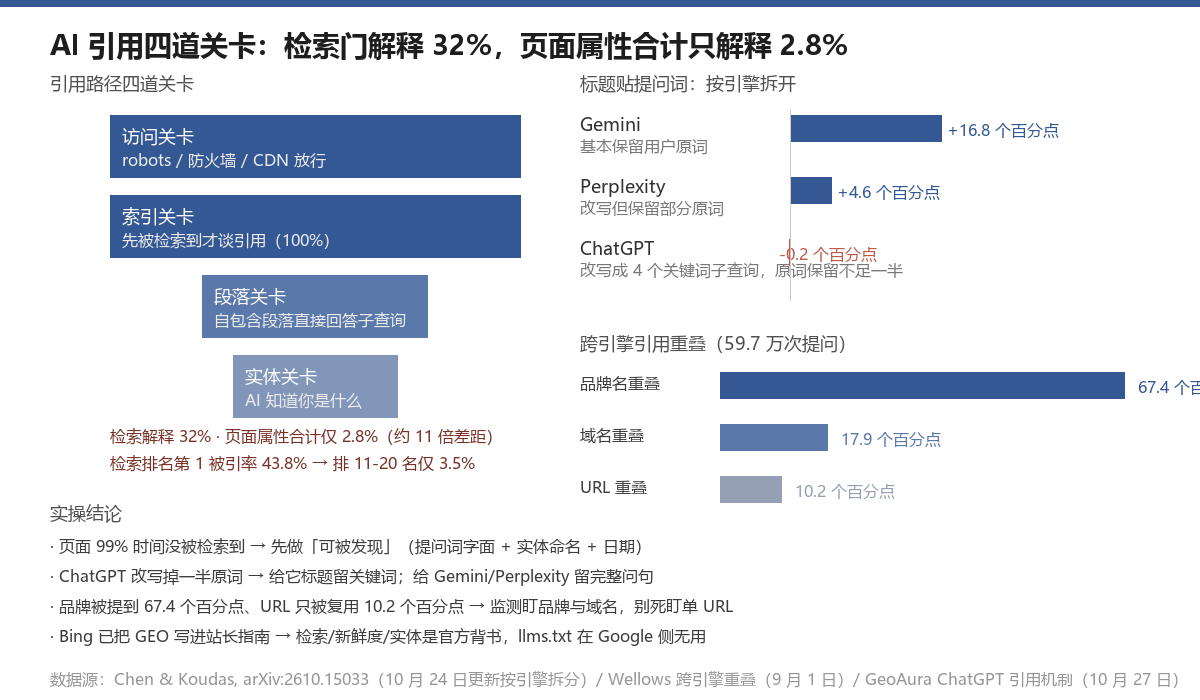
过去半年,GEO 圈最热闹的词是「结构优化」:FAQ 块、结构化数据、摘要框、加粗重点、页面提速。10 月 24 日 GeoAura 更新的两篇研究把这套打法重新排了序——而且结论不太客气:这些页面属性加起来,只解释 AI 引用差异的 2.8 个百分点;而「引擎自己检索到了什么」一项就解释 32 个百分点。差了 11 倍。
这意味着大部分 GEO 预算投错了门。这篇文章把「四道关卡」讲清楚,再给出按引擎拆分的操作差异——同一个动作,在 Gemini、Perplexity、ChatGPT 三个引擎上的效果差到几乎没有关系。
发生了什么:一项站内对照实验把 11 倍差距钉死了
Chen & Koudas(arXiv 2610.15033,10 月 10 日首发,24 日更新按引擎拆分)做了 2026 年最大规模的引用对照研究:158,099 条 AI 答案、468,037 条引用、90 天观测、覆盖 ChatGPT / Gemini / Perplexity 三个引擎。方法的关键是「只在同一网站内部比页面」——品牌权重、域名权重全部被固定,剩下的差异才是页面自身能造成的。
| 测量项 | 解释的引用差异 | 含义 |
|---|---|---|
| 引擎自身检索结果 | 32 个百分点 | 页面排进检索候选池的位置,是引用与否的头号变量 |
| 所有页面属性合计(FAQ/结构数据/摘要框/作者框/速度…) | 2.8 个百分点 | 约 11 倍差距——单页结构优化的天花板极低 |
| 被引页面中先被检索到的比例 | 全部 | 检索是先决条件,不是概率事件 |
| 检索排名第 1 的被引率 | 43.8 个百分点 | 检索池里位置就是命运 |
| 检索排名 11-20 名的被引率 | 3.5 个百分点 | 没进头部,基本等于没被引用 |
10 月 24 日更新的拆分更狠:「标题贴提问词」这个唯一通过全部稳健性检验的页面属性,按引擎拆开后效果完全不同——Gemini 提 16.8 个百分点,Perplexity 提 4.6,ChatGPT 只有负 0.2,和零没有区别。原因是机制:ChatGPT 把用户问题改写成约 4 个关键词式子查询,只保留原提问词不到一半(43 个百分点),还加年份。你按用户原词写的标题,恰好优化的是它马上要丢掉的那串字。
一句话:AI 引用你的页面,先过检索门,再谈内容优化。检索门不打开,后面所有关卡都轮不到。
四道关卡:访问、索引、段落、实体,顺序不能乱
GeoAura 把「页面为什么没被引用」整理成四道关卡,且必须按顺序检查——每一道都卡住下一道:
关卡一:访问
robots.txt 允许 AI 爬虫,防火墙 / CDN / WAF 没有把它拦在外面。注意:一条 WAF 规则可以悄悄抵消一份正确的 robots.txt,要在原始日志里验证。系统级变更大约 24 小时才传播完。
关卡二:索引(检索门)
页面得先出现在引擎自己的检索结果里。对照实验说得很死:被引页面全部先被检索到;检索排第 1 被引率 43.8 个百分点,排 11-20 名掉到 3.5。这一关的工具是 Bing Webmaster Tools(ChatGPT 主要吃 Bing 索引)+ IndexNow 推送。
关卡三:段落
被检索到之后,页面上得有一个自包含段落,能单独回答改写后的子查询。答案压在标题下第一句、1-3 句收住;价格、参数、对比放真 HTML 表。这一关页面属性确实有效,但天花板只有那 2.8 个百分点的一部分。
关卡四:实体
模型得知道「你是谁」。同名混淆时,它引用的是它找到的更清楚的那个描述——所以实体命名、官方域名、备案主体要全网一致。这是多数成熟 GEO 项目最后才发现的关卡。
按引擎拆开做:同一个动作,三个引擎三种结果
| 动作 | Gemini | Perplexity | ChatGPT |
|---|---|---|---|
| 标题贴提问词 | +16.8 个百分点(保留用户原词) | +4.6 个百分点(改写保留部分原词) | -0.2 个百分点(改写成 4 个关键词子查询,原词保留不足一半) |
| 关键词式子查询命中 | 弱相关 | 中等相关 | 强相关——给它留关键词 |
| 完整问句命中 | 强相关 | 中等相关 | 弱相关——原词会被丢弃 |
跨引擎的重叠数据(Wellows,596,723 次被两个以上引擎回答的提问)把「为什么要按引擎拆」说得更透:品牌名在答案文本里的重叠率 67.4 个百分点,域名 17.9,URL 只有 10.2。引擎们高度同意「谁该被谈论」,几乎完全不同意「该引用哪个页面」。监测指标跟着这个事实走:盯品牌提及与域名,别死盯单 URL 排名。
两条今天可以直接执行的调整
调整一:预算从「结构装饰」挪回「可被发现」
页面属性合计 2.8 个百分点 vs 检索 32 个百分点。把 FAQ 块再雕三遍,不如做三件事:① 把目标提问词原词写进 H1 和首段(对 Gemini / Perplexity);② 把核心实体名 + 日期写进每个自包含段落(对 ChatGPT 的关键词改写留钩子);③ 用 IndexNow / Bing 站长工具确认页面真的在检索池里。这三件事对应 32 个百分点的那一半杠杆。
调整二:验证顺序改过来——先查检索,再查段落
传统 GEO 排查习惯是先审内容。现在证据说反了:页面 99% 的时间是「没被检索到」,而不是「被检索到但段落不够好」。先用 API replay 或手动提问确认页面进没进引擎的检索候选,再谈段落打磨。检索池里排不进前 10,段落再好也是白做。
官方背书:Bing 把 GEO 写进了站长指南
10 月 9 日微软改写 Bing 站长指南,首次在官方文件里明确定义 GEO,并给出与这篇研究同向的清单:SEO 基础同时支撑 AI 引用资格;实体清晰、URL 聚焦、可独立核验的事实、新鲜度(lastmod + IndexNow)影响 grounding 资格;操纵 AI 引用会同时降搜索排名和 AI 曝光;NOARCHIVE 会直接踢出 Copilot 引用池。注意方向:llms.txt 在 Google 侧已被官方声明「无用」,别再为它花时间。
FAQ
Q:页面属性才 2.8 个百分点,还要不要做结构优化?
A:要,但重新定位。2.8 个百分点是「站内差异」的解释度,不是「做了白做」的意思——它是关卡三(段落)的天花板。正确的预算分配是 40 可访问性 / 20 段落工艺 / 10 实体呈现,剩下的押在检索门(进池 + 池内位置)上。
Q:ChatGPT 标题贴提问词几乎无效,那给 ChatGPT 优化什么?
A:优化它改写后的东西——关键词式子查询。把目标词拆成 3-4 个高置信关键词,分散进 H1、首段、H2,让它改写掉一半原词后仍有字面命中。同时把品牌实体名写清楚,因为它 67 个百分点的情况下会把已知品牌直接写进自己的搜索词。
Q:「检索排第 1 被引 43.8 个百分点」里的检索是谁的检索?
A:各引擎自己的检索(Bing 对 ChatGPT、各引擎内部索引)。不是 Google 排名。Google top 50 之外仍有 3 个百分点的页面会被引用——这就是「AI 引用 ≠ 搜索排名」的量化证据。
Q:这篇文章和 138 期(站内归因)什么关系?
A:138 期讲「为什么同一站里只有几页被引用」,给出站内通过检验的三个指标(best-paragraph 匹配 15.5 / 标题匹配 14.1 / 词重叠 9.1);本期是那篇研究的 10-24 更新版:按引擎拆开后发现标题匹配在 ChatGPT 上失效(-0.2),并补上四道关卡的操作顺序。两篇合起来是完整的方法论。
延伸阅读
- 同一站里,只有那几页被引用——本期研究的站内归因首发解读(138 期)
- 同一个 AI,换个入口就换了答案——入口维度(139 期),与引擎维度叠加
- 大厂把搜索 API 打开给你了,GEO 怎么验收——API replay 验证检索门的工具(147 期)
检索门不打开,所有页面优化都轮不到。 先确认你的页面在引擎的检索池里、位置在前 10,再谈段落与实体。 预算跟着 32 比 2.8 走。
{
“@context”: “https://schema.org”,
“graph”: [
{
“@type”: “Organization”,
“@id”: “https://www.geoshizhan.com/#org”,
“name”: “GEO实战”,
“url”: “https://www.geoshizhan.com/”
},
{
“@type”: “WebSite”,
“@id”: “https://www.geoshizhan.com/#website”,
“url”: “https://www.geoshizhan.com/”,
“publisher”: {
“@id”: “https://www.geoshizhan.com/#org”
}
},
{
“@type”: “Article”,
“headline”: “AI 引用你的页面,先过检索门,再谈内容优化”,
“description”: “Chen & Koudas 用 15.8 万条 AI 答案、46.8 万条引用做的站内对照实验(arXiv 2610.15033):引擎自身检索解释 32 个百分点的引用差异,所有页面属性加起来只解释 2.8 个百分点;所有被引页面都先被检索到;排第 1 的被引率 43.8 个百分点,排 11-20 名只有 3.5 个百分点。按引擎拆:标题贴提问词,Gemini 提 16.8 个百分点、Perplexity 提 4.6、ChatGPT 几乎为零——因为 ChatGPT 把问题改写成 4 个关键词式子查询,只保留原提问词的不到一半。”,
“datePublished”: “2026-10-27”,
“dateModified”: “2026-10-27”,
“author”: {
“@type”: “Organization”,
“name”: “GEO实战”
},
“publisher”: {
“@id”: “https://www.geoshizhan.com/#org”
},
“image”: “https://www.geoshizhan.com/wp-content/uploads/2026/10/geo_152_cover.png”,
“mainEntityOfPage”: “https://www.geoshizhan.com/ai-retrieval-gate-page-gates-geo-2026/”,
“isPartOf”: {
“@id”: “https://www.geoshizhan.com/#website”
}
},
{
“@type”: “FAQPage”,
“mainEntity”: [
{
“@type”: “Question”,
“name”: “页面属性才 2.8 个百分点,还要不要做结构优化?”,
“acceptedAnswer”: {
“@type”: “Answer”,
“text”: “要,但重新定位。2.8 个百分点是站内差异的解释度,不是做了白做——它是关卡三(段落)的天花板。正确的预算分配是 40 可访问性、20 段落工艺、10 实体呈现,剩下的押在检索门上。”
}
},
{
“@type”: “Question”,
“name”: “ChatGPT 标题贴提问词几乎无效,那给 ChatGPT 优化什么?”,
“acceptedAnswer”: {
“@type”: “Answer”,
“text”: “优化它改写后的东西——关键词式子查询。把目标词拆成 3-4 个高置信关键词,分散进 H1、首段、H2,让它改写掉一半原词后仍有字面命中。同时把品牌实体名写清楚,因为它会把已知品牌直接写进自己的搜索词。”
}
},
{
“@type”: “Question”,
“name”: “检索排第 1 被引 43.8 个百分点,这里的检索是谁的检索?”,
“acceptedAnswer”: {
“@type”: “Answer”,
“text”: “各引擎自己的检索(Bing 对 ChatGPT、各引擎内部索引),不是 Google 排名。Google top 50 之外仍有页面会被引用,这就是 AI 引用不等于搜索排名的量化证据。”
}
},
{
“@type”: “Question”,
“name”: “这篇文章和 138 期站内归因什么关系?”,
“acceptedAnswer”: {
“@type”: “Answer”,
“text”: “138 期讲为什么同一站里只有几页被引用,给出通过检验的三个指标;本期是那篇研究的 10 月 24 日更新版,按引擎拆开后发现标题匹配在 ChatGPT 上失效,并补上四道关卡的操作顺序。”
}
}
]
}
]
}