AI 爬虫到底有没有来过?用服务器日志做一次 GEO 体检
「我发了一个月,怎么知道 AI 到底看没看过我的站?」
这个问题被问过太多次,而多数人查错了地方:他们去看 GA4、看站长后台、看后台访问统计,然后得出「AI 没来过」的结论。其实不是没来过,是你用的工具根本看不见它们。
AI 爬虫不执行 JavaScript,也不会跑统计脚本,所以前台的分析工具对它们是隐形的。真正可信的记录只有一个地方:服务器日志(或 Cloudflare、主机商提供的访问统计)。这篇文章教你查三件事——来过没有、来了哪几类、哪些页面被漏掉了。
为什么 GA4 和站长工具看不到 AI 爬虫?
原因很朴素:网页统计工具靠一小段 JavaScript 上报数据。AI 爬虫只取 HTML 源码,不执行脚本,自然不会在报告里留下痕迹。
能看见 AI 爬虫的地方有四个:
- 服务器访问日志(nginx 的 access.log、Apache 的 access_log)——最完整,能看到每一条请求
- Cloudflare——免费版就有机器人分类,能看到 AI 抓取趋势
- 主机面板的原始访问统计——cPanel 的 Raw Access、宝塔的网站日志
- Search Console 的抓取统计——只能看 Google 相关,看不到 OpenAI、Anthropic 的爬虫
换句话说:如果你只装了统计分析,你对 AI 爬虫的可见度就是零,这会让你在判断「该不该继续做 GEO」时失去最重要的证据。
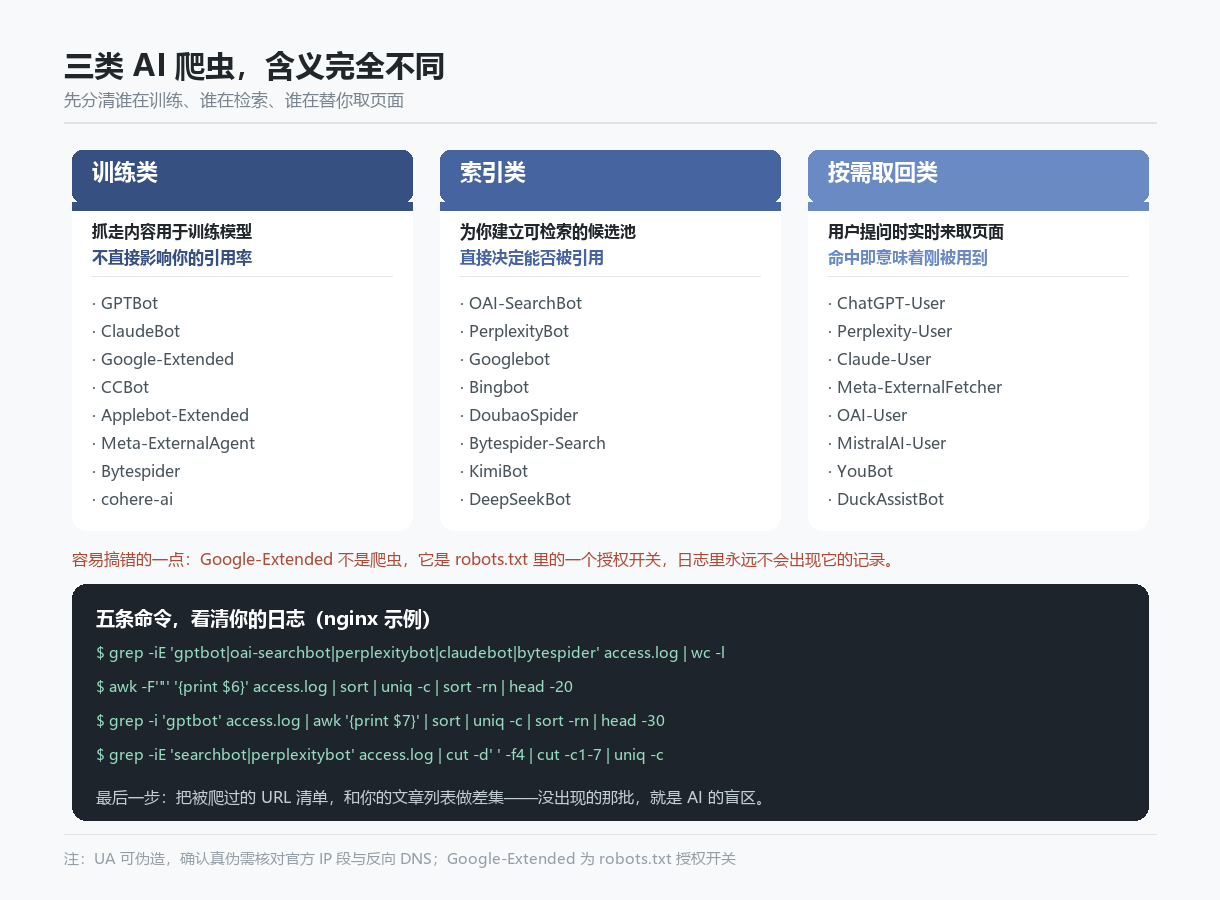
三类 AI 爬虫,含义完全不同
日志里看到爬虫名字就开始高兴,是最常见的误判。名字不同,意义差得很远。
| 类别 | 代表 UA | 它想干什么 | 对你的意义 |
|---|---|---|---|
| 训练类 | GPTBot、ClaudeBot、CCBot、Applebot-Extended | 把内容抓走用于训练模型 | 不直接影响引用率,主要影响内容被复用的方式 |
| 索引类 | OAI-SearchBot、PerplexityBot、DoubaoSpider、KimiBot | 为可检索池建立索引 | 最关键的一类:决定你能不能被引用 |
| 按需取回类 | ChatGPT-User、Perplexity-User、Claude-User | 用户提问时实时抓取页面 | 命中往往意味着这条内容刚被用来回答问题了 |
还要单独说一个高频误会:Google-Extended 不是爬虫,它是 robots.txt 里的一个授权开关,用来告诉 Google「我的内容可否用于其生成式产品」。它是 token,不是 UA,你在日志里翻到天亮也找不到它。
五条命令,把日志读明白
不需要任何工具,一台服务器加几条命令就够。下面是 nginx 日志的示例,把路径换成你自己的即可。
# 1. 最近有多少次 AI 爬虫访问

grep -iE 'gptbot|oai-searchbot|perplexitybot|claudebot|bytespider' access.log | wc -l

# 2. 按 UA 分类计数,看谁来得最勤

awk -F'"' '{print $6}' access.log | sort | uniq -c | sort -rn | head -20

# 3. 被爬得最多的 URL,就是 AI 眼里的重点页面

grep -i 'gptbot' access.log | awk '{print $7}' | sort | uniq -c | sort -rn | head -30

# 4. 检索类爬虫的每日趋势,判断覆盖是否在扩大

grep -iE 'searchbot|perplexitybot' access.log | cut -d' ' -f4 | cut -c1-7 | uniq -c
第四条命令尤其值得每周跑一次:趋势比绝对值重要。如果某天开始检索类爬虫的访问量突然归零,通常意味着三件事之一:你改了 robots.txt、站点改版导致链接结构变了、或者服务器开始拦截它们。
怎么确认自称 GPTBot 的,是真的?
UA 是可以随便写的,任何脚本都能假装自己是 GPTBot。判断真伪有两个动作:
- 反向 DNS 校验:官方爬虫的 IP 反查域名是可验证的,普通脚本反查不到,或者对不上声明的域名
- 核对官方 IP 段:主流厂商都会发布爬虫 IP 列表(如 OpenAI 提供 gptbot.json 这类接口),比对即可
如果不想自己写脚本,用 Cloudflare 的机器人分类或主机面板里的统计也能直观看到——它们已经帮你做了标注,比自己看原始日志省事得多。
一份四指标的体检报告
把日志里的事实变成四个数字,就能判断 GEO 执行到哪一步了。
| 指标 | 怎么算 | 看什么 |
|---|---|---|
| AI 爬虫占比 | AI 爬虫请求数 ÷ 总请求数 | 从零到有说明发现通路打开了 |
| 爬虫结构 | 三类爬虫各自的访问量 | 索引类为零 = 永远不会被引用 |
| 被抓 URL 分布 | 按 URL 聚合访问次数 | 首页占比过高说明内页没被有效抓取 |
| 零抓取 URL 清单 | 文章列表 − 被抓清单 | 这份清单就是你的 AI 盲区 |
行业公开统计里有一条很值得注意:约七成站点至少在 robots.txt 里误拦了一个 AI 爬虫。这也是为什么「体检」应该先做——很多站点并不是内容不行,而是门口就挂了谢客牌。
查完之后:允许、限制还是封禁
看清了谁来过,还要决定怎么对待它们。这不是「全放」或「全堵」的单选。
| 类别 | 建议策略 | 理由 |
|---|---|---|
| 索引类 | 放行 | 完全决定你能不能被引用,封掉等于放弃 GEO |
| 按需取回类 | 放行 | 用户提问时的实时取回,封掉会直接损失引用 |
| 训练类 | 按业务判断 | 不影响引用率,但对内容被复用的方式有影响,想保留议价能力可限制 |
| SEO 工具类 | 可限制 | SemrushBot、AhrefsBot 等不服务用户,只为采集数据 |
| 采集站类 | 建议封禁 | 纯搬运,只消耗带宽和内容价值 |
一个实操细节:如果你的日志里出现 ChatGPT-User 命中付费页或产品页,通常说明这条内容刚刚被用去回答某个具体问题了。这类命中记录下来,比任何第三方监测工具都准确——它是你自己的一手证据。
延伸阅读
常见问题
Q1:没有服务器权限,还能查 AI 爬虫吗?
可以。三条替代路径:Cloudflare 的机器人分析(免费版够用)、主机面板的原始访问统计、以及自己部署一个轻量的访问记录脚本。如果以上都没有,退而求其次的做法是用同一提示词重复提问,从结果反推。
Q2:日志里只有训练类爬虫,没有索引类,怎么办?
这是最典型的「被看了但没进池子」状态。优先做三件事:确认 robots.txt 没有拦索引类爬虫、提交站点地图、把新页面挂到已有流量的老页面上(内链)。索引类爬虫对链接结构的依赖远高于普通爬虫。
Q3:日志文件太大,全部统计一遍很慢怎么办?
只统计最近 7 到 14 天即可,没必要全量。可以先按日期切分(比如只保留上月日志),再把 grep 结果存成小文件,后续统计就很快了。GEO 体检看的是趋势,不是历史考古。
Q4:AI 爬虫来访频率变低了,是不是我做错了什么?
先排查三个可能:robots.txt 是否被改动、站点是否做过改版导致 URL 结构变化、服务器或 CDN 是否新增了拦截规则。如果这三项都没有变化,那通常只是抓取调度周期的正常波动,观察两周再判断。
做 GEO 最怕的不是慢,而是不知道自己走到哪了。日志体检的价值就在于:它把「AI 到底有没有在看我」这件玄学,变成了一份可以按周对比的数字报表。
先确认门口没人拦,再谈内容写得好不好。
今天可以做的一步:打开服务器日志,搜一次 gptbot,看看你的站有没有被访问过。