一位做工业配件的客户,上周发来一段对话截图。他在自己电脑上问 AI「工业轴承供应商哪家靠谱」,答案里没有他。他不信,又问了两次,还是没有。
同一天下午,他的一个老客户在微信上跟他说:「我在 AI 里搜你们的品类,第一条就有你们啊。」还把截图发过来了——答案里确实有他,排在第二。
两个人问的是同一句话。一个看得到,一个看不到。
这不是谁在说谎,也不是 AI 坏了。这是 2026 年 GEO 最容易被忽略的一层变化:答案已经不是一份了,是一人一份。
一、答案已经一人一份
今年 8 月有一份研究,拿 211 组同一个提问,分别问 ChatGPT、Google AI Mode 和 Copilot,只看「第一个被点名的品牌」是不是同一个:
63.5% 的提问,三个引擎给出的答案不一样。
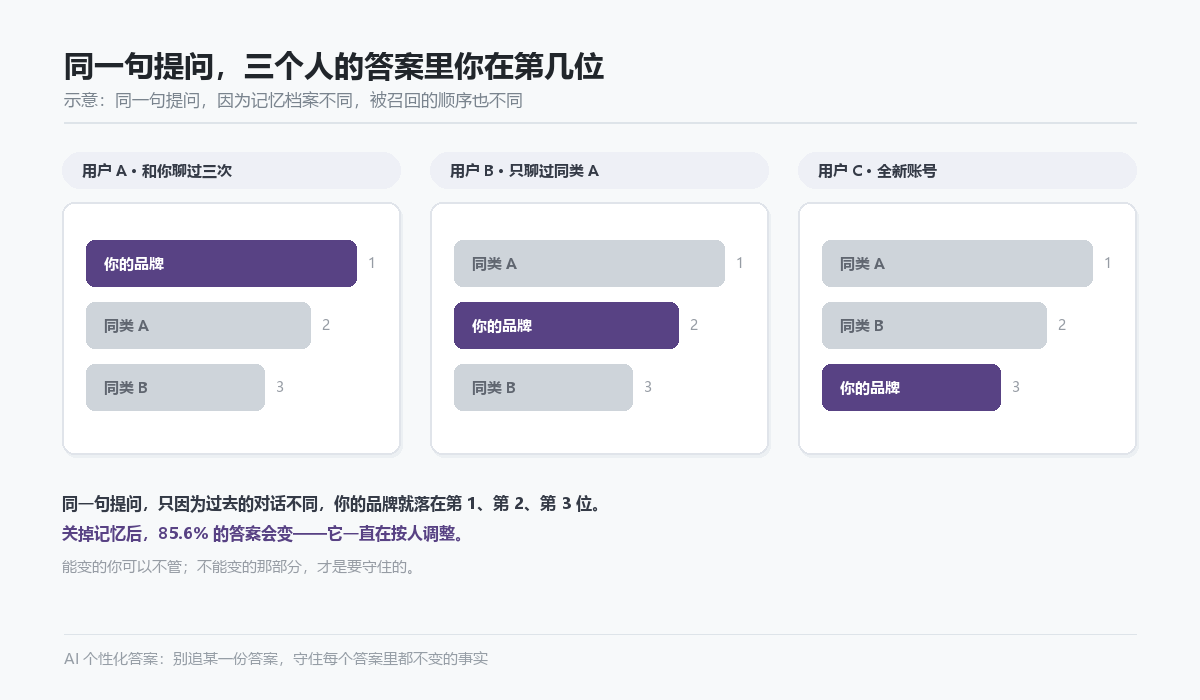
更值得注意的是同一个研究里的另一组数:把 ChatGPT 的个性化记忆关掉再问一遍,85.6% 的答案会变。
也就是说,大部分答案里都有「你这个人」的成分。你问过什么、点过什么、以前聊过哪几家,都在参与决定这一次谁被点到名。
二、四层机制,最后一层最容易被忽略
个性化不是一个开关,是四层叠在一起:
- 第一层·你告诉它的:自定义指令、填写的职业与公司(Perplexity 直接让你填)。
- 第二层·它自己总结的:ChatGPT 今年 6 月起改了记忆架构,不再存一条条事实,而是在后台跨对话综合成一份「记忆摘要」,还会随时间长进(你计划中的旅行会变成「去过」)。
- 第三层·它从别的应用读到的:Google 的「个人智能」可以跨邮箱、相册、搜索记录、视频观看历史推理。
- 第四层·它决定要不要联网:这一层几乎没人提。模型会自己判断这个问题需不需要现搜。今年 4 月的数据是,只有约 34.5% 的查询真的触发了联网。
第四层是关键:不联网的那六成多,答案完全来自训练数据和记忆。也就是说,一部分客户的答案里,压根没有「今天你的官网写了什么」这件事——无论是好是坏。
三、为什么「优化那一个答案」会失效
过去两年大家做 GEO 有一个隐含前提:同一个问题,所有人看到的大差不差,所以只要把「那个答案」优化好就行。现在这个前提不成立了。
| 常见做法 | 为什么在个性化下失效 | 该换成什么 |
|---|---|---|
| 盯住品类词的第一名 | 第一名是「某个人的」第一名,不是所有人的 | 盯「品牌被认成谁」——这个名字在几个引擎里是不是同一个 |
| 做一份标准问答页就等收录 | 同一页会被不同记忆档案筛掉或提上来 | 把事实做成可核验的字段,让任何一份答案摘走都成立 |
| 只看自己账号的可见度报告 | 那份报告测的是你自己的历史 | 多账号、关记忆、多次跑,看区间而不是看结论 |
四、那还能优化什么:三件不受个性化影响的事
个性化改变的是「谁被优先召回」,改不了三件事:
- 能不能被认出来:不管读谁的历史,模型第一步都要把「你」解析成一个实体。官网、百科、行业站、地图上的名称和定位不一致,它就会在候选池里分成两三个「你」,每一个都只有一部分证据。
- 读到的事实对不对:这条最实在。研究里有个细节——一家早就停用的电力公司,仍有34.8% 的答案在点名它。过时的第三方数据会被一直引用下去,而且看起来毫无破绽。
- 第一次被提及时说得对不对:没有历史的用户拿到的是「默认版」答案,这一次会写进他的记忆档案,影响后面每一次。第一次被说错,后面要修很多次。
五、反直觉:答案越个性化,可核验越值钱
个性化本来应该让人更信任 AI——它更懂你了。但调研结果相反:
只有约 10% 的用户信任第一条 AI 结果,48% 会跨平台再验证一遍,而 62% 的人表示:引用的来源带链接时,他们更愿意信。
还有一条我很喜欢的数据:收到 AI 推荐、并且原本没用过这个品牌的人,一周内在 Google 搜索这个品牌的概率高 182%。
这条数据把两件事接上了——AI 的答案出短名单,Google 的搜索做审计。客户在 AI 里看到你,转头就去搜你的品牌名;如果那时候搜出来的结果很薄、评价很杂、信息很旧,这单就死在他自己手里,你的销售根本不会知道有这个人。
所以 GEO 和 SEO 在这里不是二选一。AI 负责让人认识你,搜索负责让人确认你。前者是你的内容被不被摘,后者是你的品牌名搜出来干不干净。
六、怎么自己测:四个动作
- 用临时会话跑一遍,去掉记忆这一层;
- 用一个全新账号再跑,看「默认版」答案里有没有你;
- 换设备和网络跑第三次,排除位置和缓存的影响;
- 把三次结果并排记下来,标注哪几句是共有的——那些共有的句子,才是你真正能守住的资产。
注意:三次都不出现,说明是内容问题;三次都出现但说法不同,说明是实体问题;只有你自己的账号能看到,说明你测的是自己。
七、五个容易搞错的地方
| 常听到的说法 | 实际情况 |
|---|---|
| 「关掉记忆就能看到干净答案」 | 只跳过最深那一层;账号、位置、语言、订阅档、模型版本、A/B 分组都还在 |
| 「个性化是给消费者的,B2B 不受影响」 | 恰恰相反——B2B 的对话更长,公司规模、预算、已排除的选项全都进了上下文 |
| 「AI 报出来的品牌信息都是对的」 | 研究里那家停用品牌的例子说明:过时数据会一直被引用,而且毫无破绽 |
| 「被 AI 提到就会带来流量」 | 答案只是短名单;真正的转化在客户转头去搜你品牌名的那一步 |
| 「多平台分发就能覆盖差异」 | 1,800 万条引用里,只有约 11% 的域名同时被两个引擎引用 |
常见问题
我们怎么知道客户那边看到的和我不一样
三个动作就够了:用临时会话跑一遍、换一个全新账号再跑一遍、再换一台设备和网络跑一遍。三次结果摆在一起,差多少一目了然。别用自己天天问的那个账号当唯一依据——它带着你最厚的一层历史。
关掉记忆测出来的就是「真实」答案吗
不是。临时会话只跳过记忆这一层,账号、IP 位置、语言、订阅档、模型版本、甚至你在 A/B 分组里的位置都还在。它比开着记忆干净,但不等于陌生人的视角。
个性化会不会让 GEO 完全没法做
反而更清楚该做什么。你控制不了模型读谁的历史,但你能控制两件事:它认不认得出你是谁(全站全网实体一致)、以及它读到的关于你的事实是不是真的(可核验)。这两件事恰好是唯一的共同分母。
我们是 B2B,客户第一次接触我们时 AI 会说什么
那恰恰是最该测的一次。没有历史的时候,答案更接近公共语料的默认——也就是大品牌和媒体口径更占优。所以「第一次被提到时说的是对的」在 B2B 里更值钱,因为那一次会被记住、并在后续对话里反复加权。
延伸阅读
你没法决定 AI 读的是谁的历史,但你能决定它读到的你,是不是同一个你。