有位站长上周翻了服务器日志,越看越不对劲:GPTBot、ClaudeBot、PerplexityBot 轮着来,一天好几百次请求。可他让同事去 AI 里搜了十个行业问题,公司名一次都没出现。
爬虫明明来过,内容也没少写,为什么一点动静都没有?因为他卡在了抓取层——爬虫进得来,不代表读得到;读得到,不代表算数。
10 月这轮变化:AI 悄悄把你网站的「入口」分了类
过去几个月,各大引擎陆续把官网文档里的爬虫说明写清楚了一件事:AI 爬虫不是一个,而是三种,各干各的活。
同时还有两个变化值得注意。一是 CDN 层开始替你做决定:有厂商从 9 月起对新接入的站点,默认屏蔽掉「混合用途」的爬虫,而且这个默认值会覆盖你自己的放行设置。二是抓取量已经不小了——有第三方统计把 AI 相关爬虫算到了验证机器人流量的四分之一左右。
换句话说:入口规则已经从「技术细节」变成了「可见性开关」。
三种爬虫,挡错一种的代价差得很远
| 爬虫 | 它负责什么 | 挡住它的代价 |
|---|---|---|
| GPTBot(OpenAI·训练) | 收集材料,训练以后的模型 | 未来的模型认识你少一点,今天不影响 |
| OAI-SearchBot(OpenAI·检索) | 建 ChatGPT 搜索用的索引 | 从 ChatGPT 的答案里消失 |
| ChatGPT-User(OpenAI·实时) | 用户提问时当场打开你的页面 | ChatGPT 打不开你的页面 |
| ClaudeBot / Claude-SearchBot | 前一个做训练,后一个做检索 | 训练可挡,检索别挡 |
| PerplexityBot(Perplexity·检索) | 建 Perplexity 的检索索引 | 从 Perplexity 的引用里消失 |
| Google-Extended(Google·训练开关) | 控制是否用于 Gemini 训练 | 不影响搜索,也不影响 AI 摘要 |
看这张表只要记住一条:训练爬虫可以挡,检索爬虫挡了就是退出。很多人图省事写一句「User-agent: * Disallow: /ai」,结果把 OpenAI 的检索爬虫也一起挡在外面,自己还不知道。
比 robots.txt 更隐蔽的:四件常被忽略的事
| 你以为这样做没问题 | 实际付出的代价 |
|---|---|
| 一句通配把「带 AI 字样」的爬虫全挡了 | 名字里带 AI 的不都是同一类,检索爬虫被误伤最常见 |
| CDN 里的「屏蔽 AI 爬虫」开关开着不管 | 它优先级高于 robots.txt,而且常常是默认开启的 |
| 只靠 llms.txt 引导,不做 robots 管理 | 没有引擎确认会读它,真正有约束力的是 robots.txt |
| 页面正文靠 JavaScript 渲染 | 主流 AI 爬虫不执行脚本,抓到的正文是空的 |
| 抓取量看着很大,就当没问题 | 抓取量和引用量是两回事,比例失衡等于白抓 |
从爬虫到你被引用,要过三道闸门
把这三道闸门按顺序检查一遍,比反复改标题有用得多:
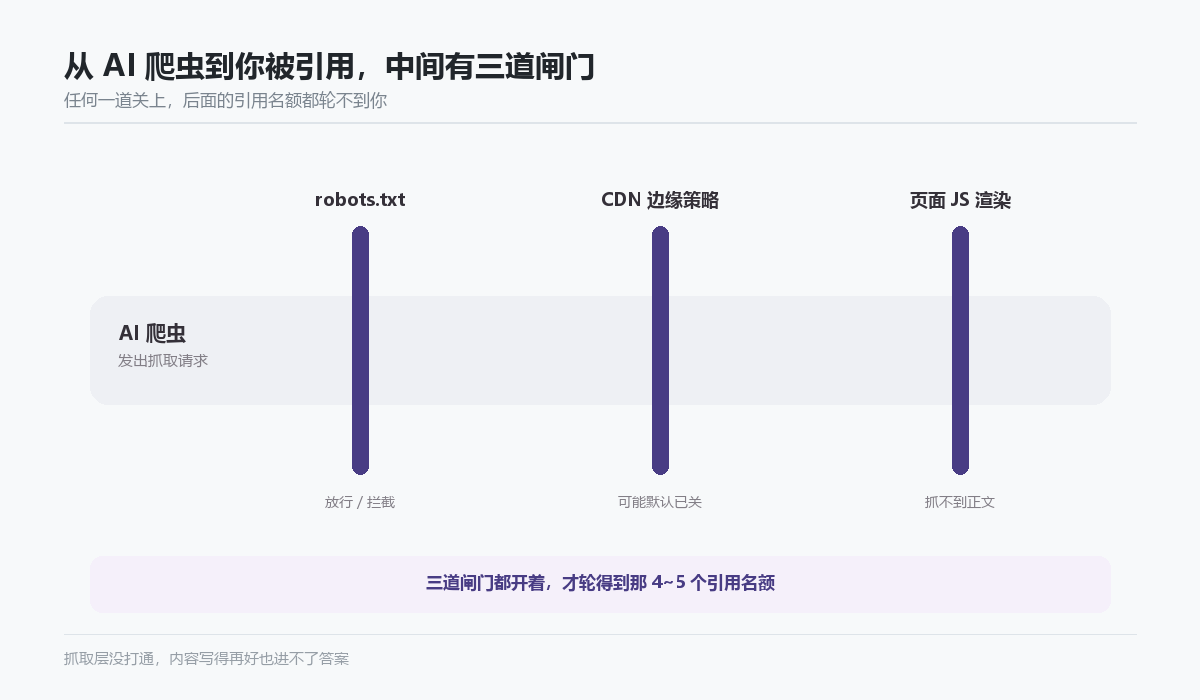
第一道,robots.txt:检索类爬虫必须放行。第二道,CDN 与边缘策略:默认开关经常替你把门关上了。第三道,页面渲染方式:正文必须出现在最初的 HTML 里。三道都开着,你的内容才进得了候选池——注意,只是候选。
国内这边,规则也在往同一个方向走
国内平台这半年同样在收紧抓取标准,方向基本一致:
- 实时信源抓取:豆包今年开放了联网实时抓取,长期不更新的页面优先级明显下降,「写完就不管」的旧内容越来越吃亏。
- 信源分级:官方机构与央媒在最上层,企业官网与正规行业平台其次,普通站点再次,低质搬运和违规营销直接限制抓取。
- 结构化优先:层级清晰、排版规整、关键信息明确的内容优先抓,关键词堆砌的页面会被降低抓取频次。
- 主体交叉核验:全网比对账号主体与品牌资料,信息互相打架的站点会被标记为不可信信源,直接限制收录。
十分钟自查清单
- 打开自己网站的 robots.txt,逐个确认检索类爬虫是 Allow,不是 Disallow;
- 登录 CDN 或安全产品的控制台,看「AI 爬虫」相关开关是不是默认拦截;
- 在服务器日志里搜几个爬虫名,确认它们确实来过(没来过说明被挡在更前面);
- 用浏览器禁用 JavaScript 打开一篇文章,正文还在 = 抓取层过关;
- 把 llms.txt 当作指路牌维护,但别指望它替代 robots.txt;
- 每季度复查一次:新爬虫会出现,一个插件更新也可能悄悄改掉你的规则。
常见问题
在 robots.txt 里挡住 GPTBot,会影响 Google 排名吗
不会。GPTBot、ClaudeBot、CCBot 这些和 Googlebot、Baiduspider 是各自独立的爬虫,互不影响排名。挡训练爬虫的代价是「以后的模型认识你少一点」,不是今天掉排名。
我们开了 CDN 的「屏蔽 AI 爬虫」,还需要看 robots.txt 吗
需要。CDN 的策略优先级更高,会覆盖 robots.txt 里的放行;而且这类开关常常是默认打开的。两边都过一遍,确认检索类爬虫(OAI-SearchBot、PerplexityBot、Claude-SearchBot 这类)没有被误挡。
网站是前端框架渲染的,会有影响吗
会有。多项针对 AI 爬虫的抓取分析都指向同一个结论:主流 AI 爬虫基本不执行 JavaScript。正文如果只在浏览器里渲染出来,它们抓到的就是一个空壳。把正文做成服务端直出的 HTML 最稳。
llms.txt 到底要不要做
可以做,但别把它当门票。目前没有主流引擎确认会读这个文件,真正有约束力的还是 robots.txt。两者不冲突:用 robots.txt 管放行,用 llms.txt 给重点页面指路。
延伸阅读
爬虫来不来是它能决定的事,让它进来之后读到什么,才是你能决定的事。