你做 GEO 最容易犯的第一个错,是”渠道思维”——小红书、知乎、公众号、百家号全铺一遍,期望”总有一个平台被 AI 抓走”。16800 次量级实测数据(统计方自述口径)显示,这么做是低效的:六个引擎吃的内容结构和信源池完全不同,一套内容通发,六个平台各覆盖不到三分之一。正确顺序是先定”你要打哪个引擎”,再倒推”该铺哪个渠道、用什么结构写”。
一、渠道优先级的第一性原则:先看引擎”吃什么”
GEO 服务商实测里反复出现的一个决策动作叫”看模型下菜”——不是”哪个平台流量大就铺哪个”,而是”目标引擎偏好哪个信源生态、哪种内容结构,你就往那个生态发、用那个结构写”。这是把渠道选择从”经验判断”变成”按引擎倒推”。
倒推三步:
一、定目标引擎。你的客户在哪问 AI?本地生活场景 → 豆包为主;品牌叙事/种草 → 元宝;技术决策/百科 → 文心/DeepSeek。不同业务重心对应的主打引擎不一样。
二、查该引擎的信源结构占比。决定把你的内容铺到哪个生态(字节系/微信系/百度系/搜狐网易系)。
三、定内容结构。同一主题给不同引擎写不同版本:豆包版用 FAQ+列表,文心版首段下定义,通义版用表格,DeepSeek 版放参数表。
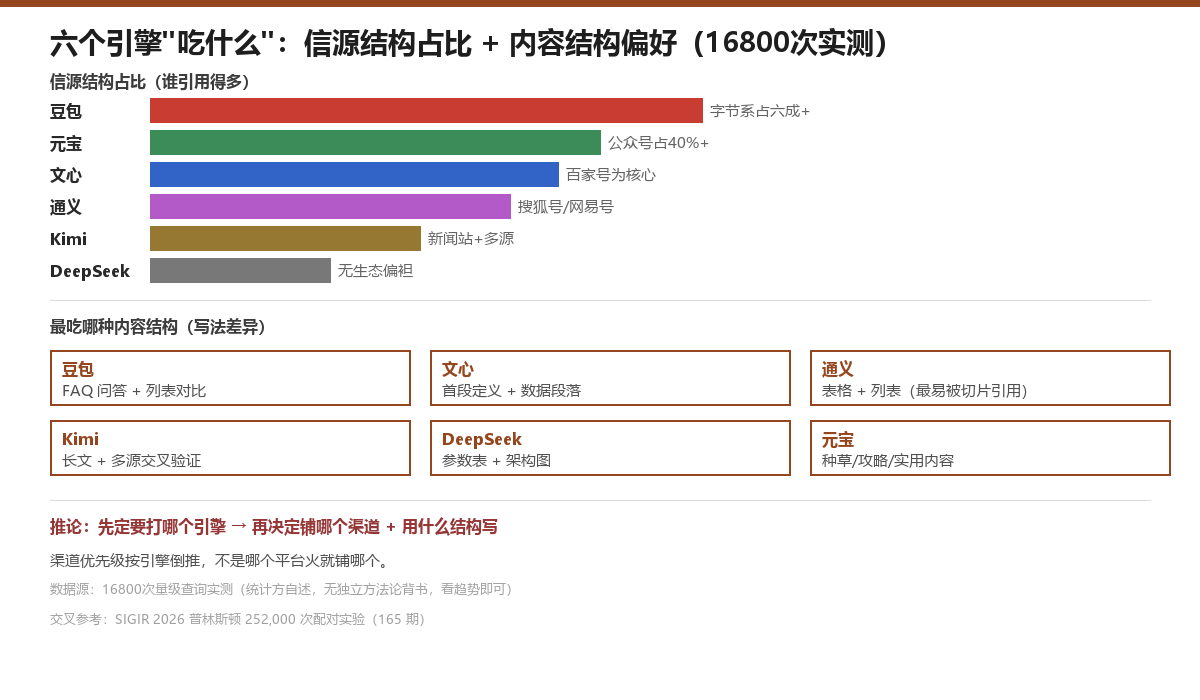
二、六个引擎”吃什么”:信源结构占比 + 内容结构偏好
| 引擎 | 信源结构占比(谁引用得多) | 最吃的内容结构 | 渠道倒推 |
|---|---|---|---|
| 豆包 | 字节系占六成以上 | FAQ 问答 + 列表对比 | 铺抖音/今日头条,写 FAQ+列表 |
| 腾讯元宝 | 微信公众号占 40% 以上 | 种草/攻略/实用内容 | 铺公众号/视频号 |
| 文心一言 | 百家号为核心 | 首段定义 + 数据段落 | 铺百家号,开头一句话定义主题 |
| 通义千问 | 搜狐号/网易号偏重 | 表格 + 列表(最易被切片引用) | 铺搜狐号/网易号,多放表格 |
| Kimi | 新闻站点 + 多源验证 | 长文 + 交叉印证 | 铺行业媒体,多源互证 |
| DeepSeek | 无平台生态偏袒 | 参数表 + 架构图 | CSDN/博客园,放参数表 |
几个反直觉点:一,通义的”表格+列表最易被切片引用”——AI 组织答案时会把表格里的一行直接摘出来当”证据”,通义对结构化表格的采纳率显著高于散文;二,文心偏好”首段定义”——文心高频引用的是”第一段就把 XX 是什么讲清楚”的百科式写法,纯故事开头它很少引;三,DeepSeek 没有生态偏袒,它最吃的是”参数表+架构图”这种硬技术内容,和 165 期讲的”单测低估 DeepSeek”配合看:DeepSeek 是技术型品牌最该重点打的引擎。
三、为什么”一套内容通发”是低效的
把渠道占比数据摆在一起看,就明白为什么通发低效了:豆包六成引用来自字节系,但它的 FAQ 结构偏好,要求你的内容是问答体;文心吃百家号”首段定义”,同一条内容如果你按 FAQ 写,文心几乎不会引;通义吃表格,你一段散文它只被摘走一句话甚至完全不采信。
这就是为什么 158 期讲”六个平台六种口味”是定性矩阵,本篇进一步把它量化成”占比 + 结构”两个可操作维度,让你能倒推渠道。
FAQ
Q:16800 次实测,数据可信度如何?
A:统计方自述口径,无独立方法论背书,看趋势即可——它给的各引擎占比和结构偏好,方向和”自家生态就是信源护城河”(165 期 GitHub 实测文心 12/12、豆包引抖音 9/12)一致,结论可交叉印证,具体数值不必当成精确值。
Q:我只有一个内容团队,没资源给六个引擎各写一版,怎么办?
A:先按业务重心选 1~2 个主打引擎(客户在哪问 AI 就在哪),把 80% 资源压在这 1~2 个引擎的信源生态和内容结构上,其余引擎低成本维持。全平台撒网是小团队最大的浪费。
Q:”看模型下菜”和 165 期的 MMR 同质降权,怎么配合?
A:165 期说”同质内容会被 MMR 主动降权”,本篇说”不同引擎要不同结构”——合起来就是:在主打引擎里,你不仅要比竞品结构更贴(FAQ/表格/参数表),还要和竞品说法有差异(方法论/数据/角度不同),两者叠加才既能进候选池又能在重排时不被多样性机制压下去。
Q:内容结构偏好会不会经常变?
A:会。159 期讲过”AI 的答案是流动的”,引擎的内容偏好一个季度内调整数次很常见。本篇数据是 2026 年的快照,做月度复测时把”主打引擎当前偏好哪种结构”纳入巡检项,发现漂移就换写法。
延伸阅读
- 你和竞品写的一样,AI 只会引用一个——MMR 同质降权(165 期)
- 六个平台六种”口味”:一次生产,多端适配,怎么落?——跨平台口味定性矩阵(158 期)
- AI 的答案是流动的:GEO 没有”做完”,只有”复测”——月度复测(159 期)
渠道不是”哪个火铺哪个”,是”目标引擎吃什么”。 先定引擎,再铺渠道。
{
“@context”: “https://schema.org”,
“graph”: [
{
“@type”: “Organization”,
“@id”: “https://www.geoshizhan.com/#org”,
“name”: “GEO实战”,
“url”: “https://www.geoshizhan.com/”
},
{
“@type”: “WebSite”,
“@id”: “https://www.geoshizhan.com/#website”,
“url”: “https://www.geoshizhan.com/”,
“publisher”: {
“@id”: “https://www.geoshizhan.com/#org”
}
},
{
“@type”: “Article”,
“headline”: “先别铺渠道,看你要打哪个引擎\”吃什么\””,
“description”: “铺渠道前,先定你要打哪个引擎。16800次实测:豆包六成引用来自字节系,元宝四成来自公众号,文心吃百家号\”首段定义\”,通义把表格列表切走,DeepSeek没有生态偏袒只认参数表。六个引擎\”吃什么\”不一样,渠道优先级要按引擎倒推,不是哪个平台火就铺哪个。”,
“datePublished”: “2026-11-06”,
“dateModified”: “2026-11-06”,
“author”: {
“@type”: “Organization”,
“name”: “GEO实战”
},
“publisher”: {
“@id”: “https://www.geoshizhan.com/#org”
},
“image”: “https://www.geoshizhan.com/wp-content/uploads/2026/11/geo_166_cover.png”,
“mainEntityOfPage”: “https://www.geoshizhan.com/geo-pick-channel-by-engine-taste-2026/”,
“isPartOf”: {
“@id”: “https://www.geoshizhan.com/#website”
}
},
{
“@type”: “FAQPage”,
“mainEntity”: [
{
“@type”: “Question”,
“name”: “16800 次实测,数据可信度如何?”,
“acceptedAnswer”: {
“@type”: “Answer”,
“text”: “统计方自述口径,无独立方法论背书,看趋势即可——各引擎占比和结构偏好方向与 165 期 GitHub 实测(文心 12/12、豆包引抖音 9/12)一致,结论可交叉印证,具体数值不必当精确值。”
}
},
{
“@type”: “Question”,
“name”: “只有一个内容团队,没资源给六个引擎各写一版怎么办?”,
“acceptedAnswer”: {
“@type”: “Answer”,
“text”: “先按业务重心选 1~2 个主打引擎(客户在哪问 AI 就在哪),把 80% 资源压在这 1~2 个引擎的信源生态和内容结构上,其余低成本维持。全平台撒网是小团队最大浪费。”
}
},
{
“@type”: “Question”,
“name”: “\”看模型下菜\”和 165 期 MMR 同质降权怎么配合?”,
“acceptedAnswer”: {
“@type”: “Answer”,
“text”: “165 期说\”同质内容被 MMR 主动降权\”,本篇说\”不同引擎要不同结构\”——合起来:主打引擎里,你不仅结构要比竞品更贴(FAQ/表格/参数表),说法还要有差异(方法论/数据/角度),两者叠加才既进候选池又不被多样性机制压下去。”
}
},
{
“@type”: “Question”,
“name”: “内容结构偏好会不会经常变?”,
“acceptedAnswer”: {
“@type”: “Answer”,
“text”: “会。159 期讲过\”AI 的答案是流动的\”,引擎偏好一个季度内调整数次很常见。本篇数据是 2026 年快照,做月度复测时把\”主打引擎当前偏好哪种结构\”纳入巡检项,发现漂移就换写法。”
}
}
]
}
]
}