两个内容团队做 GEO,选题一样、数据一样、结论一样,都发在了同一个平台。三个月后一个进 AI 引用第一梯队,另一个几乎不被引用。团队以为差在”写得不好”——其实差在大模型重排阶段的多样性机制。这是大多数 GEO 人没听过的底层规则。
一、MMR 多样性重排:你和竞品写一样,AI 只引一个
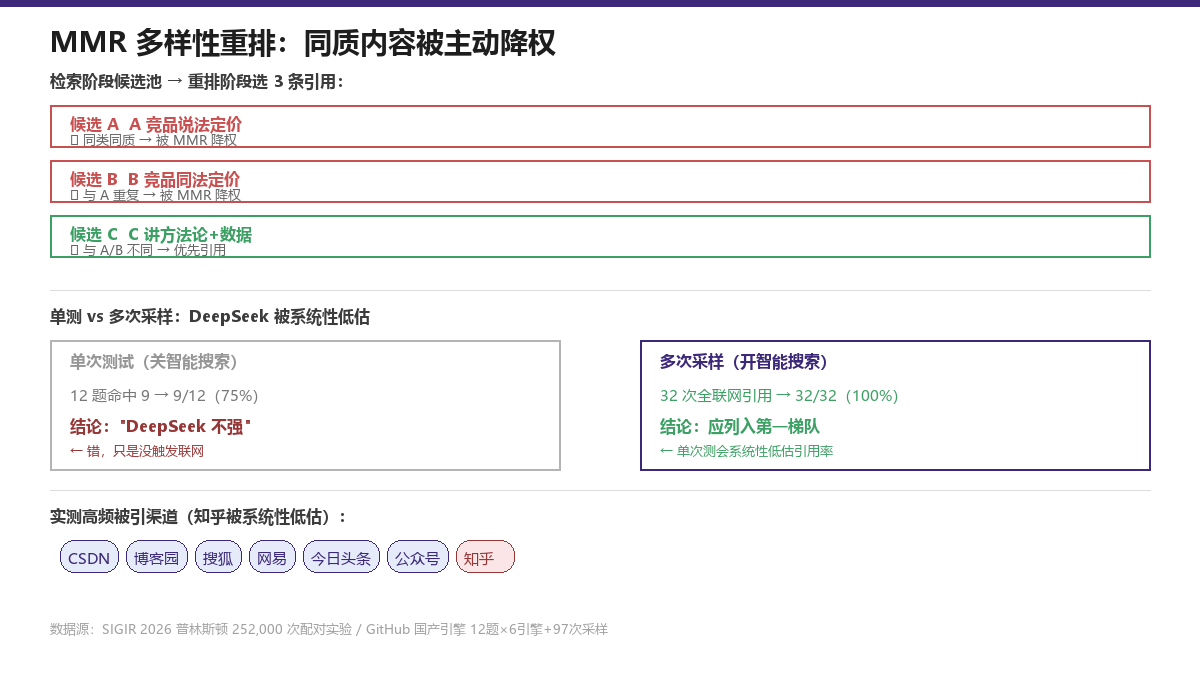
普林斯顿团队在 SIGIR 2026 做了 252,000 次配对实验,发现大模型在生成答案时,检索阶段拿到候选池后,重排阶段会跑 MMR(最大边际相关性)算法——主动追求多样性:如果前两条引用都在讲同一个说法,第三条会优先选讲另一家、或者讲方法论的内容。
翻译成人话:你跟竞品写得一模一样,AI 不会两个都要,它会把同质内容主动压下去,把”差异化说法”顶上来。这是算法层面的惩罚,不是你写得好不好。
三个实操推论:
一、同质内容 = 负优化。你和 5 家竞品都用同一套 SOP 模板,AI 只会引用其中一家,其余被 MMR 压下去。
二、差异化 > 堆量。与其铺 10 篇同质内容,不如 3 篇讲不同角度(方法论/数据/案例)。
三、同质化监测要进月度巡检。竞品和你写一样的内容越来越多时,引用率会被系统性稀释。
二、四道”守门人”:被 MMR 挑之前,先过这几关
252,000 次实验还总结出大模型一致认可的四个”守门人”——内容不先过这四关,连被 MMR 多样性挑选的资格都没有:
| 守门人 | 机制 | 不过关的后果 |
|---|---|---|
| ① 话题匹配度 | 内容是否正面回答这个问题 | 不匹配直接淘汰,后面再好也没用 |
| ② 硬信息密度 | 有无具体价格/参数/数据 | 缺硬信息引用概率大幅下降 |
| ③ 时效性 | 有无近期更新时间戳 | 内容太旧或没时间戳 → 显著降权 |
| ④ 候选位置 | 在检索候选池里排第几 | 排得越靠后,被引用概率指数级下降 |
其中④最反直觉——候选池位置是被引用概率的指数级变量。你在候选池第 8 位和第 2 位,被 MMR 引用的概率差一个数量级。这也是为什么”进候选池”比”在候选池里排得靠前”更稀缺(见 164 期”召回”段)。
三、单次测引用率会系统性低估:DeepSeek 被冤枉的案例
另一条来自实测研究(GitHub 开源,12 题×6 引擎+97 次多次采样)的反直觉发现:DeepSeek 单次测试看着”引用率一般”(9/12),但开启智能搜索后多次采样 32/32 全部联网引用(100%)。单次结果只是”那一次没触发联网”,不代表它不强。
这直接打脸”GEO 行业把 DeepSeek 列为不强引擎”的流行判断。和 24950「查一次为什么不算数」相关但独立——本篇的量化结论是:单次测引用率会系统性低估,至少连测 3 次以上取稳定值再下判断。
| 引擎 | 单次引用率(12题) | 多次采样(32次) | 实测结论 |
|---|---|---|---|
| 文心一言 | 12/12(100%) | — | 每题必引,第一梯队 |
| 通义千问 | 10/12(83%) | — | 第一梯队 |
| 腾讯元宝 | 10/12(83%) | — | 引用 48 次集中在微信公众号 |
| 豆包 | 9/12(75%) | — | 9/12 题引抖音、7/12 题引头条 |
| DeepSeek | 9/12(75%) | 32/32(100%) | 单测被低估,实为第一梯队 |
| Kimi | 3/12 外链(25%) | — | 9 题纯模型作答,外链很难影响它 |
四、被高频引用的渠道,和你以为的不一样
同份实测研究里最容易被误读的一条:知乎不是主要被引来源。实测中知乎几乎只在文心引用里零星出现,真正高频被引的是 CSDN、博客园、搜狐、网易、今日头条、公众号。”做 GEO 一定要堆知乎”是行业流传很广的旧认知,实测数据不支持。
渠道优先级按实测调:
技术类内容 → CSDN/博客园(DeepSeek 主要抓这里)
品牌叙事类 → 公众号(元宝 48 次引用占其全部 1/3)
本地生活/场景化 → 今日头条(豆包 7/12 题引头条)
百科背书类 → 百家号+百度百科(文心高频引百度系)
知乎 → 不是主信源,按需布局
FAQ
Q:MMR 多样性重排,和 25018「信息增益从 4 到 15」什么关系?
A:25018 讲”内容要带来新信息,否则被判定为没有增益”,是内容层的信息量门槛。本篇讲的是重排阶段的多样性惩罚——即便你有增益,同质化写法也会被 MMR 压下去。两个机制叠加。
Q:单次测 DeepSeek 9/12,多次 32/32,我该信哪个?
A:信多次采样。单次会系统性低估(可能只是那一次没触发联网),多次采样取稳定值。和 159 期”月度复测”配合用:月度复测要测 3 次以上,不要单次下结论。
Q:知乎为什么不是主信源?
A:实测里知乎在文心才零星出现,其它引擎几乎不引。知乎内容偏 UGC 问答,AI 引用”结论性”内容更倾向 CSDN/博客园(技术权威感)和公众号(品牌叙事感)。知乎按需做,不必重仓。
Q:同质化监测怎么做?
A:月度巡检加一项”竞品同质度”——抓主要竞品 3 个月内的选题/结构/数据点,和你重叠度 > 50% 就要警惕。被 MMR 稀释的风险和重叠度正相关。
延伸阅读
- GEO 到底多久见效?先把收录、召回、采信、推荐四段拆开看——见效周期(164 期)
- AI 的答案是流动的:GEO 没有”做完”,只有”复测”——月度复测(159 期)
- 六个平台六种”口味”:一次生产,多端适配,怎么落?——跨平台口味(158 期)
你以为 GEO 是”写得更好”,其实是”写得不同”。 同质化内容在 MMR 眼里就是噪声。
{
“@context”: “https://schema.org”,
“graph”: [
{
“@type”: “Organization”,
“@id”: “https://www.geoshizhan.com/#org”,
“name”: “GEO实战”,
“url”: “https://www.geoshizhan.com/”
},
{
“@type”: “WebSite”,
“@id”: “https://www.geoshizhan.com/#website”,
“url”: “https://www.geoshizhan.com/”,
“publisher”: {
“@id”: “https://www.geoshizhan.com/#org”
}
},
{
“@type”: “Article”,
“headline”: “你和竞品写的一样,AI 只会引用一个”,
“description”: “SIGIR 2026 普林斯顿团队 252,000 次配对实验:大模型重排阶段用 MMR 主动追求多样性,前两条引用同一个说法,第三条优先选讲另一家的。你和竞品写一样的内容,AI 不会两个都引,只会引一个。本篇讲清这个\”同质降权\”机制,加四个守门人(话题匹配/硬信息/时效性/候选位置),再附单次测引用率系统性低估的避坑。”,
“datePublished”: “2026-11-05”,
“dateModified”: “2026-11-05”,
“author”: {
“@type”: “Organization”,
“name”: “GEO实战”
},
“publisher”: {
“@id”: “https://www.geoshizhan.com/#org”
},
“image”: “https://www.geoshizhan.com/wp-content/uploads/2026/11/geo_165_cover.png”,
“mainEntityOfPage”: “https://www.geoshizhan.com/geo-mmr-diversity-rerank-2026/”,
“isPartOf”: {
“@id”: “https://www.geoshizhan.com/#website”
}
},
{
“@type”: “FAQPage”,
“mainEntity”: [
{
“@type”: “Question”,
“name”: “MMR 多样性重排,和 25018 信息增益什么关系?”,
“acceptedAnswer”: {
“@type”: “Answer”,
“text”: “25018 讲\”内容要带来新信息,否则被判没有增益\”,是内容层信息量门槛。本篇讲重排阶段多样性惩罚——即便有增益,同质化写法也会被 MMR 压下去。两个机制叠加。”
}
},
{
“@type”: “Question”,
“name”: “单次测 DeepSeek 9/12,多次 32/32,该信哪个?”,
“acceptedAnswer”: {
“@type”: “Answer”,
“text”: “信多次采样。单次会系统性低估(可能那次没触发联网),多次取稳定值。和 159 期月度复测配合:月度复测至少 3 次,别单次下结论。”
}
},
{
“@type”: “Question”,
“name”: “知乎为什么不是主信源?”,
“acceptedAnswer”: {
“@type”: “Answer”,
“text”: “实测里知乎在文心才零星出现,其它引擎几乎不引。知乎内容偏 UGC 问答,AI 引用结论性内容更倾向 CSDN/博客园(技术权威感)和公众号(品牌叙事感)。知乎按需做,不必重仓。”
}
},
{
“@type”: “Question”,
“name”: “同质化监测怎么做?”,
“acceptedAnswer”: {
“@type”: “Answer”,
“text”: “月度巡检加一项\”竞品同质度\”——抓主要竞品近 3 个月选题/结构/数据点,和你重叠度 > 50% 就警惕。被 MMR 稀释的风险和重叠度正相关。”
}
}
]
}
]
}