把 11 月 10 日到 13 日这四天发生的事摆在一起,一开始看不出关联:OpenAI 开放了 ChatGPT 商家中心,Google 把 Gemini 4 Hydrogen 换成了 AI Mode 默认模型,DeepSeek 把 App 里的能力整套拆成 API,QuestMobile 的报告说豆包和 Kimi 正在往两个方向走。四家、四个部门、四种产品形态,像是四条平行线。
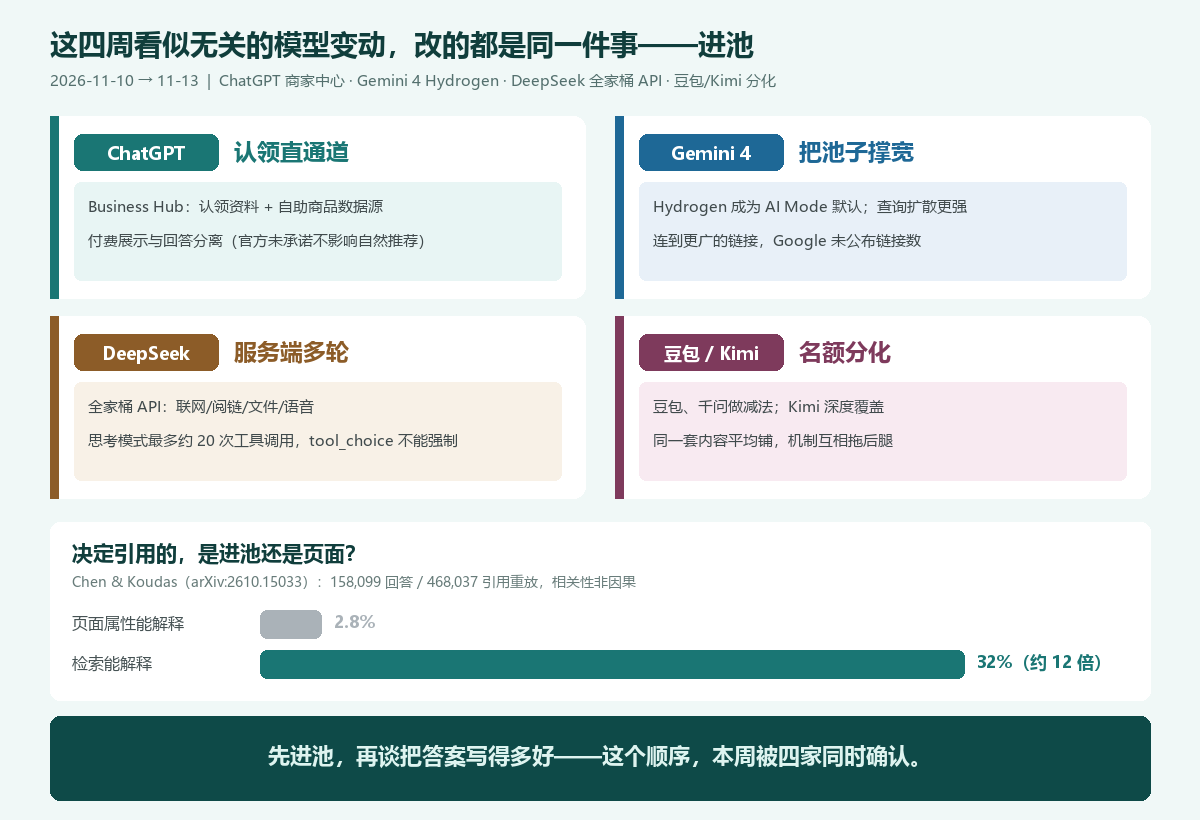
但它们改的是同一个环节——你的内容,怎么才能进入 AI 答案的候选池。而一篇论文刚好给这个环节定了量:页面自身属性能解释的引用差异只有 2.8%,”有没有被检索到”能解释 32%,差了 12 倍。这一周四家模型动的,全都是那个占 32% 的部分。把它们连起来看,GEO 的杠杆在哪就很清楚了。
一、先把基准钉死:进池值 32%,页面属性只值 2.8%
这篇论文是 Chen 与 Koudas 的 arXiv:2610.15033(2026 年 10 月 10 日)。它没看最终答案,而是用各家引擎自己的 API 重放了 158,099 条回答、468,037 次引用,其中被引 URL 子集 22,315 条,然后逐个归因:一条 URL 之所以被引用,到底是因为页面本身好,还是因为它先被引擎检索到了。
| 测量项 | 数值 | 口径 |
|---|---|---|
| 被引 URL 中,先被引擎自身搜索返回的比例 | 100.0% | 22,315 条被引 URL 子集 |
| 池内 rank-1 页面的被引用率 | 43.8% | 已被检索返回的集合内 |
| 池内 rank 11–20 页面的被引用率 | 3.5% | 同一集合内 |
| 页面属性能解释的引用差异 | 2.8% | FAQ、结构化数据、摘要框、页面速度等 |
| 检索能解释的引用差异 | 32% | 约为页面属性的 12 倍 |
100.0% 这一行要先划重点:没有一条被引 URL 是”没经过检索就被直接引用”的。进池是硬门槛,不是加分项。而 2.8% 对 32% 这组对比,把”打磨页面”和”进入候选池”的价值排序摆明了——论文自己谨慎标注这是相关性、不是因果,但 12 倍的量级差足以说明方向。
还有一个容易忽略的补充:把标题写成用户的问句,在不同引擎上效果不同。同一研究测出的”标题匹配问题”带来的引用提升,Gemini 是 +16.8%,Perplexity +4.6%,ChatGPT Search 却是 −0.2%。同一个动作,符号都会反过来。而这正是本周四件事的背景板。
二、ChatGPT 商家中心:品牌拿到一条”认领”进池的直通道
11 月 10 日,OpenAI 官方发布 Businesses in ChatGPT(测试版),核心是 Business Hub:企业可以认领自己在 ChatGPT 里的商家资料,通过验证后更新关键信息,并自助添加包含价格和供货情况的商品数据源。官方给出的数字是每周使用 ChatGPT 的 12 亿用户。
真正对 GEO 有意义的是仪表板。官方列出的洞察包括:商家被提及的次数、网站点击量、资料浏览量,以及”用户发现商家时涉及的话题”——也就是引用你网站的对话里常见主题。这些数据是汇总的,且只在对话或互动量达到某个门槛后才显示,OpenAI 不分享用户对话原文,也没公布门槛具体是多少。
换句话说,过去品牌在 AI 里的进池方式只有一种:等引擎来抓。现在多了一条:自己把结构化、带价格和库存的数据交上去。这对 184 期讲的”从被抓到被签约”是一个延伸——那篇说的是少数媒体和大品牌与 OpenAI 签约成为授权信源,这次是把类似能力向普通商家开放了一层。
但有三条边界必须说清楚,免得读成”可以买引用”:
- 官方原文只承诺付费推广展示位”有清晰标识,并与 ChatGPT 的回答分开呈现”;官方页面并没有写”付费不影响自然回答的推荐频率”。这句话见于一些二手解读,在官方发布页上找不到。别把解读当承诺。
- 仪表板的”点击”不等于成交。官方对点击的定义很克制,第三方实测的仪表板里,点击÷提及的比例低的只有约 3.5%——提及多不代表点击多。
- 商家智能体首期只向美国符合条件的电商和在线服务商家开放;商家资料认领的范围是”位于 ChatGPT 可用地区且符合条件的商家”。国内品牌短期内拿不到完整能力。
结论不是”去付费”,而是:把官方数据源当成一条需要认真运营的进池通道——价格和供货这类结构化事实,一旦交给引擎,就比散落在网页正文里更容易被采信。
三、Google Hydrogen:把池子撑宽,却把归因搞乱
11 月 12 日,Google 搜索产品副总裁 Robby Stein 宣布 Gemini 4 Hydrogen 成为 AI Mode 的全球默认模型,并用于 AI Overviews 里最难的问题,称这是”迄今为止最大的搜索模型升级”。官方列出的变化里,和 GEO 直接相关的是查询扩散(query fan-out)更强——同时针对问题的多个子题发起检索,从而连到”更广泛的链接,包括用户原本不会发现的网站”。
这句话对小站是好消息:池子变宽,长尾、具体的页面有机会被捞到。182 期我们讲过这次升级叠加核心更新带来的归因陷阱——核心更新 11 月 10 日开始,模型 11 月 12 日切换,两个日期必须分开标注。这里补两点新的:
- Google 没有公布链接数、站点数或点击数。任何”Hydrogen 多引用了 X% 网站”的说法都缺官方依据,别拿来当基线。
- 更宽的 fan-out 也可能是双刃剑:你的页面可能进了池,但只是变长答案里的众多链接之一。进池不等于占据答案——这正是 rank-1 只有 43.8% 被引用率的另一面。
那 fan-out 到底有多普遍?Ahrefs 10 月 12 日的研究(GeoAura 11 月 17 日更新引用)给了一个更准的口径:6,660 万条免费、登出状态的 GPT-5.6 响应里,14.4% 含有至少一条 fan-out 查询,每次约 1.6 条;85.6% 的响应没有把问题拆成子查询。这里有个被传错的细节:Ahrefs 最初写的是”14.4% 的响应搜索了网页”,后来更正为”含 fan-out 查询”——两者不是一回事,而且”未分解”也不等于”没引用、纯靠记忆”。连头部研究的口径都会写错,你看数字时一定要读原文口径。
四、DeepSeek 全家桶 API:进池变成开发者可调的服务端动作
11 月 13 日,DeepSeek 把 App 与网页端的完整体验通过 API 开放。模型是 V4.1-Flash(调用名 deepseek-flash),对话接口整合了五项能力:联网搜索、深度思考搜索、阅读链接、文件输入、安全校验;同时把 Search、Fetch、OCR、ASR、TTS 拆成五个独立接口,可以单独调用。
对 GEO 最关键的是两条行为细节:
- 是否发起搜索、是否打开链接,由模型判断,tool_choice 不能强制指定。也就是说,你的内容会不会被抓,决定权在模型在那一步的判断,不在调用方的一行参数。
- 思考模式下,模型在多步推理里自主搜索、打开网页、页内查找核对,最多调用约 20 次工具。这是服务端的多轮检索,不在你的监测视野里——185 期讲的”DeepSeek 把检索装进服务端、GEO 够不着的那一层”,这次是它把这套能力正式产品化、开放给开发者。
计费也能反推行为:搜索每 1,000 次 5 元、网页抓取每 1,000 次 5 元,一条提问若触发多次搜索或抓取按次数累加,响应 usage 字段里可查工具使用次数。这意味着”同一个问题到底搜了几轮”第一次有了可测量的成本信号。还有一条合规要求:对外提供服务须开启 safety_check(level 为 high)——公开应用要把安全校验做进去。
五、豆包收窄、Kimi 扩张:同一个池子,几种不同的尺寸
QuestMobile 11 月 3 日发布《2026 中国移动互联网秋季大报告》(每日经济新闻同日报道)。2026 年 9 月的月人均数据:豆包 72.0 次、132.5 分钟,DeepSeek 65.9 次、136.7 分钟,元宝 38.7 次、78.6 分钟,Kimi 26.2 次。比绝对值更值得看的是环比 6 月:豆包次数下滑 6.1%、时长下降 7.8%;DeepSeek 次数上涨 5.8%、时长提升 9.5%。
报告对引用机制做了分化描述:豆包、千问在提效上做减法,元宝与 DeepSeek 稳健迭代,Kimi 走深度覆盖,文心均衡拓展。这里的含义很直接——做减法的平台,能进答案的名额更少,每一条都要更能打;走深度覆盖的平台,覆盖面本身还有空间。同一套内容平均铺到所有平台,等于让两种机制互相拖后腿。
这和前面三家连起来,正好构成四种”进池尺寸”:ChatGPT 开了一条官方认领的直通道,Google 把池子横向撑宽,DeepSeek 把进池变成多轮可测的服务端动作,豆包与 Kimi 则在收窄和扩张之间分道扬镳。它们改的都不是页面本身,而是页面的入口。
六、四条线收束成三件事
| 本周变动 | 它改的是哪道进池口 | 你该做什么 |
|---|---|---|
| ChatGPT 商家中心 | 官方数据源直通道,与付费展示分离 | 把价格、供货、关键事实整理成结构化数据,有条件就认领资料 |
| Gemini 4 Hydrogen | 查询扩散更宽,池子里链接更多 | 按子问题铺内容;11/10 与 11/12 两个日期分开标注,别混着归因 |
| DeepSeek 全家桶 API | 服务端多轮检索,最多约 20 次工具调用 | 正文用 raw HTML 承载关键事实,别靠 JavaScript 渲染;按 usage 看触发轮次 |
| 豆包收窄 / Kimi 扩张 | 名额策略分化 | 按频次时长排平台优先级,主战场做深,其余保证被检索到 |
把三件事压缩成一句话:别再把主要精力投在”把页面写得更像答案”,而要投在”让页面更容易进池、进更多池”。页面属性那 2.8% 不是不用做,而是它排在进池之后。顺序错了,前面做得再好也进不了答案。
FAQ
Q:2.8% 对 32% 是说页面优化没用吗?
不是。论文标注的是相关性、不是因果,2.8% 说的是”页面属性能解释的引用差异份额”,不是”页面优化只能带来 2.8% 收益”。它表达的是相对优先级:在被引 URL 100% 都经过检索的前提下,先进池比先打磨页面更重要。两件事都要做,但有先后。
Q:ChatGPT 商家中心是不是等于”付费就能被引用”?
官方发布页没有这个承诺。它明确的是付费展示位有标识、与回答分开呈现;没有写付费是否影响自然推荐的频率。把”付费推广”和”商家资料认领”分开看——后者是提交结构化事实的通道,前者是广告位。二者在官方描述里是分开的。
Q:14.4% 到底是不是”ChatGPT 只有 14.4% 的回答会搜索网页”?
不是。这是 Ahrefs 研究里一个已被更正的口径:14.4% 指的是”响应中含有 fan-out 查询”,不是”搜索了网页”。样本是 6,660 万条免费登出响应,每次搜索约 1.6 条子查询;85.6% 未分解问题,但”未分解”不等于”没检索、纯记忆”。引用这个数字时务必带上限定的口径。
Q:Hydrogen 把池子撑宽,是不是小站机会就来了?
有机会,但不是无条件。更宽的 fan-out 意味着更具体的长尾页面可能被捞到,可同时池内 rank-1 的引用率也只有 43.8%——进了池还要被选中。Google 没公布新增链接数,所以现在只能观察自己的引用变化,不能相信”多引用 X%”这类无依据的说法。
Q:这一周的变化和前几期(换脑、服务端检索、监测漏报)是什么关系?
是同一条线的连续推进。182 期是 Google 换脑带来的归因混乱,185 期是 DeepSeek 把检索移到服务端,187 期是监测代理只能看到约四分之一。本期把它们和最新的商家中心、豆包/Kimi 分化放在一起,给出统一的解释框架:这些变化的共同点,是都在改动”进池”这一层,而不是”页面”这一层。
结语
这一周四家模型看起来在做四件不同的事,其实都在回答同一个问题:什么样的内容,可以进入答案的候选池。ChatGPT 给了一条认领的直通道,Google 把池子撑宽,DeepSeek 把进池变成服务端可调的多轮动作,豆包和 Kimi 把名额调成一窄一宽。而 2.8% 对 32% 的数字提醒我们:GEO 的胜负手正在从页面层移到进池层。先把内容送进池子,再谈把它写得多好——这个顺序,本周被四家模型同时确认了一遍。