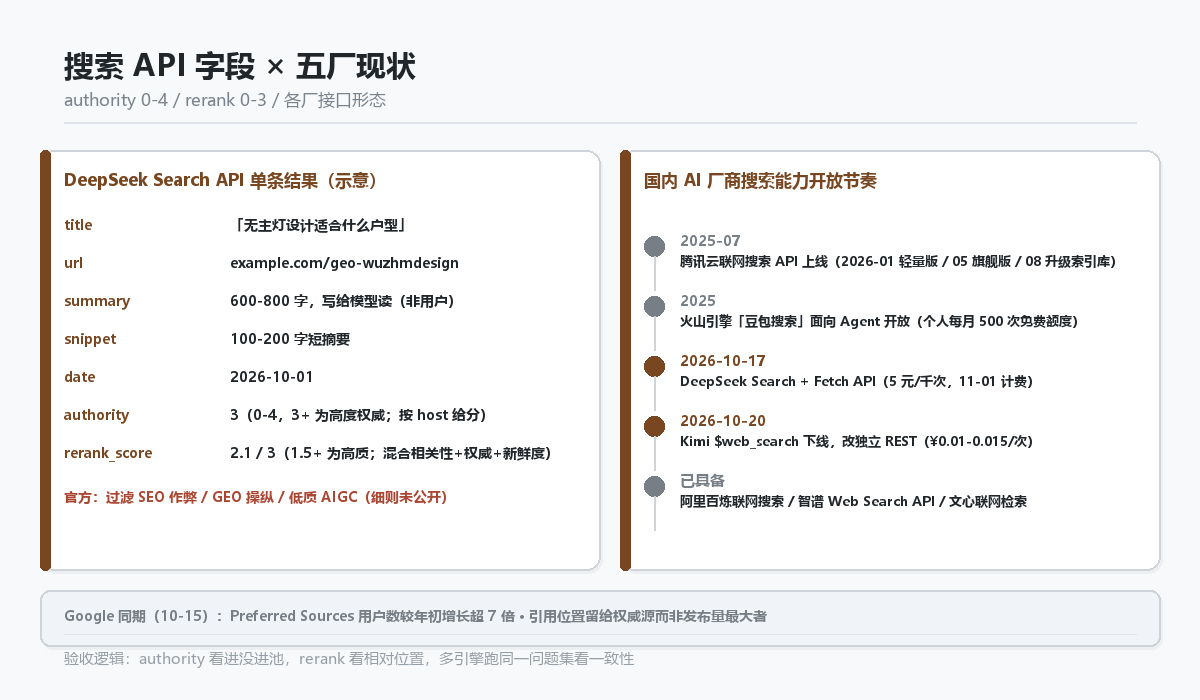
10 月 17 日,DeepSeek 把自家搜索引擎的 API 开放了。Search 加 Fetch 两个接口,每条结果带两个此前看不到的字段——authority 和 rerank_score。同一天官方更新日志里有一句话被反复引用:针对 SEO 作弊、GEO 操纵和低质 AIGC,搜索系统会做识别过滤。
过去,「AI 怎么引用我的内容」是个黑箱——你看得到答案,看不到中间过程。现在黑箱被打开了一扇窗:你能查到你的内容在候选池里没、被分到什么层级。窗口开了,但没人教你怎么读。
一、这条窗能看什么:两个字段的真实含义
先说清楚这两个字段不是什么:
- authority 不是页面质量分。Snippet Digital 早期实测(110 次调用样本)发现,它实际按 host(域名/子域)给分——同一站点不同页面分数一致。甚至政府/大学域名下的垃圾 PDF 也能拿到 4 分。它衡量的是「来源在候选池里的位置」,不是内容本身好不好。
- rerank_score 不是新鲜度分。它混合相关性、权威度、新鲜度三个维度。一个强信源但跟当前问题关联度低的页面,分数可以很低;一个普通信源但直接回答问题的页面,分数可以合理。实测 1000 条结果中位 1.63,68% 高于官方定义的 1.5 高质线。
能拿它做什么:用 site: 算子查自己站点,看哪些页面进了候选池、分别落在什么 authority 层级——这是第一次能直接看到「AI 眼里我的网站长什么样」。页面缺位时,API 不解释原因(没进索引、被过滤、查询不匹配、抓取失败都有可能),需要自己逐层排查。
二、五厂全自研索引:「一套内容通吃」的假设失效了
把时间线摆出来,能看到一个完整的节奏:
| 厂商 | 搜索 API 现状 | 关键信号 |
|---|---|---|
| DeepSeek | 10-17 开放 Search + Fetch(5 元/千次) | 自研千亿级索引,明确过滤 GEO 操纵 |
| Kimi | 10-20 内置 $web_search 下线,改独立 REST | 搜索从模型绑定拆成独立商品,按次计费 ¥0.01-0.015 |
| 字节豆包 | 火山引擎「豆包搜索」已面向 Agent 开放 | 个人每月 500 次免费额度;信源池锁字节生态 |
| 腾讯 | 腾讯云联网搜索 API 多轮迭代(2025-07 起) | 融合微信生态,与元宝 App 实践打通 |
| 阿里 / 智谱 | 百炼联网搜索 / 智谱 Web Search 均已具备 | 全部自研索引,不依赖 Bing/Google |
核心影响:每个厂的索引覆盖、刷新节奏、信源偏好完全不同。同一篇内容在 DeepSeek 里被稳定引用,不代表在豆包里也进得了候选池。「一套内容通吃」不是效率问题,是根本不可能的问题——各厂的候选池就是不同的池子。
Google 侧同期动作(10 月 15 日)验证了同一个方向:AI Mode 和 AI Overviews 把引用位置留给「更早被模型采纳、更被认定权威」的来源,Preferred Sources 用户数较年初增长超 7 倍。全球平台都在做同一件事:引用位置与发布量脱钩,改为与来源权重挂钩。
三、反制数据:踩线的内容,引用率已经在掉了
DeepSeek 官方没有公布过滤了多少内容,但行业服务商的实测数据(样本口径有限,趋势判断可信)给出了三个参考锚点:
| 风险信号 | 实测数据 | 来源口径 |
|---|---|---|
| 批量发稿引用率 | 70% 铺稿内容在 AI 回答中引用率明显下滑 | 服务商实测,2026-10 |
| 单点孤立内容 | 被屏蔽概率高达 95% | 跨平台无独立佐证的事实 |
| 信息不一致品牌 | 被 AI 首选推荐概率下降 82% | 全网数字/说法冲突的品牌 |
| 权威媒体 vs 自媒体 | 央媒/官媒引用权重约为普通自媒体 25-30 倍 | DeepSeek 回答引用统计 |
| 信源结构 | 引用学术论文与机构报告比例 47%,官方媒体来源占 39.4% | AI 答案来源分析 |
注意:这些是「风险锚点」不是「过滤率」——官方没有公布精确数字,服务商样本有限。但趋势方向一致:孤证在消失,一致性在变成准入条件。
四、三把尺子:用 API 字段做自查
官方没有公布判定细则(截至 10 月 25 日),但有三个可操作的自查锚点,不依赖任何服务商,自己就能做:
- 第一把尺子:跨平台信息一致性——把官网、公众号、第三方平台的同一组数字(成立时间、服务客户数、价格区间)逐一对一遍。不一致的品牌,首选推荐概率下降 82%。这是「事实底座」,先于一切内容动作。
- 第二把尺子:孤证密度——挑 5 条最关键的对外事实(资质、案例、报价),数一数全网有几种独立来源。单点孤证被屏蔽概率 95%,每条关键事实至少铺 2-3 个不同类型的独立信源(自有、权威媒体、行业社区)。
- 第三把尺子:发布量与引用率比——如果你发了 100 篇内容但 AI 引用率没涨,大概率踩在过滤机制边缘。反过来,引用率跟发布量基本同步上涨,说明内容在过线,量是有效的杠杆。
三把尺子都过了不保证不被过滤(官方细则未公开),但不过这三条,基本踩线。
五、排期建议:按周做分引擎监测
窗口开了,最实际的问题是:怎么用?建议把以下动作写进固定排期:
- 每周用固定问题集(10-20 个高频客户问题)在 DeepSeek、豆包、Kimi 各跑一遍,记录每个问题的引用出现/消失/降级三种状态
- 有 DeepSeek API 权限的,对候选池里自己站点页面逐一查 authority 字段,建一张「页面 × 层级」对照表,月度更新
- 把「跨引擎一致性」作为独立指标——同一事实在 DeepSeek 和豆包里说法是否一致,不一致优先修,比加新内容优先
- 别用单一平台数据代表全局:146 期讲的信息密度线是必要条件,多引擎各自过线才是充分条件
六、常见问题
DeepSeek 的 authority 字段能直接当「质量分」用吗?
不能。Snippet Digital 早期实测(110 次调用,迪拜样本)发现两个关键点:第一,authority 实际按 host(域名/子域)给分,同一站点不同页面分数一致,不是按页面内容打分;第二,政府/大学域名下的垃圾 PDF 也能拿到 authority=4——域名权重和内容质量是两回事。正确用法:把它当「诊断输入」,看你的内容进没进候选池、被分在什么层级,而不是当「质量判决」。页面缺位时,缺失原因不解释——可能是没进索引、被过滤、查询不匹配、或抓取失败,都要自己排查。
rerank_score 1.5 以上算「高质」,那低于 1.5 的就是垃圾吗?
不是。rerank_score 同时混合相关性、权威度和新鲜度三个维度——一个页面可能来自强信源但和当前问题关联度低,分数就低;也可能直接回答问题但信源权重一般,分数反而合理。实测 1000 条结果中位 1.63,68% 高于 1.5,说明多数查询下结果整体质量不低。实操:同一查询下对比不同页面的 rerank 相对高低,比绝对值更有意义;跨查询比分数没有意义。
五家厂全自研索引,对 GEO 排期最实际的影响是什么?
核心影响是「一套内容通吃」的假设失效了。DeepSeek 的索引覆盖和刷新节奏与豆包、腾讯系、阿里系完全不同,同一篇内容在 DeepSeek 里被稳定引用,不代表在豆包里也进得了候选池。实际排期建议:以周为单位做分引擎监测——固定问题集在每个厂入口各跑一遍,记录引用出现/消失/降级三种状态,别用单一平台数据代表全局。146 期讲过信息密度线,147 期要加一条:密度达标是必要条件,多引擎各自过线才是充分条件。
官方说过滤 GEO 操纵,我该怎么判断自己踩没踩线?
官方没有公开判定细则(截至 10 月 25 日),但有三个可操作的自查锚点:第一,查跨平台信息一致性——全网信息不一致的品牌,被 AI 首选推荐概率下降 82%(服务商实测口径),先把官网、公众号、第三方平台的数字锁死一致;第二,查孤证密度——单点孤立内容被屏蔽概率高达 95%,关键事实至少铺两个独立第三方信源;第三,查发布量与引用率比——70% 的批量发稿内容引用率已在下滑,如果发了 100 篇但引用率没涨,大概率踩在过滤机制边缘。三个都过了不保证不被过滤,但不过这三条基本踩线。
延伸阅读
黑箱开了一扇窗,但窗户朝内——它让你看到 AI 眼里你的网站长什么样,不告诉你怎么变得更好。真正要做的,还是把事实底座打好、把孤证补齐、把多引擎跑一遍。窗只是让你知道:做到什么程度,才真的过线。