做 GEO 排期的人最近大概都注意到一件事:内容发布后第二天去豆包里查,不出现了;第三天,还是没有;一周之后才慢慢冒出来。以前分钟级就进池子的节奏,没了。
这不是错觉。10 月前后,豆包完成了第三轮调整,直接改变了「抢首发」这条老打法的底层假设。加上前两轮,三轮调整连起来看,逻辑很清楚——
竞争单元正在从「谁发得快」转向「谁的说法经得起多方验证」。
一、三轮调整,三轮失效的打法
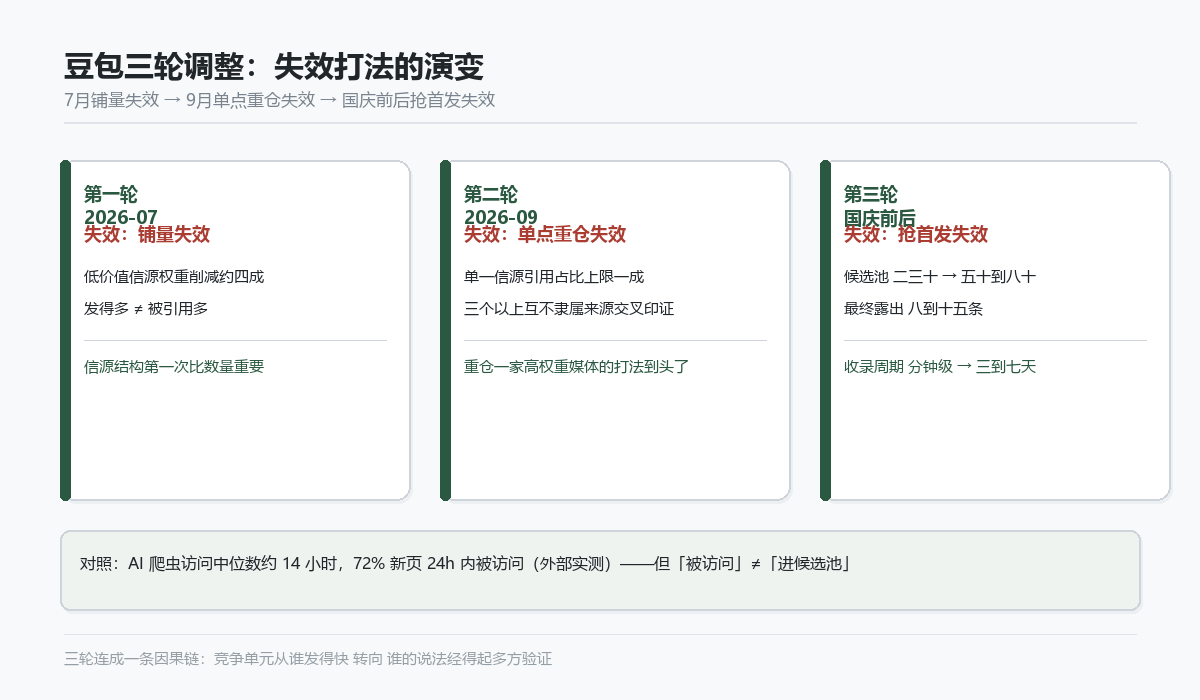
| 轮次 | 时间 | 变化 | 被打破的旧打法 |
|---|---|---|---|
| 第一轮 | 7月 | 低价值信源权重削减约四成 | 铺量堆稿:发得多就容易被引用 |
| 第二轮 | 9月 | 单一信源引用占比上限一成;需三个以上互不隶属来源交叉印证 | 单点重仓:靠一家高权重媒体锁住答案口径 |
| 第三轮 | 国庆前后 | 候选池扩容至五十到八十个信源,最终露出八到十五条;收录周期拉长至三到七天 | 抢首发:先发占坑位,等竞品跟上就晚了 |
需要注意:候选池扩容和收录周期拉长的数字来自行业实测(凤凰网 10-16、海鹦云 09-21、超级媒介 09-08 等多方监测),不同机构口径略有差异,豆包官方未公布具体数字。方向一致,排期时建议按保守值做估计。
二、「抢首发」为什么失效了
旧逻辑是:「别人还没发,我先发占坑位,AI 引用了我的版本,后来者都引用我。」这套逻辑在分钟级收录周期下成立——发布半小时后内容就进池子,速度就是壁垒。
现在三件事同时变了:
- 候选池变大了:二三十个扩到五十到八个,「先发」的内容在池子里被稀释,不再自动占据显眼位置
- 收录变慢了:分钟级拉到三到七天,「先发」的时间优势大幅压缩,等收录走完,竞品也发出来了
- 交叉验证变重了:池子里的可选项越多,AI 越倾向于「有别的信源也这么说」的内容,孤证的劣势被放大
三件事合在一起,结论很直接:先发优势正在被「说法一致性」替代。
有一个常被混淆的地方需要厘清:外部实测显示,AI 爬虫的访问速度其实很快——新页面 24 小时内被 AI 爬虫访问的比例约七成以上,中位首次访问时间约 14 小时。「被爬虫访问」和「进候选池被引用」是两层事:前者是抓取,后者还要过信源分级、交叉验证、语义匹配几关。很多内容被爬虫抓走了,却永远停在候选池之外。
三、收录周期变了,排期逻辑该怎么调
旧的排期假设是「发布 → 当天见效」,现在的假设要改成「发布 → 三到七天后进候选池 → 持续观察」。具体三个调整:
- 把「当天查」改成「第三天查」:发布后第二天查没有结果,不代表失败,是周期还没走完。按三到七天做保守窗口,别在一周内反复下「被降权」的结论。
- 把「追热点」改成「选持续问句」:热点本身会过 4 周以上被持续问的,才值得做。即时性热点(评论区、临时新闻)等收录周期走完就过去了,别追。
- 把「抢坑位」改成「多源对齐」:同一核心事实,在自有阵地 + 两家异质第三方信源上口径一致地沉淀,比单点抢首发更能通过交叉验证。
四、敏感行业的更长时间窗口
医疗、金融等敏感行业的收录周期超过七天,部分场景拉到更久。这不是歧视,是合规要求——这些行业的内容错误代价高,平台把验证做得更慢更严。
做这些行业 GEO 的,排期要按「发布 + 两周」来做预期,别拿普通行业的三到七天来估。同时,这些行业的内容更要保证「一段一个事实」的颗粒度,方便验证环节逐项核对。
五、和「信源结构」的关系
三轮调整连起来看,底层逻辑是统一的:信源结构第一次比信源数量重要。
第一轮让你不能用低价值信源堆量;第二轮让你不能靠单一高权重信源锁住口径;第三轮让你不能靠时间差占坑位。三轮做完,剩下的打法只有一种:核心事实多源对齐、结构化沉淀、持续更新。
这也是为什么「同一份服务商名单,对不同企业给出相反结论」正在发生——评价口径从来没被统一过,信源结构不同的企业,同一个「发一百篇」的动作效果完全相反。
六、常见问题
收录周期拉长后,热点内容还值得追吗
要分两问。如果热点本身会持续影响用户提问(比如政策发布后的合规问题),值得做,但预期要改:不再是「发布当天被引用」,而是「发布后 3-7 天内进候选池,之后取决于交叉验证」。如果热点是即时性的(比如某条新闻评论区),等收录周期走完热点已经过了,这类就别追了。判断标准:用户会持续 4 周以上问这个问题吗?会才做。
3 到 7 天是官方口径还是行业实测
行业实测。豆包官方没有公布收录周期数字,这个数字来自多家服务商和自媒体的实测监测(凤凰网 10-16、海鹦云 09-21 等),不同机构给出的口径略有差异(3-5天、3-7天),方向一致。建议当作「行业观察到的信号」而非「平台公布的规则」来用,排期时按 7 天做保守估计更稳。
候选池变大,是不是意味着机会更多了
恰恰相反。候选池从二三十个扩到五十到八十个,露出名额却只有八到十五条,等于考试名额没加,考生变多了。进候选池只是拿到考试资格,能不能露出,看的是你的内容能不能被其他信源佐证。池子变大,对「说法经得起多方验证」的内容更有利,对「孤证」不利。
被 AI 爬虫访问了,是不是就算被收录了
两件事。外部实测(AI Discovery Index,10 月数据)显示,新发布页面 24 小时内被 AI 爬虫访问的比例约七成以上,中位首次访问时间约 14 小时。但「被爬虫访问」只是进门的凭证,真正进候选池还要过信源分级、交叉验证、语义匹配几关。很多内容被爬虫抓走了,却永远停在候选池之外,因为说法对不上其他信源。
延伸阅读
抢首发的逻辑是「比谁快」,抢说法一致性的逻辑是「比谁稳」。收录周期拉长之后,快的优势被压缩,稳的优势被放大。排期表上的每一天,都应该为「稳」服务。