一位做企业服务的市场负责人,上周和客户开了个有点尴尬的会。他把自己做的 GEO 报告投在屏幕上:某平台里,品牌已经被推荐了。客户当场打开手机,同一句话再问一遍——答案里没有他。
两个人对着两块屏幕,谁也没说错。问题出在:他们都在用「查一次」的方式,去衡量一个本来就不稳定的东西。
一、先看三个让人冷静的数字
2026 年 10 月,有两篇研究把这件事说得很清楚:
- 一篇分析了 15.8 万条 AI 答案、46.8 万条引用,结论是:页面自身的属性只能解释同一站点内引用差异的约 2.8%,而引擎自己的检索行为能解释约 32%。换句话说,页面被引用,首先取决于「它有没有被搜到」。
- 另一篇发现,用精确网址去追踪被引页面,只能找回大约四分之一真正被引用的链接。剩下四分之三,你根本看不见。
- 还有一组一万条查询的重复测试:同一个问题在同一个平台反复搜,被引网址的重合度不到一成,其中两成多的搜索,两次结果完全不重合。
再加上一个更朴素的实验:让几百位志愿者把同一批问题跑上几千次,两次拿到完全相同的品牌名单的概率,低于百分之一。
把这些放在一起,结论只有一个:AI 引用是一个分布,不是一个名次。
二、为什么「查一次」这个方法不成立
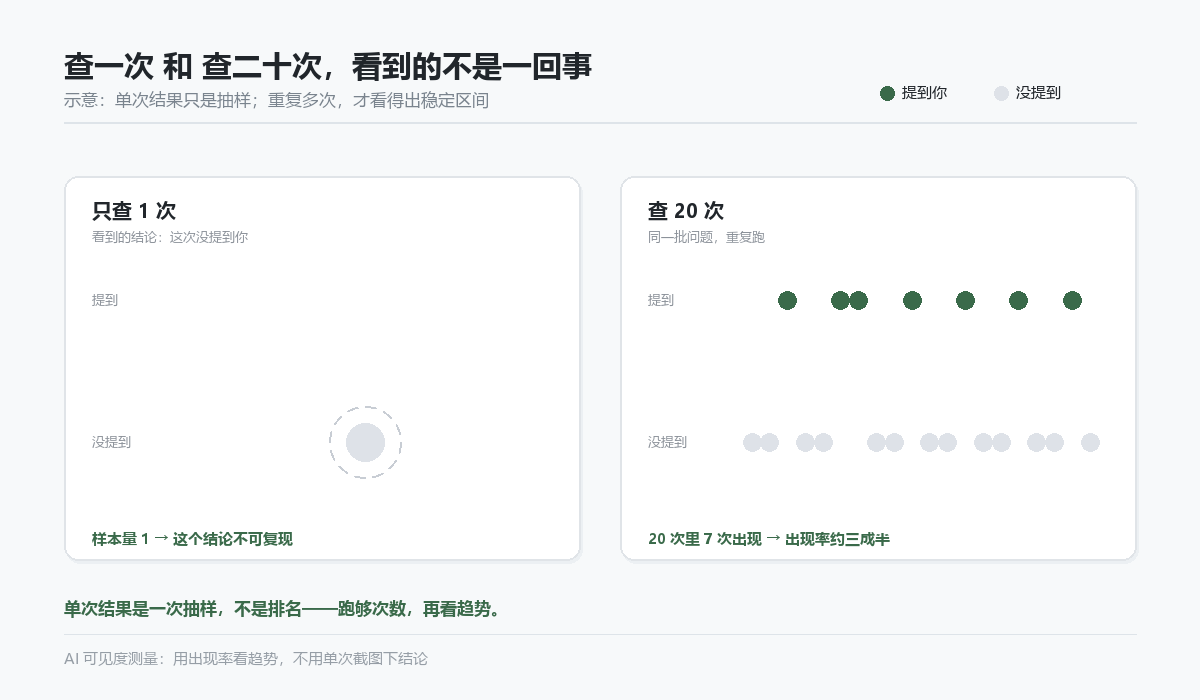
左边的面板是大多数人的做法:问一次,看到答案里没有自己,就得出「没被引用」的结论。这是一次抽样,样本量是一。右边的面板是把同一批问题重复跑二十次——出现的次数加起来,才叫出现率。
还要区分两件常被混为一谈的事:被检索到不等于被采信进答案。有平台的实测是,三轮检索返回了约一百多条信源,最后写进结论的只有二十来条。你在候选池里,不等于你在答案里。
三、换一套能用的测法
把测法从「查一次看排名」换成下面这五项,数据立刻能对得上:
| 测什么 | 怎么测 | 看什么口径 |
|---|---|---|
| 品牌出现率 | 固定问题集,同一平台重复跑多次 | 出现次数 ÷ 总次数 |
| 口径一致性 | 抓取答案里对你的描述,与官网原文比对 | 名称、定位、数字是否同一个版本 |
| 被引来源分布 | 记录被引的域名,而不是精确链接 | 自有站点与站外来源分别占多少 |
| 竞品对照 | 同一批问题同时跑竞品 | 相对出现率,而不是绝对名次 |
| 变化趋势 | 固定周期重跑,把结论连成线 | 环比、月环比,不看单点 |
四、五类最常见的报告陷阱
如果你手上的 GEO 报告长成下面这样,先别急着下结论:
| 报告里的写法 | 问题在哪 |
|---|---|
| 「已优化,AI 已推荐」配一张截图 | 样本量是一,别人复现不出来 |
| 「当前排名第 3」 | AI 答案不显示排名,这是从传统搜索搬来的指标 |
| 「收录 30 篇,全部被引用」 | 被检索不等于被采信,候选池和答案是两回事 |
| 「本页已被引用(附链接)」 | 精确链接追踪只能覆盖约四分之一,不是全量 |
| 「两周内没变化,说明无效」 | 采样次数不够,把正常波动当成了结论 |
五、给执行团队的最小可行口径
不用上工具,用一份表格就能跑起来:
- 固定二十个真实客户问题,别用行业大词;
- 每个问题、每个平台,至少跑三次;
- 每次记录三件事:有没有提到品牌、被引的是哪些域名、答案里对你的描述和官网是不是一个版本;
- 主指标只看两个:出现率、口径一致率;
- 每月重跑一轮,把结果连成线,看趋势不看单点;
- 把平台模型换代的日期一起记在案——模型一换,引用分布会动,别把它误判成内容出了问题。
一句话结论
页面的位置是引擎给的,品牌的记忆是事实给的。测出来的数字对不上时,先看清楚自己测的是哪一个。
常见问题
那到底要测几个平台、几次
起步可以这样:选两三个你客户最常用的平台,固定二十个真实问题,每个问题每个平台跑三次,一个月一轮。次数不够的时候,你看到的波动多半是噪声。
为什么不能直接看「排第几」
AI 答案不提供排名,它给的是「提到了谁」。把传统搜索的名次思维搬过来,测出来的东西没有对应物。要测的是出现率、被引来源和口径一致性。
我们报告里那几条被引链接怎么办
保留,但别当成全量。精确的链接追踪通常只能找回一部分被引页面,有研究给出的比例大约是四分之一。所以更该记的是被引的域名、以及答案里出现的实体,而不是那一条链接。
模型换代会影响我的数据吗
会,而且幅度可能不小。Google 的 AI Mode 模型在四个月里换过四次,一次模型更新曾让同一语言下的引用在两天内变化四成以上。看趋势时把模型换代的日期一起记下来,避免把模型变化误判成内容出了问题。
延伸阅读
能被反复查到的,才叫效果;只被查到过一次的,叫运气。