一位做工业设备的朋友说,他们公司在豆包里能被提到,换到另外两个平台问一模一样的问题,一个字都没有。团队第一反应是:那两个平台是不是没收录我们?
未必。有个更简单的原因经常被忽略——AI 的答案是有容量上限的,一次回答只能引用那么几条来源。你不是没被收录,是没挤进那份很短的名单。
先看清楚:一次回答只有几个位置
有研究用同一批问题、在同一时间段实测了十个平台,统计每次提问平均能被引用多少条来源。结果差得非常远:
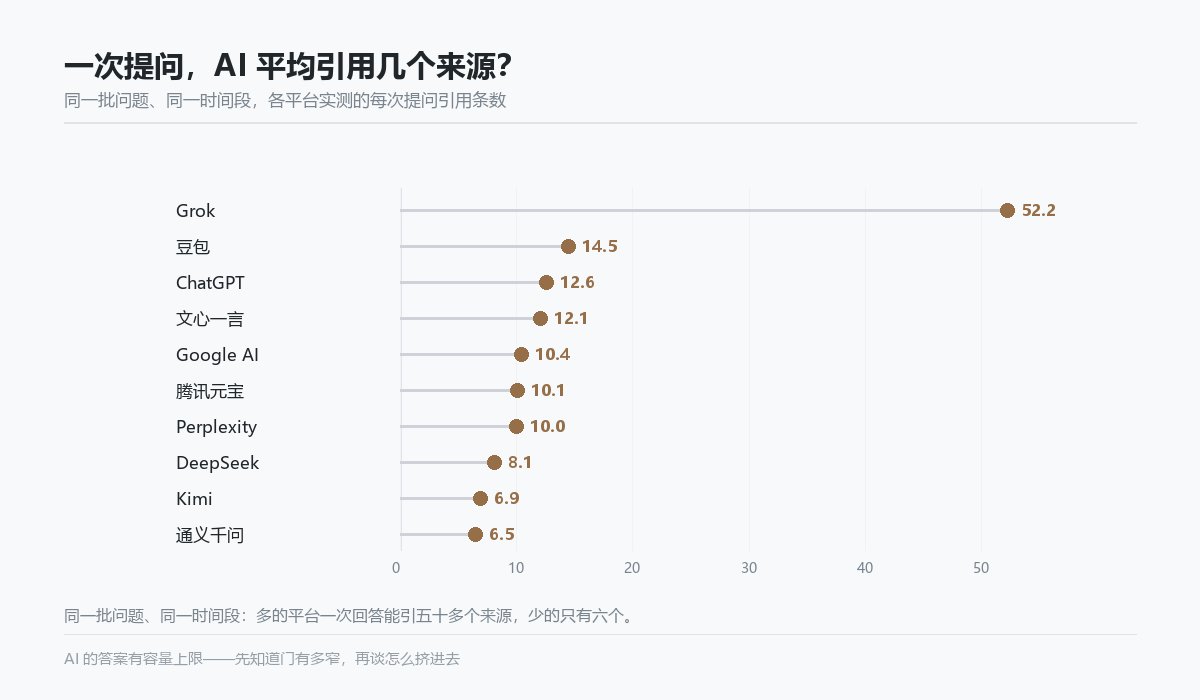
最多的平台一次回答平均引五十多条,最少的只有六条半——差八倍。这条差距说明了一件事:在「名额少」的平台上,进不去就是彻底没有;在「名额多」的平台上,同一件事还有得争。
名额不是固定的:有人在收,有人在放
2026 年 7 月的一份监测显示,几个头部平台单次回答引用的来源数量环比分别减少了 7.5%、3.6%、1.5%;而同期的 DeepSeek、Kimi、文心则在扩大自己的引用池。
两种策略背后是两种取向:前者认为引用太多会稀释可信度,于是「少而深」——同一个来源引用得更充分;后者还在铺开候选面。对你来说,这意味着窗口期不在同一个时间点上,选平台之前先看清它当前是在收还是在放。
名额都被谁拿走了
| 占名额的类型 | 为什么它更容易进 | 你能怎么用 |
|---|---|---|
| 平台自有生态的内容 | 生态内的账号与内容天然拿得到更高的基础权重 | 把你的内容也搬进生态:公众号、百家号、头条号、视频号 |
| 带出处的数据 | 有来源、有年份的数字更容易通过交叉验证 | 每个关键数字都写成「来源 + 年份」,不要只写结论 |
| 口语化的场景答案 | 与用户的真实提问最接近,抽取成本最低 | 把 H2 写成客户会说的那句话,第一句直接给答案 |
顺带说一件容易被忽略的事:中文内容在中文平台有天然优势
同一份研究还统计了各平台引用来源里「中文标题域名」的比例,结论很直接:
| 平台 | 中文标题域名占比 | 意味着什么 |
|---|---|---|
| 文心一言 / 通义千问 | 约 94% / 96% | 中文内容几乎是唯一入口 |
| 腾讯元宝 / 豆包 | 约 76% / 59% | 以中文为主,也开放一部分英文来源 |
| DeepSeek / Kimi | 约 46% / 37% | 更依赖开放网络与技术社区,英文来源占比明显更高 |
所以做国内市场,中文写扎实就是优势;但如果你做的是出海,或者客户是技术采购,那 English 的信源和文档就得单独补——同一篇中文文章,在 DeepSeek 和 Kimi 那边未必顶用。
怎么挤进那份很短的名单
名额少,意味着每一段都得值得被抽走。四个动作最直接:
- 结论前置:每个小节的第一句就是答案,不要先铺垫再给结论——AI 抽取的是段落,不是整篇文章。
- 段落自足:一段话能独立读懂,不依赖上一段和「如前所述」。
- 数字带源:把「很多客户」换成「服务了 320 家客户(2026 年 6 月统计)」。
- 口径统一:名称、成立时间、核心数据,在官网、公众号、各平台保持一个版本——不然交叉验证过不去。
发布前的自查清单
- 你打算主攻的平台,现在是在收紧还是在扩张;
- 每个 H2 下面,第一句是不是直接答案;
- 有没有段落脱离上下文就读不懂;
- 关键数字是否都带了来源与年份;
- 品牌名、成立时间、核心数据是否全网一致;
- 内容有没有同时出现在平台自有生态里。
常见问题
名额变少了,是不是做 GEO 更难了
是更难「进」,但进去之后更值。像豆包这样的平台把同一个来源引得更深、给的上下文更完整,一次深度引用比十次浅浅提及更能带来客户。而且不是所有平台都在收——DeepSeek、Kimi、文心的引用池还在扩,先在有窗口的平台占位。
我们内容不多,还有机会吗
名额少反而对「小而深」有利。与其铺 100 篇泛文,不如把 3~5 个客户最常问的问题写成能被完整引用的页面:结论在前、段落自足、数据带出处。
是不是每个平台都得做一遍
不必要。先问一句:你的客户主要在哪个平台提问?把 1~2 个重合度最高的平台占稳,再扩。不同平台的信源偏好差别很大,平均用力等于哪个都进不去。
怎么知道有没有占到名额
固定一批提问,逐平台做三件事:有没有出现你、引用了哪一页、说的是不是你的版本。记录来源清单,按周对比趋势——单次结果说明不了什么。
延伸阅读
名额在变少,但每一个名额都在变重。与其到处露脸,不如在某一个问题上,成为绕不开的那一句。