一个做 GEO 两年的服务商被问到同一个问题:「我内容质量不错,为什么 AI 引用率还是上不去?」他列了十几条自查项,全对——结构化、来源标注、内容深度,一条不落。真正缺的那个维度,他一个都没数过。
2026 年 6 月,Growth Memo 团队对一批典型查询的 top-10 自然结果做了逐页扫描,发现了一个让 GEO 从业者不舒服的数字:全网平均每个页面只有约 4 个独特数据点,而 AI 引用倾向出现在数据点数量 15 个以上的页面上。
这不是「多写点」的问题。这是密度问题。
一、引用线在 15,全网平均在 4
Growth Memo 的信息增益评分模型,把「独特数据点数量」作为核心输入之一。独特数据点的判定标准是:这个数据在同查询的其他结果里找不到。如果你的五个数字和竞品五个数字一样,信息增益贡献几乎为零。
| 数据点密度 | 信息增益分 | 对应位置 |
|---|---|---|
| 15 个以上 | 62.1 | AI 引用线(高引用区间) |
| 约 4 个 | 40.2 | 全网 top-10 自然结果平均 |
| 1 个及以下 | 40.2 | 低密度底线(与 4 个同分) |
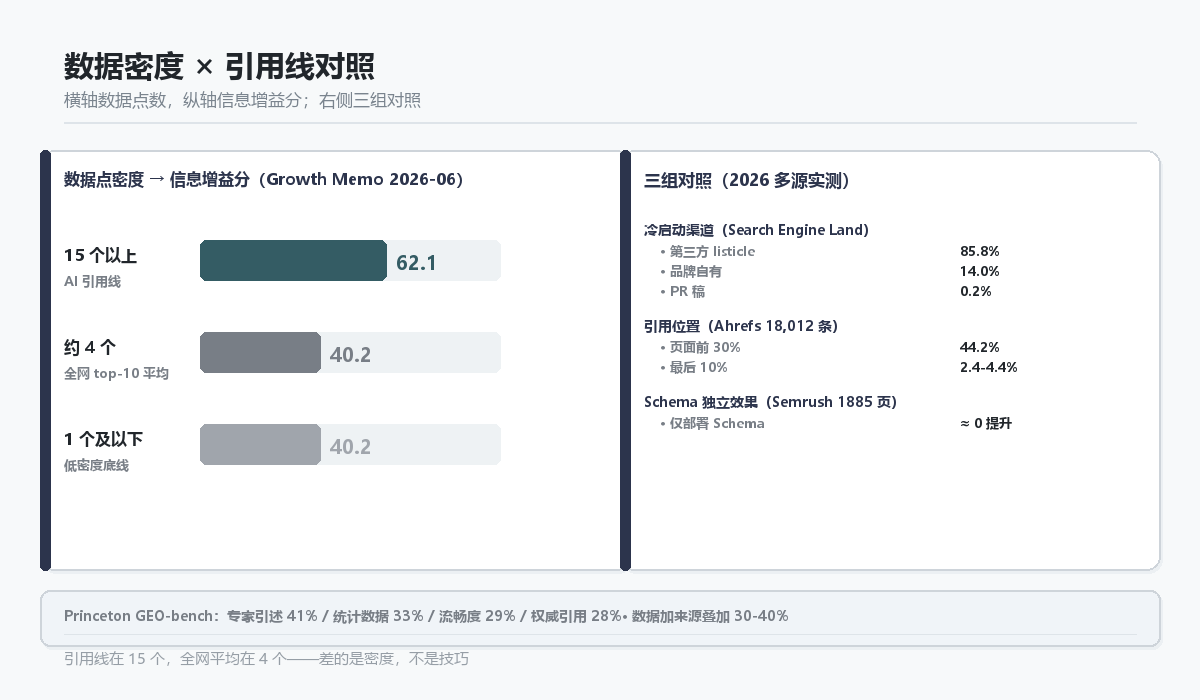
值得注意的是:1 个及以下和 4 个是同分的(都是 40.2)——说明密度有最低门槛,过了门槛之后才进入区分区间。真正的引用线在 15,而全网平均在 4,差近四倍。
二、Princeton GEO-bench:四类策略效果排序
Princeton GEO-bench 是 2026 年引用提升幅度最完整的对照实验,四类 GEO 策略的实测效果:
| 策略 | 引用提升幅度 | 常被误判的原因 |
|---|---|---|
| 专家引述 | 41% | 「没有专家没法做」——其实是访谈形式不限 |
| 统计数据 | 33% | 「数据太旧」——新数据不是必须,密度才是 |
| 流畅度 | 29% | 「写得好就行」——但流畅度是放大器不是独立杠杆 |
| 权威引用 | 28% | 「排第四不重要」——和数据叠加是乘数不是加数 |
最容易忽略的是叠加效应:同时有数据加来源的页面,AI 可见度比两者都无的高 30% 到 40%。权威引用单独看排第四,但它是数据密度的乘数,不是并列选项。
Digital Applied 对 1000 条 AI Overviews 的分析独立验证了这一点:带命名来源的页面,被引用概率是无来源的 2.1 倍。
三、冷启动实验:第三方 listicle 贡献 85.8%,PR 稿只有 0.2%
Search Engine Land 2026 年 9 月 14 日发布了两个对照实验(775 条引用事件加 437 条源提及),其中冷启动实验跟踪了一个零基线品牌在 6 个平台 30 天的引用记录:
| 渠道类型 | 源提及占比 | 信任层级说明 |
|---|---|---|
| 第三方 listicle | 85.8% | 独立佐证——AI 把「别人关于你的陈述」放在最高信任层 |
| 品牌自有 listicle | 14.0% | 半个自我陈述——进了候选池,但信任层级低于第三方 |
| PR 稿 | 0.2% | 自我陈述——做渠道扩散可以,做信任建设不行 |
核心逻辑:「引用」是别人关于你的陈述,不是你自己说的话。自己的来源让你进候选池,别人的第三方页面才把候选池变成引用。0.2% 不是「没用」,是「不能当主要信任来源」——PR 稿的职能是扩散,不是建立信任。
四、页面位置:前 30% 拿走 44.2%,尾部几乎没人在读
Ahrefs 对 18,012 条 ChatGPT 引用的位置分析,发现了一个被叫作「雪道分布」的现象:
- 44.2% 的引用来自页面前 30%——AI 在开头密集采样,因为检索层的摘要层只截取前段
- 页面中部(30-90%):引用分布相对均匀,是「慢速阅读区」
- 最后 10%:仅 2.4% 到 4.4%——你放在结尾的「总结」段落,AI 基本没在采样
实操推论:每个核心段落写成「结论在前,解释在后」,而不是「铺垫在前,结论在后」。如果你的关键数字藏在第 8 段,检索层拿到的摘要还是旧的,模型认不出你更新过。
五、两个「看起来有用但实测无效」的误判
Chen & Koudas(arXiv:2610.15033,2026-10-10)用 158,099 个答案、468,037 条引用做了站内比较,结论有两个值得写进自查清单的误判:
- FAQ 块、结构化数据、摘要框、作者框、页面速度——站内均不显著(只有跨站比较时才显著)。「这招在这站没用」不等于「这招无效」,但它解释了为什么很多「照做但没效果」的案例
- 引擎自身检索解释 32% 的引用差异,所有页面属性合计只解释 2.8%(约 11 倍差距)。先确保被检索到,再谈页面技巧
Semrush 的 1885 页 Schema 对照实验补充了另一半:单纯部署 Schema 标记,引用提升约等于零。Schema 是前提条件(让 AI 知道这是结构化内容),不是独立杠杆(加了 Schema 引用率不会自动上涨)。
六、常见问题
「独特数据点」到底怎么算,写五个数字就算五个吗?
不算。独特数据点的判定是「这个数在同一个查询的其他 top-10 结果里找不到」。如果你的五个数字和竞品五个数字一样,那在信息增益评分里贡献几乎为零。实操上先跑一遍目标查询,把 top-10 的数据点全列出来,你的内容里出现它们没有的数字、时间、案例才计入。这就是为什么「全网平均只有 4 个」——大家都在抄同一批数据。
Princeton 说权威引用是第四位(加 28%),是不是说不用费心堆引用了?
不是,是排序问题,不是重要性问题。四类策略叠加时,同时有数据加来源的页面 AI 可见度比两者都无的高 30% 到 40%——引用单独看排第四,但和数据一起用是乘数不是加数。Digital Applied 的 1000 条 AI Overviews 分析也验证了这一点:带命名来源的页面被引用概率是无来源的 2.1 倍。正确理解是:先做数据密度(加 33%),再加来源(再加 28%),两个一起做拿到复合效应。
第三方 listicle 贡献了 85.8% 的源提及,自己发 PR 稿只有 0.2%,怎么办?
冷启动实验(Search Engine Land,2026-09-14,775 条引用事件)把这三档分得很清楚:第三方 listicle 85.8%,品牌自有 listicle 14.0%,PR 稿 0.2%。核心逻辑:AI 把「别人关于你的陈述」和「你自己说的话」放在不同的信任层级。PR 稿是自我陈述,品牌 listicle 是半个自我陈述,第三方 listicle 才是独立佐证。实操上:先让第三方平台有你的内容(哪怕只提品牌名),再让品牌自有内容做深度分析,最后 PR 稿只做渠道扩散不做信任建设。0.2% 不是「没用」,是「不能当主要信任来源」。
44.2% 引用来自页面前 30%,我的内容结构要全改吗?
不是全改,是前置。把核心结论、关键数字、可独立摘录的定义句放在每段的开头而不是中间,让 AI 在前 30% 就能拿到完整判断。Ahrefs 的「雪道分布」数据显示:最后 10% 只贡献 2.4% 到 4.4% 的引用——放在页面结尾的「总结」段落,AI 基本没在采样。实操:每个核心段落写成「结论在前,解释在后」,而不是「铺垫在前,结论在后」。
延伸阅读
密度不是字数,是「别人没有的数字」。引用线在 15,全网平均在 4。先把数据密度补到线以上,再谈其他杠杆——因为其他杠杆的乘数效应,是建立在「你过线了」这个前提上的。