过去一个月,国内几家模型团队几乎同时放出了一批和”训练”有关的东西:月之暗面开放了 Kimi K3.1 Pro 的权重,把参数没变、只靠后训练加码的做法摆到了台面上;字节 Seed 连续放出两篇论文,一篇讲用稀疏自编码器拆开 MoE 的专家分工,一篇开源了换架构换效率的 Cola2;Qwen 系列的两篇后训练论文则直接挑战了”RL 泛化、SFT 记忆”的老分法。
这些看起来是模型圈内部的事,和 GEO 隔着好几层。但把它们放在一起,能看到一条共同的线:模型公司正在把增量算力,从”多背一些网页”挪到”教模型怎么核验一个答案”。而这件事,恰好动到了 GEO 最底层的那个假设——模型凭什么信你。
先把划界说清楚:25033 期讲过 K3.1 Pro 把上下文推到 100 万 token,25062 期讲过幻觉率降到 8.3% 之后的错引风控,188 期讲过”进池”。本篇不重复这三条,而是往上游退一层,讲训练配方本身——模型是怎么被训成”现在这个样子”的,以及这对内容方意味着什么。
一、配方一:参数不动,算力全砸到后训练
Kimi K3.1 Pro 最值得看的不是分数,而是它”没改什么”。官方口径里,总参数 2.8 万亿、每 token 激活 1040 亿、896 个专家里激活 16 个、100 万 token 上下文——这些和 7 月发布的 K3 完全一致。变的是后半段:月之暗面明确说它是 K3 的 post-trained version,在数百个下游领域做联合强化学习,并为此重构了 RL 框架、长上下文推理、训练效率、沙箱基础设施和 rollout 调度这一整层。
后训练流水线的三个细节,比参数表更有信息量:
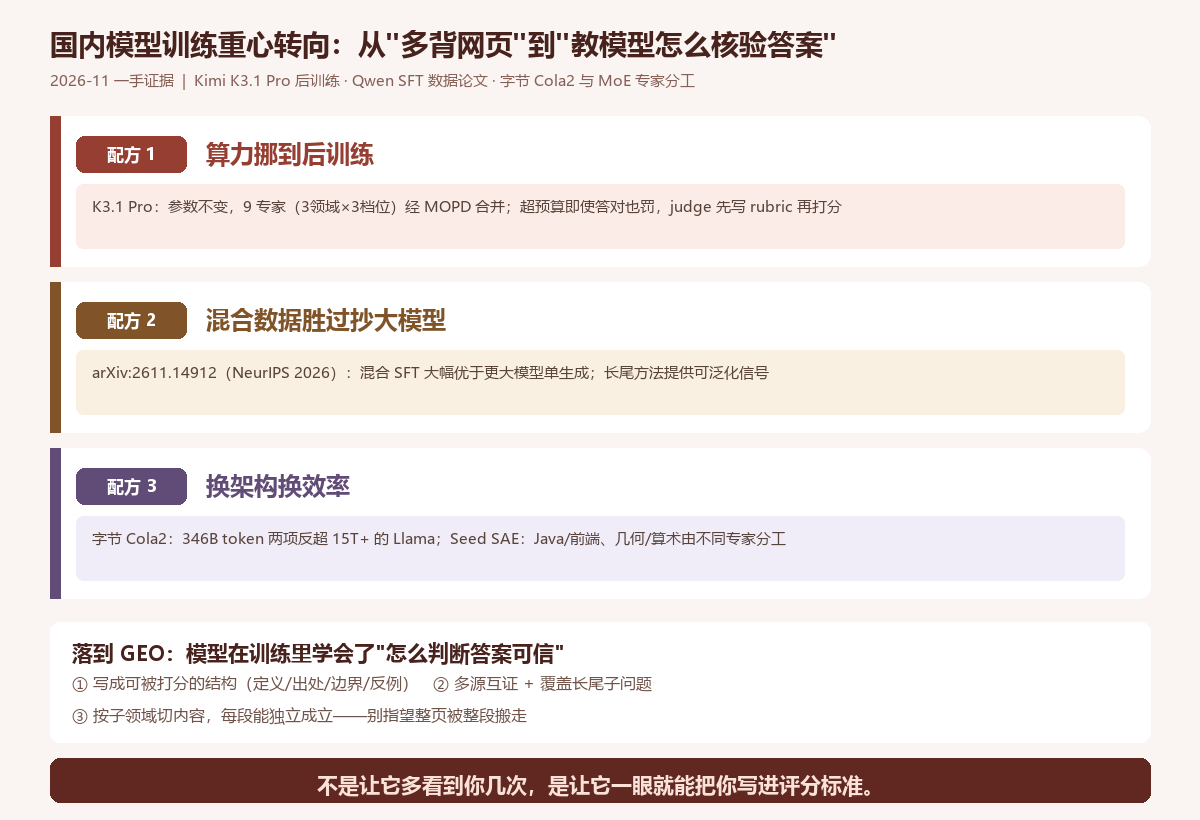
- 3 个领域 × 3 个推理档位 = 9 个专家,最后合并成一个模型。领域是通用任务、通用 agent、编码 agent;档位是 low、high、max。每个档位单独训一个专家,再用 MOPD(多教师同策略蒸馏)把九个专家合并进一个模型——按任务把学生模型往对应专家的 token 级选择上拉。
- 推理档位靠”预算惩罚”教出来。一条轨迹超过 token 预算,即使答案正确也要被罚。这意味着”答得对”和”按你给的算力预算答对”在训练里是两件不同的事。
- 不能自动校验的任务,让 judge 模型先写评分标准(rubric),再按 rubric 给候选打分;跑得太长的候选直接判负。这是把”什么样的答案算好”显式写成了一份可打分的清单。
还有一条容易被漏掉:为了不让模型过拟合到某一个 agent 工具,团队造了模仿 Kimi Code、Claude Code、Codex、OpenClaw 和 Hermes 的工具定义、系统提示与上下文处理的训练环境,混在一起训。同一件事,换了工具外壳,模型也要能认出来。
这里要克制一点:K3.1 Pro 的幻觉率从 K3 的 23.4% 降到 8.3%(内部高压压力测试,官方自己说明不代表日常错误率),这个数字 25033、25062 两期已经从”上下文”和”错引风控”角度写过。本篇只取它的训练含义:幻觉率是被”训”下去的,不是被”写”下去的——模型在训练阶段就被教着按 rubric 核验,而不是靠内容方在发布后补一段免责声明。
二、配方二:混合数据胜过”照抄大模型答案”
如果说配方一是”算力往哪儿放”,配方二回答的是”拿什么喂”。Qwen 系列的两篇论文给出了今年最直接的答案。
第一篇是《Rethinking “RL Generalizes, SFT Memorizes”: The Role of SFT Data》(arXiv:2611.14912,2026 年 11 月 11 日提交,已被 NeurIPS 2026 接收)。它在 Qwen2.5 和 Qwen3 系列上把一条流传很广的经验拆开了——过去大家默认 RL 泛化好、SFT 只是记忆。论文的结论有三个层次:
- 数据来源是关键:精心混合的 SFT 数据集,大幅优于只用更大模型生成的数据。换句话说,”请一个更强的模型把标准答案写出来给我背”,不是最优解。
- 数据规模也关键:匹配 SFT 与 RL 的正确 rollout 数量,SFT 的泛化大幅改善;匹配总 rollout 预算,SFT 泛化能和 RL 一样好;两者结合,SFT 甚至超过 RL。“SFT=死记硬背”这个标签被撤掉了。
- 用 LLM 标注去刻画训练 rollout 里的解题方法后发现:数据集越大,覆盖的尾部方法(tail methods)越多,而这些尾部方法提供了可泛化的推理信号。价值不只在主流答案,也在长尾路径。
第二篇是 RSI-Craft(arXiv:2611.03698)。它把研究论文转成可执行的训练环境(数据集、指标、评测代码),按可靠性和难度过滤后留下 281 个后训练任务,让前沿模型在改良的 harness 下解题,再用筛过的轨迹微调 Qwen——9B 版本提升 8.74 分;RSI-Dojo-35B-A3B 在 PostTrainBench 上提升 16.87 分、达到 29.95,与 GLM-5.2、GPT-5.5 相当。
两篇论文指向同一件事:训练数据的价值,来自来源的混合度和长尾的覆盖度,而不是来自”最强模型的标准答案”。这对内容侧是一个可以直接翻译的信号。25096 期讲过”引擎在 URL 上分裂、在品牌上收敛”,25090 期讲过”先定引擎再倒推渠道”,这里从训练侧给出了第三条理由:模型本来就是在多种来源、多条路径的混合里学会泛化的,单一口径、单一来源的内容,在训练视角下就是低价值样本。
三、配方三:不堆规模,换架构换效率
第三条线是字节 Seed 的 Cola2(arXiv:2610.31305),11 月 6 日在 GitHub 与 Hugging Face 开源。它是一条约 9B 参数的连续潜变量(continuous latent)语言模型:先把文本切成 1 至 8 个 token 的语义 span、每个 span 压成一个 64 维连续 latent,再由一个约 4B 参数、用 Flow Matching 训练的 block-causal Diffusion Transformer 生成 latent block,最后由 span-causal token decoder 解码回离散 token,并用 latent feedback 保持连续与离散历史对齐。
官方强调的不是分数,而是 token 效率:这个 checkpoint 只用了 346.03B source token 预训练,八任务平均 60.10,低于所有对照模型;但在 HellaSwag(41.75 对 39.21)和 StoryCloze(80.42 对 79.49)两项上超过了用 15T+ token 训练的 Llama-3-8B——预训练量差了 43 倍以上。官方自己也写明:latent DiT 尚未收敛,这是 base model 不是聊天助手,仓库里没有训练代码。
同一周字节 Seed 还有另一篇论文(arXiv,2026 年 11 月 5 日):在 Qwen3-30B-A3B 的 MoE 层输出上训练稀疏自编码器,用 affine encoder 把每个 latent 的预激活精确分解到各专家上。结果是专家的实际贡献远比路由频率集中,而且出现了子领域级的分工——有专家专门管 Java,有专家管前端网页代码,有专家管几何,有专家管算术与多项式。代码和 SAE 权重已开源。
这两条研究路线对 GEO 的启发要说得诚实:Cola2 是 research checkpoint,不是能直接改变你监测口径的产品;”专家分工”是机制解释,不是操作手册。它们共同指向的只有一个判断——能力增长正在从”读得更多”转向”读得更准、拆得更细”。这和 25130 期讲过的 passage 粒度是同一条线,只是这次证据来自训练侧:如果模型内部本来就是按子领域分工的,那么按子领域写、能被精准切片的段落,比”写满一整页”更贴合它的读取方式。
四、三张配方,落到 GEO 是三句话
| 训练侧的转向 | 一手证据 | 内容侧该改什么 |
|---|---|---|
| 算力挪到后训练,用 rubric 和预算惩罚教模型核验 | K3.1 Pro:9 专家 + MOPD 合并;超预算即使答对也罚;judge 先写 rubric 再打分 | 把答案写成”可被打分”的结构:定义、出处、适用边界、反例,四样齐全 |
| 混合数据胜过单一大模型生成,长尾方法提供泛化信号 | arXiv:2611.14912:混合 SFT 大幅优于更大模型单生成;尾部方法提供可泛化信号 | 同一事实给多源互证的版本,覆盖子问题与长尾问法,别只押一条权威口径 |
| 换架构换效率,专家按子领域分工 | Cola2:346B token 达 Llama-3-8B 两项反超;Seed SAE:Java/前端、几何/算术分开 | 按子领域切内容,保证每段能独立成立;别指望整页被整段搬走 |
三句话合起来是:模型在训练阶段被教会了”怎么判断一个答案可不可信”,你要做的不是让它多看到你几次,而是让它一眼就能把你写进它的评分标准里。这和 188 期的”先进池”不冲突——进池是入场券,配方转向决定的是入场之后凭什么被采信。
FAQ
Q:这些训练算法和 GEO 到底有没有直接关系?我们又不训模型。
没有可操作的直接关系,别把论文当操作手册。它们的价值是上游信号:告诉你模型公司正在把”可信”这件事写成训练目标。你无法改训练配方,但可以按配方指向的方向改内容结构——这是间接但可靠的推断,不是因果承诺。
Q:幻觉率 23.4%→8.3% 这篇又在讲一遍吗?
不是主卖点。25033 期从”上下文变长、证据链”角度写过,25062 期从”错引风控三轴”角度写过。本篇只取一个训练侧事实:幻觉率是训练目标调下去的,judge rubric 和预算惩罚是手段。角度在训练配方,不在幻觉数字本身。
Q:”混合数据胜过单一大模型生成”落到内容上,具体怎么写?
两件事。一是同一事实准备多个可交叉验证的出处(官网 + 行业媒体 + 第三方数据),别只在一个地方说一遍。二是按子问题铺内容:价格、适用场景、排除条件、对比,每个都能独立成立——这就是论文里”尾部方法提供泛化信号”在内容侧的对应面。
Q:Cola2 这种架构,现在就要适配吗?
不用。官方明确写了 latent DiT 未收敛、没有训练代码、是 base model 而非聊天助手,下载量也只有几百次。它是研究信号,不是产品变化。值得记的是方向(读得更准、拆得更细),不是这个 checkpoint 本身。
Q:9 个推理档位专家,是不是要写 9 个版本的内容?
不是。9 个专家是训练时按”领域 × 推理预算”分开训、再合并的,面向的是模型内部行为。内容侧只需要保证同一事实在 low、high、max 三档下被读到时都成立——也就是别把关键事实藏在只有深读才看得到的位置,也别靠冗余堆长度。参考 25158 期的做法:监测表按模式分列,别混着比。
结语
这一波国内训练算法变动,表面是模型圈的技术迭代,本质是“可信”这件事被写进了训练目标:K3.1 Pro 用 rubric 和预算惩罚教模型核验,Qwen 的论文证明多源混合与长尾覆盖比抄标准答案更能泛化,字节的两篇研究把能力增长指向”拆得更细”而不是”读得更多”。对 GEO 来说,结论不是去追这些算法,而是认清一件事:让人写成什么样,已经越来越不像由人的阅读习惯决定,而是由模型的评分标准决定。把内容写成能被评分的结构,比写得多、铺得广更值钱。