11 月 18 日到 19 日,三件看起来不相干的事几乎同时发生:DeepSeek 把模型调用触发的服务端搜索和网页抓取改成不单独收费;Perplexity 推出 Context API,默认只读自己索引里”最近两天抓取”的网页副本;Google 更新 Antigravity 文档,把能用哪个模型按订阅档位切开,OpenAI 则公开了 Codex 沙箱”默认禁网、按域放行”的设计。
把它们放在一起看,指向的是同一层:模型真正伸手去读你网页的那一刻,规则正在被重写。不是”能不能被搜到”,也不是”模型信不信你”,而是——它抓不抓你、读缓存还是读实时、凭什么字段决定值不值得读。这是 GEO 的第三层。
划界先说清:188 期讲”进池”(被引 URL 100.0% 先经引擎检索,检索解释 32% 引用差异),189 期讲”训练配方”(把可信写进训练目标)。本篇不重复这两条,只讲读取层——请求发出之后、内容进入模型之前,那道门是怎么开的。
一、DeepSeek:服务端抓取免费了,但”抓什么”写在三个字段里
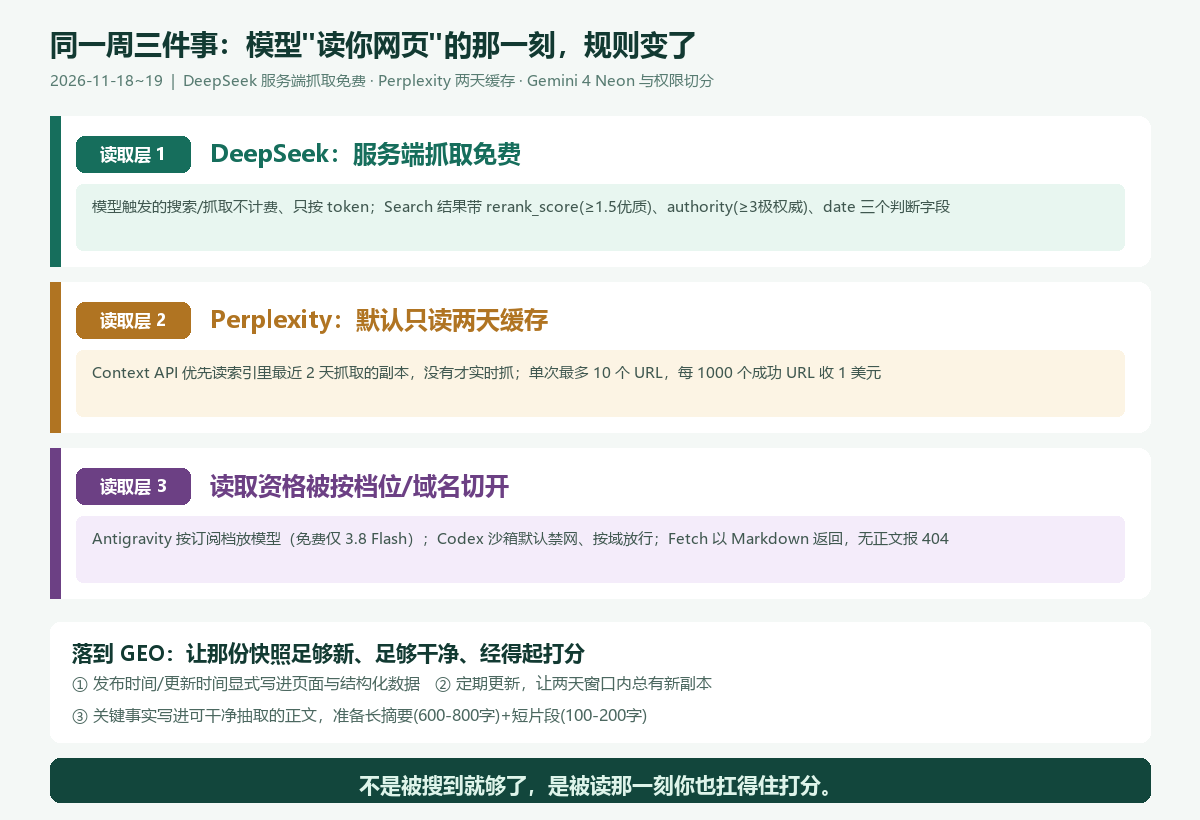
DeepSeek 官方 API 文档写明:模型通过服务端工具执行的搜索不计费(文字搜索、图片搜索与网页抓取),只有模型 Token 用量计费;服务端工具包括联网工具、Responses API 的 web_search、Claude Code 的 Web Search,以及 DeepSeek Harness 中”网页搜索提供方”设为”DeepSeek 服务端搜索”或”自动”(默认值)时的搜索。客户端直接调用 Search / Fetch API 则按每 1000 次成功请求 5 元收费,失败、无结果、超时不计费。
这条改动最直接的含义是:让模型自己去读网页的边际成本,被按下了零。调用方不必再为”要不要多搜一次、多抓一页”犹豫,模型可以更频繁地发起检索和抓取。抓取量会上来,但抓取的选择权也集中在搜索引擎手里。
那么搜索引擎凭什么选?DeepSeek 的 Search 接口返回结构把答案摆得很清楚——每条结果带三组”判断字段”:
rerank_score(0~3 分):官方文档写明它”综合考虑相关性、权威性、时效性等维度,大于等于 1.5 分为优质结果”。authority(0~4 分,−1 表示未知):官方称”大于等于 3 为极权威结果”。date:发布时间,统一为 UTC 的 RFC 3339 格式,未知时为null。
这不是推测,是接口文档里写死的字段。换句话说,在读取层,”你的内容值不值得被抓”被显式拆成了相关性 + 权威性 + 时效性三项可打分的东西。还有两个细节容易被漏掉:summary 是 600~800 字、专门”适用于给模型阅读”,snippet 只有 100~200 字、用于前端展现——同一页内容被切成两种颗粒度,分别喂给模型和给人看。Fetch 接口则把单页抓成 Markdown 正文,且明确”受目标站点的可用性和访问策略影响”,404 的含义包括”页面没有可提取的 Markdown 正文”。
把这几条连起来:成本归零带来更多抓取,而每一次抓取都用相关性、权威性、时效性打分,并且优先读你页面里那段能被干净抽成 Markdown、能写成 600~800 字摘要的部分。抓取变便宜了,但”被抓到之后长什么样”变得更关键。
二、Perplexity:默认只读”两天内抓取的副本”
Perplexity 在 11 月 18 日前后推出 Context API(官方博客由两家 AI 日报同步转述,细节一致):单次调用最多读取 10 个 URL,为每个页面返回清理后的 Markdown、HTML、链接和基于查询的片段;默认优先读取 Perplexity 网页索引中最近两天内抓取的副本,没有时再实时抓取,也可强制实时读取或只用缓存;定价为每成功获取 1000 个 URL 收 1 美元,失败的 URL 不计费。
“两天”这个窗口,是本期最值得记住的数字。它意味着在你的页面和模型之间,站着一个会过期的快照:
- 你的页面在最近两天被 Perplexity 抓过 → 模型直接读那份缓存副本,快且稳定;
- 没被抓过 → 走实时抓取,更慢,而且受目标站点可用性与访问策略影响;
- 缓存副本是旧的 → 模型读到的是两天前的你,之后发布的新内容在窗口刷新前不进 Context API。
这和 188 期的”进池”是两回事:进池讨论的是你有没有进入候选集,这里讨论的是你进入候选集之后,模型手上那份副本有多新。一个内容方最常犯的错,是把”发布完成”当成终点——在读取层的视角里,发布只是让快照有机会更新,真正的有效期是那两天的窗口。
三、Gemini 4 Neon 与权限切分:读到你,开始需要”资格”
Google 在 11 月 18 日发布 Gemini 4 Neon,定位在 Gemini 4 Carbon 与 Hydrogen 之间,面向复杂软件工程、知识工作和科学工作流;四档思维调节、100 万 token 上下文,可处理表格、PDF、图表与音视频。官方给出的定价是每百万输入 token 3 美元、输出 15 美元、缓存输入 0.15 美元;在 Artificial Analysis Intelligence Index 得 61 分、排第 3,Coding Agent Index 排第一(分数与名次来自官方发布信息,多源交叉一致)。官方还称默认 high 档位的单任务成本比 Carbon 低约 32%,并推出了网络安全版本 Gemini 4 Neon for cyber。
模型本身不是本节重点,重点是同一周围绕它的权限切分:Google 更新 Antigravity 文档后,免费、Google AI Plus 和试用档用不了 Gemini 4 系列,只剩 3.8 Flash;付费 Google AI Pro 保留 Hydrogen 和 Argon;Ultra 档才能用全部 Gemini 4 模型。OpenAI 那边,官方详解 Codex 沙箱的默认策略是禁网、按域放行。
这两件事放在一起看,读到你网页的主体,被切成了不同等级:有的账号拿到的是完整模型,有的只能拿到轻量模型;有的 agent 能联网,有的只能在白名单域名里动。“内容被读到”不再是一个统一事件,而是取决于谁在读、用什么档位读、有没有联网权限。对 GEO 的直接影响是:同一份内容在不同读取资格下会被抽出不同的颗粒度,你没法假设所有人都看到同一个版本。
四、国产模型在同一周做了同一件事:把读取成本压下去
这轮变动不是海外独有。11 月 16 日,阿里正式发布 Qwen4-Max,采用基于 Qwen 稀疏注意力(QSA)的 MoE 架构,总参数 2.4T、每 token 激活约 71B,原生视觉、百万上下文;据 SCMP 报道,平均单任务成本从上一代的 4.43 美元降到 1.67 美元,降幅约 60%。同日腾讯混元发布 Hy4 flash,总参数 224B、激活 12B、1M 上下文,每百万 token 输入 0.5 元、输出 2 元、缓存命中仅 0.02 元,并开放了指令版、FP8 量化版和预训练基座版的权重。
11 月 18 日 SuperCLUE 新一轮中文通用测评里,Qwen4-Max 61.61 分、Kimi K3.1 Pro 61.46 分、混元 Hy4 61.01 分,因相差 1 分以内视为并列国内第一。这里不把榜单排名当卖点——本期只用其中一个和读取直接相关的信号:Qwen4-Max 的幻觉控制拿到 73.61 分、居国内分榜第一,Hy4 的超长上下文 88.86 分、精确指令遵循 50.00 分均为国内第一。模型在”读得准、不瞎编、按指令办事”上继续进步,而调用成本在往下走。读取变得又便宜又挑剔,这正是读取层规则改写的底色。
五、落到 GEO:三条动作,都对着”被读那一刻”
| 读取层的规则变化 | 一手证据 | 内容方该做什么 |
|---|---|---|
| 服务端抓取成本归零,抓取按相关/权威/时效打分 | DeepSeek:服务端搜索抓取不计费;rerank_score ≥1.5 为优质、authority ≥3 为极权威、带 date 字段 |
把发布时间与更新时间显式写在页面与结构化数据里;持续积累外部权威引用,别只靠自述 |
| 默认读”两天内缓存副本” | Perplexity Context API:优先读 2 天内抓取副本,无则实时抓取,可强制实时或只用缓存 | 把”发布即完成”改成”保持快照新鲜”:定期更新关键页,让两天窗口内总有可被抓的新副本 |
| 读取资格被按档位/域名切开,正文按 Markdown 抽取 | Antigravity 按订阅档位放模型;Codex 沙箱默认禁网、按域放行;Fetch 以 Markdown 返回,抓不到正文报 404 | 关键事实写进可被干净抽取的正文,别埋进 JS 渲染或图片;同一事实准备长短两种颗粒度(摘要 600~800 字、片段 100~200 字) |
一句话收口:188 期告诉你先进池,189 期告诉你模型信你什么,这一期告诉你——它真来读你的时候,手里拿的是一份可能过期的快照,按一张写着时效性、权威性、相关性的评分表在读。你要做的,是让那份快照足够新、足够干净、而且经得起打分。
FAQ
Q:DeepSeek 抓取不收费,是不是意味着我的页面会被抓得更多、引用也更多?
不能这样推。官方文档只确认”成本归零”和”按 token 计费”,没有承诺抓取量或引用量的变化。可以合理说的是:调用方不再为多搜一次付费,模型发起检索的门槛降低;但抓不抓你,仍由 rerank_score、authority、date 这些字段说了算。便宜的是抓取动作,不是入选资格。
Q:Perplexity 的”两天缓存”,是不是我每天更新就行?
更新是必要条件,不是充分条件。窗口刷新依赖它重新抓取,而 Fetch 接口受目标站点可用性和访问策略影响(官方明确写了 403 安全策略拒绝、404 无法提取正文)。所以除了更新,还要保证页面能被正常抓取、正文能干净地抽成 Markdown。参见 24891 期讲过的”AI 爬虫分三种”:先确认你挡的是哪一种。
Q:Gemini 4 Neon 的性能数字为什么只写”多源交叉”,不说是官方原文?
因为本次抓取时 Google 官方博客与 model card 页面直连失败,我用的是两家 AI 日报同步转述、且明确指向同一官方链接的信息做交叉核对,数字一致才写进来。可核实的部分(定价、上下文、档位、名次)照写;无法从官方原文直接读回的部分,不冒充一手。这是本系列一直守的底线:宁可少写一个数字,不编一个数字。
Q:权威性能不能短期做出来?
不能速成。DeepSeek 把 authority 单列成 0~4 分字段,≥3 才是极权威,这类信号通常来自站点被外部高可信来源反复引用,而不是自己在页面里写”权威”。可操作的是长期项:被行业媒体、官方文档、第三方数据引用,并让引用关系可被抓取。短期能做的只有时效和可读性——那两项今天就能改。
Q:这期和 188、189 期怎么区分?会不会重复?
三层,互不重叠:188 是”进池”(有没有进候选集),189 是”训练”(模型怎么学会判断可信),190 是”读取”(请求发出后,抓不抓、读快照还是实时、按什么字段打分)。你完全可以只做其中一层,三层的关系是串联,不是并列。
结语
这一周的模型动态,表面是降价、发新模型、改权限,底层是读取层的三件小事:抓取的边际成本归零、默认读两天内的缓存快照、读取资格被按档位和域名切开。加上国产模型把单任务成本压低约六成、幻觉控制与长上下文继续走强,一个判断越来越清楚——GEO 的竞争正在从”写得好不好”,移到”被读那一刻,快照新不新、正文干不干净、分数扛不扛得住”。这三项都不性感,但都可核查、可改进,也都能今天动手。