175 期把 0 提及缺口落成了一页内容。写完是不是就可以高枕无忧了?大多数人会做这么个动作:过两天再问一次那个问题,看到”自己出现了”,宣布 GEO 成功。这个动作本身几乎证明不了任何事。AI 答案是流动、非确定的(Kenyon Digital 实测:同一问法 5 次,42% 的问题顶牌品牌会变),你看到的”出现了”可能只是这次采样碰巧命中。本篇讲怎么把”改完再问一次”升级成可信验收——目标组配对照组、时间窗匹配机制、多次采样,最后把结果喂回 backlog,让 173→175 的闭环真正闭上。
一、为什么”改完再问一次”证明不了任何事
三个来源都会让数字自己动:模型更新、竞品动作、引擎每次生成的随机性。你改完次日问一次,看到的”变好”里混着这三者,你分不出哪部分是你改的带来的。这就是 GEO Toolbox 反复强调的:单次前后对比证明不了任何东西,必须有一组”你没动”的问题做基准。
二、要素①:目标组 + 对照组——判读的四象限
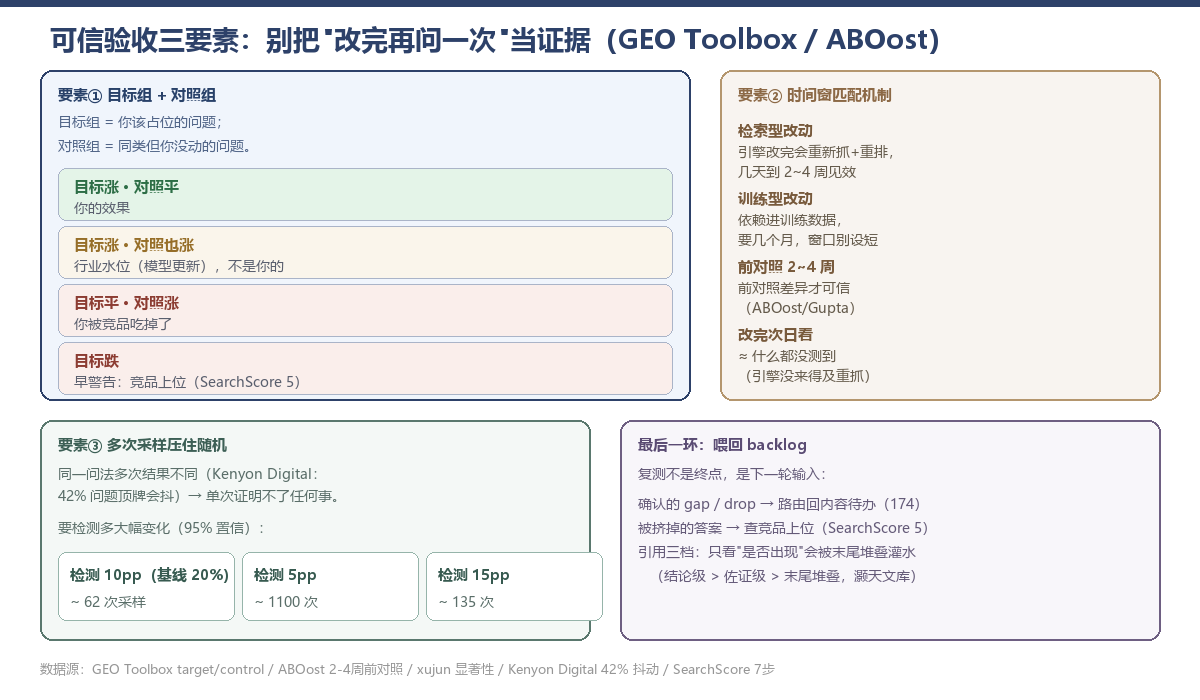
把监测问句分两组:目标组(你这次改动应该起作用的问句)和对照组(同类但你没动的问句)。模型一更新,两组会一起动;只有当目标组动、对照组不动时,信号才是干净的。四种组合对应四种结论:
| 组合 | 结论 | 下一步 |
|---|---|---|
| 目标涨 · 对照平 | ✅ 这是你的改动带来的效果 | 固化这条经验,扩到其他目标 |
| 目标涨 · 对照也涨 | 行业水位(模型更新/热点),不是你的功劳 | 别记功,等水位回落再复测 |
| 目标平 · 对照涨 | 你在被竞品吃掉 | 进 174 期”零提及抢救”查是谁上位 |
| 目标跌 | 早警告:竞品已上位(SearchScore 第 5 步) | 立即归因到内容/来源/实体三层 |
对照组要选同类但不同子主题的问句,且基线提及率跟目标组接近——否则两组起点不同,比不了。目标组、对照组要在同一天、同一引擎、同一问法、同一账号状态下采,唯一变量就是”你有没有改”。
三、要素②:时间窗必须匹配”机制”
改完看多久的效果,取决于你改的是什么(Gupta 的判断):
- 检索型改动(正文、schema、可引用数据):引擎改完会重新抓取+重排,几天到 2~4 周见效。
- 训练型改动(依赖进训练语料的):要几个月,窗口设短了等于白等。
- 确认的 gap / 目标跌的问句 → 路由回 174 期的”零提及抢救”待办
- 被挤掉的答案 → 查 172 期站外信号,看是不是竞品在生态里上位
- 引用三档里只在末尾堆叠 → 回 175 期简报,把可核验事实从长段落里提出来
- 查一次为什么不算数:被提及率的最低可行监测法——怎么测出 0 提及、采样够不够(173 期)
- 被选中的缺口,怎么落成一页 AI 能切片的内容——复测确认的 gap 回流到这(175 期)
- 同一站里,只有那几页被引用——为什么单次/单页判断会系统性偏差(138 期)
通用纪律:前对照差异要至少 2~4 周才可信(ABOost);改完第二天看 ≈ 什么都没测到,因为引擎还没来得及重抓(25015 期已讲收录 3~7 天)。
四、要素③:多次采样压住随机,还要看得懂”引用含金量”
AI 答案是概率,不是 yes/no。单次记录不可用,要每个问句多次采样取比例。要检测多大的变化,决定了要采多少次——想从 20% 基线检测 10 个百分点的变化,95% 置信大约要 62 次采样;检测 5 个百分点要约 1100 次。
另外,”被引用”要分档(灏天文库):结论级引用 > 佐证级 > 末尾堆叠。只统计”是否出现”的团队,数字常被末尾堆叠灌水——被堆在来源列表末尾的”被引用”,商业价值约等于 0。验收时按档拆着看,才不会被虚高数字骗。
五、最后一环:把结果喂回 backlog,闭环才闭上
复测的产出不是一张漂亮的曲线,而是下一轮的输入(SearchScore 第 7 步”feed results back into work”):
做到这一步,”监测→抢救→生产→复测”四步才真正闭合。没喂回 backlog 的复测,只是一次性报告,不构成运营系统。
FAQ
Q:和 173 期”最低可行监测”什么关系?
A:173 解决”怎么测出 0 提及、采样够不够”;本篇解决”测完之后怎么判断这次改动是不是真有用“(目标/对照/时间窗/喂回)。173 是测法,本篇是验收判读,是 173 的下游。
Q:没有对照组怎么办?
A:对照组是可信验收的最低要求。退一步,至少固定竞品同框数据做基准——竞品没动的窗口里你动了,信号才干净(ABOost 时间窗对照)。完全没有对照、只靠”改前后各问一次”,结论只能当方向参考,不能当”证明”。
Q:采样次数到底定多少?
A:取决于你想检测多小的变化。基线 20%、想检测 10pp 变化 ≈ 62 次/问句(xujun 公式 n≈Z²·p(1-p)/d²)。小样本先当”探索性”信号,别宣布胜利;想下结论就上足次数或拉长窗口。
Q:改了 schema 第二天没变化,是不是白做?
A:几乎必然没白做也没见效——引擎按自己的节奏重抓重排(25015 收录 3~7 天)。窗口设太短是复测最常见的失误。检索型改动给足 2~4 周再判读。
延伸阅读
单次证明不了任何事。 目标组、对照组、时间窗,缺一不可。
{
“@context”: “https://schema.org”,
“graph”: [
{
“@type”: “Organization”,
“@id”: “https://www.geoshizhan.com/#org”,
“name”: “GEO实战”,
“url”: “https://www.geoshizhan.com/”
},
{
“@type”: “WebSite”,
“@id”: “https://www.geoshizhan.com/#website”,
“url”: “https://www.geoshizhan.com/”,
“publisher”: {
“@id”: “https://www.geoshizhan.com/#org”
}
},
{
“@type”: “Article”,
“headline”: “怎么证明这次改动有用:目标组、对照组与时间窗”,
“description”: “改完就再问一次 AI、看到自己出现就宣布成功——这是最常见的错误。AI 答案非确定性,单次前后对比证明不了任何事:模型一更新两组都在动,你分不清是你的改动还是行业水位。可信的验收要三件事:目标组配一组\”同类但你没动\”的对照组、时间窗匹配机制(检索型几天、训练型数月,前对照至少 2~4 周)、多次采样压住随机。只有\”目标涨、对照平\”才算你的效果。”,
“datePublished”: “2026-11-09”,
“dateModified”: “2026-11-09”,
“author”: {
“@type”: “Organization”,
“name”: “GEO实战”
},
“publisher”: {
“@id”: “https://www.geoshizhan.com/#org”
},
“image”: “https://www.geoshizhan.com/wp-content/uploads/2026/11/geo_176_cover.png”,
“mainEntityOfPage”: “https://www.geoshizhan.com/geo-retest-prove-change-target-control-window-2026/”,
“isPartOf”: {
“@id”: “https://www.geoshizhan.com/#website”
}
},
{
“@type”: “FAQPage”,
“mainEntity”: [
{
“@type”: “Question”,
“name”: “和173期最低可行监测什么关系?”,
“acceptedAnswer”: {
“@type”: “Answer”,
“text”: “173解决怎么测出0提及、采样够不够;本篇解决测完之后怎么判断这次改动是否真有用(目标/对照/时间窗/喂回)。173是测法,本篇是验收判读,是173的下游。”
}
},
{
“@type”: “Question”,
“name”: “没有对照组怎么办?”,
“acceptedAnswer”: {
“@type”: “Answer”,
“text”: “对照组是可信验收的最低要求。退一步至少固定竞品同框数据做基准——竞品没动的窗口里你动了,信号才干净。完全没有对照、只靠改前后各问一次,结论只能当方向参考,不能当证明。”
}
},
{
“@type”: “Question”,
“name”: “采样次数到底定多少?”,
“acceptedAnswer”: {
“@type”: “Answer”,
“text”: “取决于你想检测多小的变化。基线20%、检测10pp变化约需62次/问句。小样本先当探索性信号,别宣布胜利;想下结论就上足次数或拉长窗口。”
}
},
{
“@type”: “Question”,
“name”: “改了schema第二天没变化,是不是白做?”,
“acceptedAnswer”: {
“@type”: “Answer”,
“text”: “几乎必然没白做也没见效——引擎按自己的节奏重抓重排(25015收录3~7天)。窗口设太短是复测最常见的失误。检索型改动给足2~4周再判读。”
}
}
]
}
]
}