一个做工业设备的朋友跟我吐槽:公司养着三个客服,每天回上百条消息,回完就沉在聊天记录里,一年后全清掉。
我说你们把最值钱的东西当垃圾处理了。
因为客服每天回答的那些问题——「这个能用在什么场景」「跟另一款有什么区别」「装的时候要注意什么」——恰好就是用户在 AI 里问的问题。而且是最真实的那一版问法,不是关键词,是人话。
为什么客服记录是被低估最狠的一份素材
做 GEO 的人一般会去找关键词工具、看搜索下拉词、扒竞品的 FAQ。这些都没错,但它们都是「猜用户在问什么」。
客服记录不一样,它是「用户已经问过了」。这是唯一一份自带真实语境、真实口语、真实决策顾虑的素材。
而且有几个数据可以印证它的价值:结构清晰的问答型页面,平均停留时长通常比普通产品目录页高 20% 到 45%;在 B 端站点,把采购和技术问题覆盖到位之后,询盘转化率一般能提升 10% 到 25%。
最关键的是成本。这份素材你已经付过工资了,剩下的只是整理的工作量。
但客服原话不能直接发出去,三个原因
第一,它依赖上下文。「你要是三相电的话得提前说」这句话,脱离前一句就没有主语。AI 检索时是分片抓取的,一段话单独被拎出来必须还能读懂。
第二,口径不统一。同一个东西,客服 A 叫「过载保护」,客服 B 叫「过流切断」,客服 C 说「会自动断电」。三种说法在 AI 眼里是三个概念,反而会让它怀疑你的信息可靠性。
第三,带隐私和内部信息。报价空间、客户名称、内部流程、渠道折扣,这些直接复制粘贴出去是事故。
五步清洗法
这套流程我在几个项目里跑过,不复杂,但每一步都不能省。
- 先挑,不要全整理。导出过去 3 到 6 个月的客服和销售对话,按出现频率排序。判断优先级用四个维度:业务价值、出现频率、解释难度、可公开程度。前 20 到 30 个高频问题,就是你的核心素材池。想省事的话,把选题这一层做扎实就够用很久了,具体怎么搭问题池可以看这一篇。
- 分类,按问题类型而不是按时间。先按产品线分,再按应用场景分,最后按问题的性质归类:是什么、适不适合、多少钱、怎么用、出问题怎么办。分类的目的不是好看,是让 AI 检索时能看清你的知识结构。
- 拆件,把一句话改成四个部件。这是最关键的一步,后面配图会详细展开。
- 统一口径。一个概念只留一个说法。所有问答都必须和你的品牌事实基准保持一致——成立时间、服务范围、核心数据,一个版本,全网锁死。
- 给每条绑来源。能核验的出处:官网服务页、产品说明、资质页面、公开报道。没有来源的表述要降级成经验建议,不能写成确定承诺。这一步决定了 AI 敢不敢引用你。
核心动作:把一条口语回复拆成四个部件
客服话术和可引用语料的根本差别,在于前者靠上下文成立,后者必须能独立站住。我的做法是固定拆成四块:前置条件、直接结论、依据来源、适用边界。
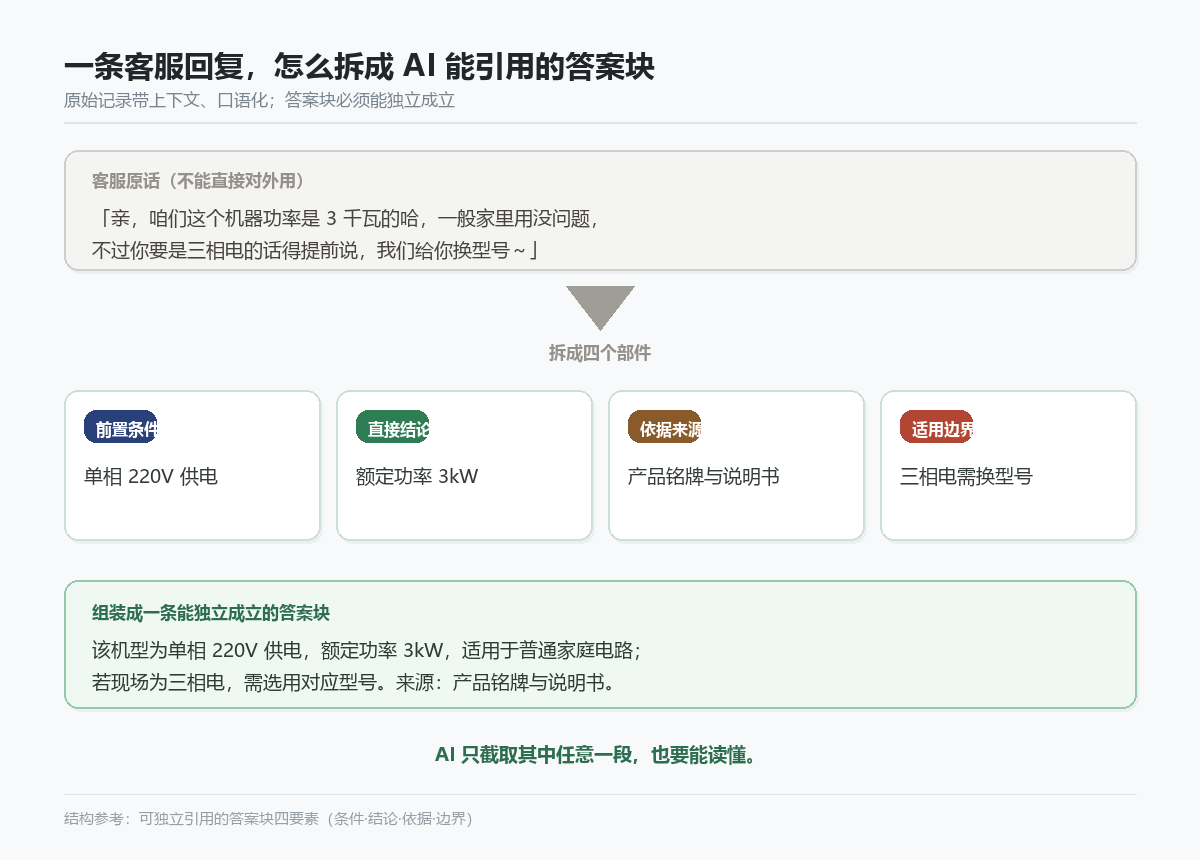
这四块凑齐之后有个直接好处:AI 就算只截取其中一段,也不会读错。只截到结论,信息是准确的;只截到边界,也仍然是有效信息。而一段带语气词的客服原话被截断,结果往往是误导。
改写前后对照
光讲原则太虚,直接看三组对照:
| 客服原话 | 问题在哪 | 改写后 |
|---|---|---|
| 「我们可以做 AI 搜索优化」 | 没有信息量,无法核验 | 「企业可通过 AI 可见度诊断、品牌语料库建设、官网内容改造、外部信源补充和持续复测,提升品牌在 AI 问答中的可理解性」 |
| 「这个一般家里用没问题」 | 没有边界,说了等于没说 | 「单相 220V 供电、额定功率 3kW,适用于普通家庭电路;三相电需换型号」 |
| 「价格看你要多少」 | 没有锚点,无法用于决策 | 「标准配置区间 2.8 万到 4.2 万;差异主要来自定制件数量与交付周期」 |
| 「放心,质量特别好」 | 纯形容词,AI 会打折 | 「整机质保 24 个月;核心部件通过 ISO9001:2015 体系认证」 |
规律很明显:把形容词换成事实,把无边界换成有边界。这件事为什么这么重要,我在内容被当广告过滤那篇里拆过,这里不重复。
一条问题,其实能拆出八条
很多人整理问答时是一问一答,一条对一条。这太浪费了。一个真实问题通常可以扩成 3 到 8 个切片:现象是什么、可能的三个原因、怎么一步步排查、要换哪个部件、平时怎么预防、有哪些安全注意。
覆盖面上有个起步标准可以参考:按用户决策阶段分四类——认知(这是什么)、选型(适合我吗)、决策(靠谱吗)、使用(怎么用),每个阶段先覆盖 3 到 5 条核心问题,总计 15 到 20 条起步,随着业务发展再扩到 50 到 100 条。
注意别为了凑数堆问题。AI 通过语义分析能判断一个问题是真有人问,还是你为了让页面热闹硬编出来的。
公开版和内部版,一定要分开
内部版给客服用来解答问题,什么都能写;公开版要脱敏、标准化,发在官网的核心位置,也可以拆成多篇独立短文对外分发。
而且它得活着。产品迭代、政策调整之后,问答库要同步改。我见过最典型的反面案例:客户产品去年换了三代,官网 FAQ 还写着第一代的参数,AI 引用之后直接给出错误答案,用户按错的参数下单,最后是品牌背锅。
四个常见错误
- 问题堆砌。上百条低价值问题,把真正重要的那条淹没了。宁可 20 条精细,不要 200 条凑数。
- 答案里全是营销话术。通篇广告、缺少客观事实,这类答案 AI 会直接降权。
- 长期不更新。这是最致命的,因为它直接产出错误信息。
- 把客服对话原样复制粘贴。口语化严重、口径混乱,前后两条互相打架。这类内容在 AI 眼里不是「信息」,是「噪音」。
最后回答几个问题
问:客服记录的隐私问题怎么处理?
两步:第一,整理时只保留「问题本身」,删掉客户名称、联系方式、订单号、报价细节;第二,公开版只讲产品和服务本身,不出现具体客户信息。涉及行业敏感内容的,宁可整条不用。
问:整理问答库大概要多少工作量?
以 20 条核心问答为例,一个人认真做大概两到三天,其中大部分时间花在「和业务确认口径」上,而不是打字。后面每季度更新一次,每次半天到一天。
问:问答库放在官网哪里比较好?
两个位置都放:一个集中的问答中心页面,以及把最核心的几条嵌到对应的产品页和服务页里。集中页负责被整体抓取,散落在各页的负责在具体场景里被命中。
问:自己整理的问答,AI 会引用吗?
会,前提是它能被独立理解、有事实支撑、并且你的官网本身可被正常抓取。这也是为什么问答库只是第一步——它提供的是「可信内容」,还需要外部信源来交叉验证,这两件事得一起做,具体可以看高权重信源的投放层次。
整理客服记录这件事,最难的地方不在技术。
在于承认一个事实:你公司最懂客户的,可能是每天回消息的那个人,而不是写文案的那个人。把他的话整理出来,比请人重新编一套话术,准确得多。
今天就能做的一件事:随便挑 5 条客服回复,问自己一个问题——如果只截取中间那半句,读者还能看懂吗?看不懂的,就值得改。