上周有人在 AI 里搜他们公司的名字,AI 提到了他们,团队还挺高兴。这周换了个人再搜同一个问题,结果什么都没有——翻了两三遍,连品牌名都没出现。
于是内部开始复盘:是不是文章改坏了?是不是被降权了?是不是要重新做一轮?
先别急着改。AI 的引用本来就不稳,这不是你们做错了什么,而是这一层检索机制的正常状态。
先看数据:引用到底有多不稳
2026 年 10 月的几份大样本研究,给出了很具体的数字:
- 连续两次问完全相同的问题,被引用的网址只有约 四分之一会重复出现;把颗粒度放到域名一级,也只有三成上下。
- 不同引擎之间的重合更低。一份追踪了 11.6 万条引用的研究显示,ChatGPT 与 Gemini 的来源重合度大约只有 5%,任意两个引擎之间都不超过 13%。
- 在 40 天的观察窗口里,有 56% 的被引域名只出现过一次。
注意,这三条讲的都是”运气”的部分。它们解释了一件事:单次检测的结果,本身就不该被当成绩单。
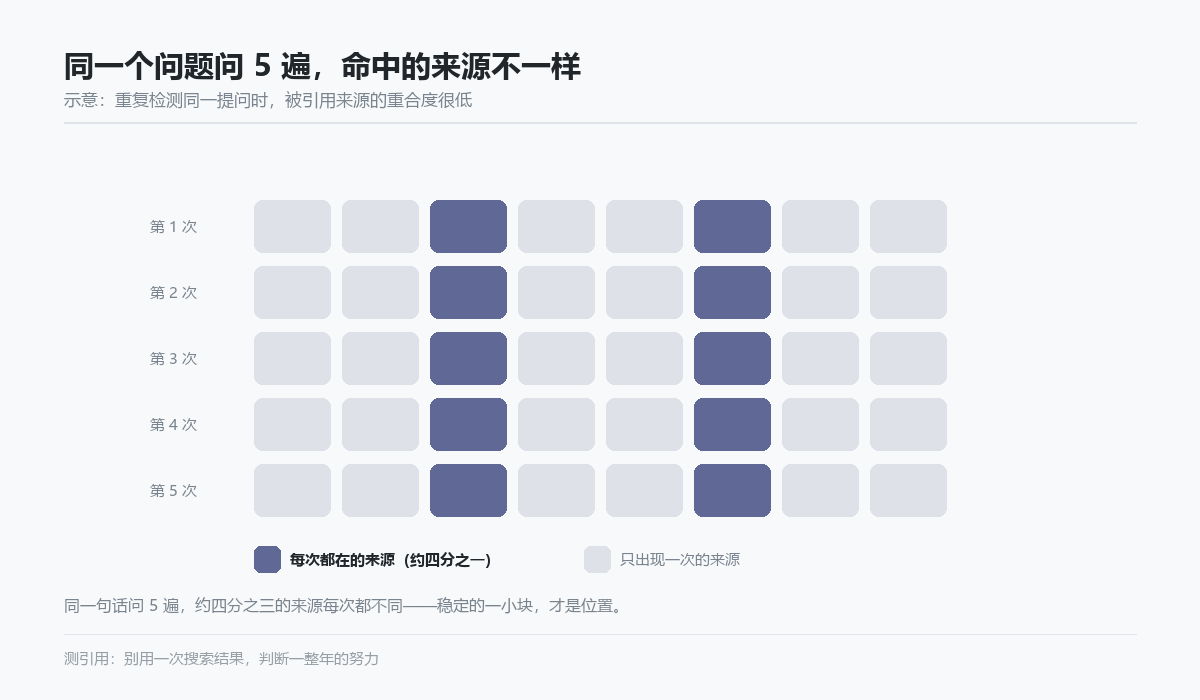
问 5 遍,命中的来源不一样
把这件事画出来更直观。同一个问题问 5 次,8 个来源位里每次都出现的那两块,才是有稳定位置的:
为什么会这样:三个「抖动源」
| 抖动源 | 它怎么造成差异 | 你该怎么做 |
|---|---|---|
| 检索本身有随机性 | 同一句话,每次取到的候选片段略有不同 | 把每个小节写成能独立摘取的答案段 |
| 各引擎查的不是同一个库 | ChatGPT 偏 Bing 索引、Claude 走 Brave、Perplexity 偏新鲜、Google 用自家索引 | 主力引擎分别测,别用一个平台的结果下结论 |
| 语料与权重持续变动 | 新内容不断入库,部分平台大幅下调了社区类内容的权重 | 保持更新节奏,别发完就停 |
三个原因叠在一起,就出现了「上周有、这周没有」的体验。它不代表你的内容变差了,只代表这一次检索没有选中你。
别把「被引用」当成单次结果来测
既然单次结果不可靠,检测方法就得跟着改:
| 不靠谱的测法 | 更靠谱的测法 |
|---|---|
| 搜一次没看到自己,就判定 GEO 失败 | 同一问题换措辞、换引擎、隔几天各测一次,看趋势 |
| 只用一个关键词代表全部 | 用一组真实提问,包含口语化的长句 |
| 只测自家品牌词 | 品牌词、品类词、场景词分开测 |
| 截图一次就下结论 | 记录来源清单,做周度对比 |
| 被提到就算成功 | 再看引用质量:有没有提到品牌名、说没说对、有没有链接 |
把「稳定」当成目标
看这幅图还有一层意思:稳定不是”每次都排第一”,而是成为那一小块每次都出现的来源。怎么做到?三件事最实在:
- 做唯一的出处:把你的独家数据、真实案例、具体价格写在只有你能写的地方,别人没法替代。
- 把答案写标准:同一件事,官网、简介、各平台的表述保持一致,让不同引擎检索到的都是同一个版本。
- 让多类页面都提到你:自己的站、行业媒体、社区讨论、视频说明——被引用的面越宽,某一处掉下去也不会整体消失。
还有一条给中小站点打气的数据:有统计显示,约三成被 ChatGPT 高频引用的页面,在 Google 自然结果里没有任何排名。也就是说,AI 这一层的引用面,比传统排名宽得多。
发布前的自查清单
- 有没有一份固定的 10~20 条真实提问清单,用来长期跟踪;
- 每次检测是否记录了来源列表,而不只是”有没有我”;
- 是否至少覆盖三个主力引擎;
- 检测频率是否固定(比如每周同一时间);
- 是否区分了”被提到”和”被引用”两件事;
- 看结果时,看的是趋势还是单次。
常见问题
那是不是说明 GEO 全靠运气
不是。随机的是具体哪一条来源进入答案,不是「有没有资格进入」。有的内容每次都在候选池里,只是偶尔没被选中;有的内容从来没进过池。前者是概率问题,后者是资格问题——GEO 要解决的是后者。
多久测一次比较合理
每周固定一次就够了,关键是一直用同一套提问、同一批引擎。测得太勤反而容易焦虑:单次波动说明不了什么,连续几周的趋势才说明问题。
行业词每次都被同行占着,还有机会吗
有。研究里有一个反直觉的结论:约三成被 ChatGPT 高频引用的页面,在 Google 自然结果里根本没有排名。这说明 AI 的引用面比传统排名宽得多,尤其是那些「只有内行才问得出来」的长尾问题。
AI 提到了我们,但说错了,算被引用吗
算,但要区分两类:被提到(出现品牌名)和被引用(把你作为来源)。提到但说错,说明它读到的是别人对你的描述——这时候要补的是「事实名片」(名称、定位、数字全网统一),而不是写更多文章。
延伸阅读
不要用一次搜索的截图,判断一整年的努力。稳定,才是引用真正的形状。
《同一个问题问两遍,AI 为什么给出不同答案?》有一个想法