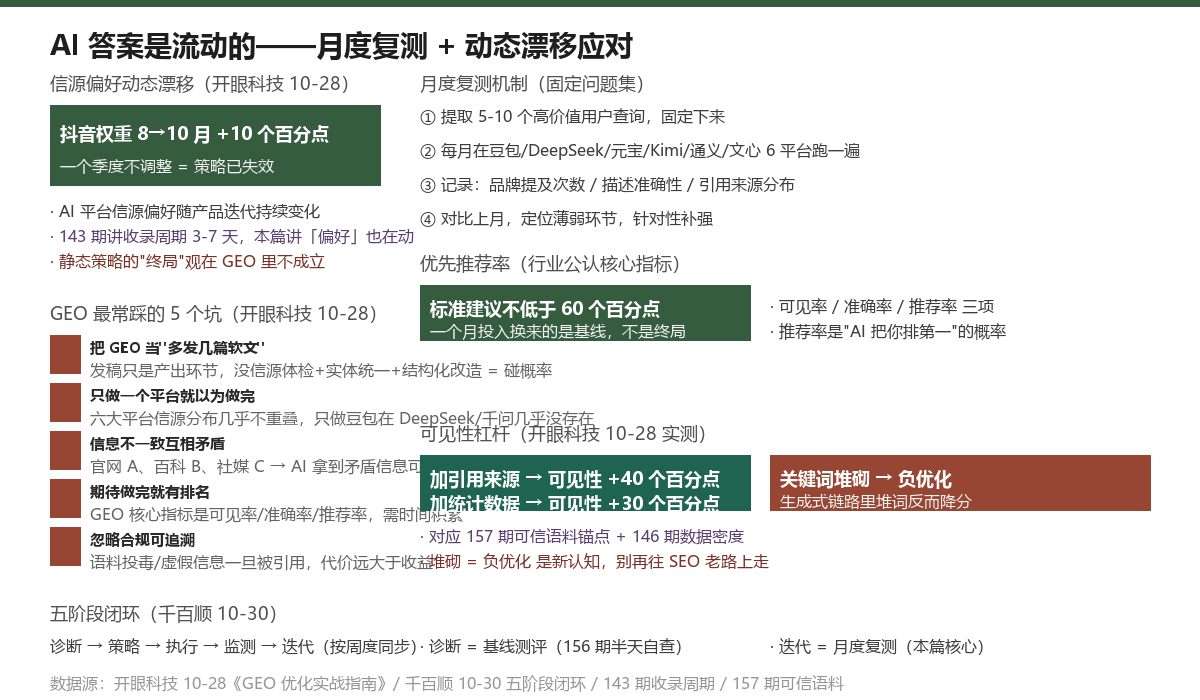
开眼科技 10 月 28 日那篇《GEO 优化实战指南:2026 年 AI 搜索的 6 大信源与 7 个落地动作》把一件常被忽略的事说透了:AI 平台信源偏好会随产品迭代持续漂移——抖音权重在 8 月到 10 月之间就提升了 10 个百分点。一个季度不调整策略,等于策略已经失效。
这意味着 GEO 没有”做完”这个状态,只有”月度复测”。158 期讲六平台口味矩阵(怎么分发),本篇把重心挪到后半程——怎么持续监测、怎么避坑、怎么动态调整。核心指标是”优先推荐率”,行业公认标准建议不低于 60 个百分点。
为什么”做完”在 GEO 里不成立
传统 SEO 有”做完”感:排名到了就稳了。GEO 没有——AI 的答案是流动的,信源偏好是动态的。143 期讲收录周期从分钟级拉长到 3 到 7 天,那期讲的是”进入候选池的速度在变慢”;本篇讲的是”进池之后,你在答案里的位置也在持续漂移”。两者叠加:既难进,进去还会被换掉。
开眼科技那篇里有个数据点:加引用来源可使内容在 AI 回答中可见性提升约 40 个百分点,加统计数据提升约 30 个百分点,而关键词堆砌在生成式链路里反而是负优化。这是 146 期数据密度铁律的量化延伸——密度是正杠杆,堆砌是负杠杆,两者方向相反。
月度复测机制:固定问题集
| 步骤 | 做什么 | 记录什么 |
|---|---|---|
| ① 建固定问题集 | 提取 5 到 10 个高价值用户查询,固定不变 | 问题原文(口径可回溯,158 期) |
| ② 每月 6 平台跑一遍 | 豆包/DeepSeek/元宝/Kimi/通义/文心 各问一遍 | 平台名 + 时间戳 + 原始回答 |
| ③ 记录三项指标 | 品牌提及次数 / 描述准确性 / 引用来源分布 | 可见率、准确率、推荐率 |
| ④ 对比上月 | 定位薄弱环节,针对性补强 | 哪类 Query 掉出了答案,补哪类信源 |
月度复测的目标不是打分,是定位”哪类 Query 在哪个月掉出了答案”。143 期讲收录延迟,本篇讲”进池之后被换出”——两者一起构成完整的动态监测。
优先推荐率:行业公认核心指标
开眼科技那篇明确:“优先推荐率”是行业公认的量化评估核心指标,标准建议不低于 60 个百分点。三个指标的关系:可见率(AI 提到你了)> 准确率(AI 说得对)> 推荐率(AI 把你排第一)。一个月投入换来的是基线,不是终局——推荐率需要时间积累,不能期待做完就有排名。
GEO 最常踩的 5 个坑
| 坑 | 表现 | 后果 |
|---|---|---|
| 坑 1 · 把 GEO 当多发软文 | 发稿只是产出环节,没做信源体检 + 实体统一 + 结构化改造 | 发再多稿只是碰概率 |
| 坑 2 · 只做一个平台 | 只做豆包,在 DeepSeek/千问几乎没存在感 | 六大平台信源分布几乎不重叠 |
| 坑 3 · 信息不一致 | 官网 A、百科 B、社媒 C | AI 拿到矛盾信息可能说错或干脆不提(156 期实体档案 L3) |
| 坑 4 · 期待做完就有排名 | 把推荐率当成一次性能拿到的 KPI | 推荐率需时间积累,标准建议 60 个百分点是长线目标 |
| 坑 5 · 忽略合规可追溯 | 语料投毒、虚假信息被引用 | 代价远大于收益(158 期黑帽四形态) |
五阶段闭环:诊断—策略—执行—监测—迭代
千百顺 10 月 30 日把服务模式总结为五阶段闭环,按周度同步项目进展:诊断(基线测评)→ 策略(话题布局)→ 执行(知识图谱 + 结构化内容 + 多平台发布)→ 监测(各平台引用数据追踪)→ 迭代(依据数据调整策略)。本篇的月度复测对应”监测”和”迭代”两步——156 期半天基线自查对应”诊断”。
五阶段闭环和月度复测的区别:闭环是流程框架(从诊断到迭代的完整链路),月度复测是执行节奏(多久跑一遍固定问题集)。两者配合:按五阶段做流程,按月度复测定节奏。
和 143/158 的划界
| 篇 | 讲什么 | 时间维度 |
|---|---|---|
| 143 期 | 收录周期从分钟级拉到 3-7 天(进池速度) | 一次性 |
| 158 期 | 六平台口味矩阵 + 一次生产多端适配(分发结构) | 一次性 |
| 本篇(159) | 月度复测机制 + 动态漂移 + 优先推荐率 60(持续监测) | 持续性 |
FAQ
Q:月度复测的问题集怎么选?
A:选 5 到 10 个最贴近真实用户决策的查询,比如”XX 哪家好””XX 多少钱””XX 怎么选”。固定不变,每月问同一组,才能看出趋势。问题集要按 138 期”高价值业务查询”原则选——能带来转化的那几个,不是随便找的。
Q:优先推荐率 60 个百分点是硬指标吗?
A:是行业标准建议值,不是平台强制要求。它反映的是”AI 把你排第一的概率”——低于 60 说明你的内容被引用了,但排不到最前面。高于 60 说明你的内容在多数 Query 里都是首选答案。新做的品牌一开始到不了 60,目标是持续往 60 靠。
Q:关键词堆砌为什么是负优化?
A:生成式链路里,关键词堆砌降低语义信噪比——模型读到的”信息”被重复词稀释,判断你”信息密度低”。146 期讲密度是正杠杆(15 个数据点 +41 个百分点),但前提是”不同”的数据点,不是同一关键词重复 15 遍。堆砌 = 密度虚高 = 实际信息增益为零 = 负优化。
Q:信源偏好漂移怎么提前感知?
A:两条路——① 月度复测数据:引用来源分布从 A 平台向 B 平台偏移,说明信源权重在变(如抖音 8-10 月 +10 个百分点)。② 关注各平台 changelog:DeepSeek 10-17 开放了 authority/rerank 字段,Kimi 回退引用源到 2025 前(158 期),这些都是漂移信号。两条路结合,比单纯等复测结果快。
延伸阅读
- 六个平台六种”口味”:一次生产,多端适配,怎么落?——六平台口味矩阵(158 期)
- 收录从分钟级变 3 到 7 天,抢首发为什么失效了——收录周期变化(143 期)
- 幻觉率 8.3 个百分点的模型,凭什么”只认”你说的那句?——可信语料三轴(157 期)
GEO 没有”做完”,只有”复测”。 固定问题集每月跑一遍, 推荐率往 60 个百分点靠, 信源偏好漂移了,策略就得跟着动。
{
“@context”: “https://schema.org”,
“graph”: [
{
“@type”: “Organization”,
“@id”: “https://www.geoshizhan.com/#org”,
“name”: “GEO实战”,
“url”: “https://www.geoshizhan.com/”
},
{
“@type”: “WebSite”,
“@id”: “https://www.geoshizhan.com/#website”,
“url”: “https://www.geoshizhan.com/”,
“publisher”: {
“@id”: “https://www.geoshizhan.com/#org”
}
},
{
“@type”: “Article”,
“headline”: “AI 的答案是流动的:GEO 没有\”做完\”,只有\”复测\””,
“description”: “开眼科技 10 月 28 日那篇实战指南把一件常被忽略的事说透了:AI 平台信源偏好会随产品迭代持续漂移,抖音权重在 8 月到 10 月之间就提升了 10 个百分点。一个季度不调整策略,等于策略已经失效。GEO 没有\”做完\”这个状态,只有\”月度复测\”。优先推荐率是行业公认核心指标,标准建议不低于 60 个百分点;关键词堆砌在生成式链路里反而是负优化,加引用来源提升可见性约 40 个百分点,加统计数据约 30 个百分点。本篇把\”怎么复测 + 怎么避坑 + 怎么动态调整\”做成可操作机制。”,
“datePublished”: “2026-10-31”,
“dateModified”: “2026-10-31”,
“author”: {
“@type”: “Organization”,
“name”: “GEO实战”
},
“publisher”: {
“@id”: “https://www.geoshizhan.com/#org”
},
“image”: “https://www.geoshizhan.com/wp-content/uploads/2026/10/geo_159_cover.png”,
“mainEntityOfPage”: “https://www.geoshizhan.com/geo-monthly-recalibration-no-final-state-2026/”,
“isPartOf”: {
“@id”: “https://www.geoshizhan.com/#website”
}
},
{
“@type”: “FAQPage”,
“mainEntity”: [
{
“@type”: “Question”,
“name”: “月度复测的问题集怎么选?”,
“acceptedAnswer”: {
“@type”: “Answer”,
“text”: “选 5 到 10 个最贴近真实用户决策的查询,比如\”XX 哪家好\”\”XX 多少钱\”\”XX 怎么选\”。固定不变,每月问同一组才能看出趋势。按 138 期\”高价值业务查询\”原则选——能带来转化的那几个。”
}
},
{
“@type”: “Question”,
“name”: “优先推荐率 60 个百分点是硬指标吗?”,
“acceptedAnswer”: {
“@type”: “Answer”,
“text”: “是行业标准建议值,不是平台强制要求。它反映\”AI 把你排第一的概率\”。低于 60 说明被引用了但排不到最前面,高于 60 说明在多数 Query 里都是首选答案。新品牌一开始到不了 60,目标是持续往 60 靠。”
}
},
{
“@type”: “Question”,
“name”: “关键词堆砌为什么是负优化?”,
“acceptedAnswer”: {
“@type”: “Answer”,
“text”: “堆砌降低语义信噪比,模型判断你信息密度低。146 期密度是正杠杆(15 数据点 +41 个百分点),但前提是不同数据点,不是同一关键词重复 15 遍。堆砌 = 密度虚高 = 实际信息增益为零 = 负优化。”
}
},
{
“@type”: “Question”,
“name”: “信源偏好漂移怎么提前感知?”,
“acceptedAnswer”: {
“@type”: “Answer”,
“text”: “两条路:① 月度复测数据——引用来源分布从 A 平台向 B 平台偏移,说明信源权重在变。② 关注各平台 changelog——DeepSeek 开放 authority/rerank 字段、Kimi 回退引用源到 2025 前,都是漂移信号。两条路结合比单纯等复测快。”
}
}
]
}
]
}