10 月 30 日一天之内,Google、微软、OpenAI、Anthropic 同日宣布:将共同支持 robots.txt 里的一个统一政策令牌 __usage_ai-training。网站写一次,就能向四家同时表达「我的内容不用于生成式模型训练」,不用再逐家认爬虫、逐家写规则。听上去是好事——但对靠「被 AI 引用」吃饭的 GEO 站,这一行的真正风险在别处:训练(training)和 grounding(回答时引用网页)是两件事,而三家对这一行的解读不一样。在 Google 那边,你只写训练退出、不单独声明 Google-Extended,它会视同你把 Google-Extended 也禁了——连带 Gemini 应用里的 grounding 引用一起没;微软那边却把两个开关拆开,默认放行引用。同样一行字,一边退掉引用,一边留着引用。本篇拆这一行怎么写、三个坑在哪、三家差异与三类站分别该不该写。
一、这一行到底是什么:政策令牌,不是爬虫名
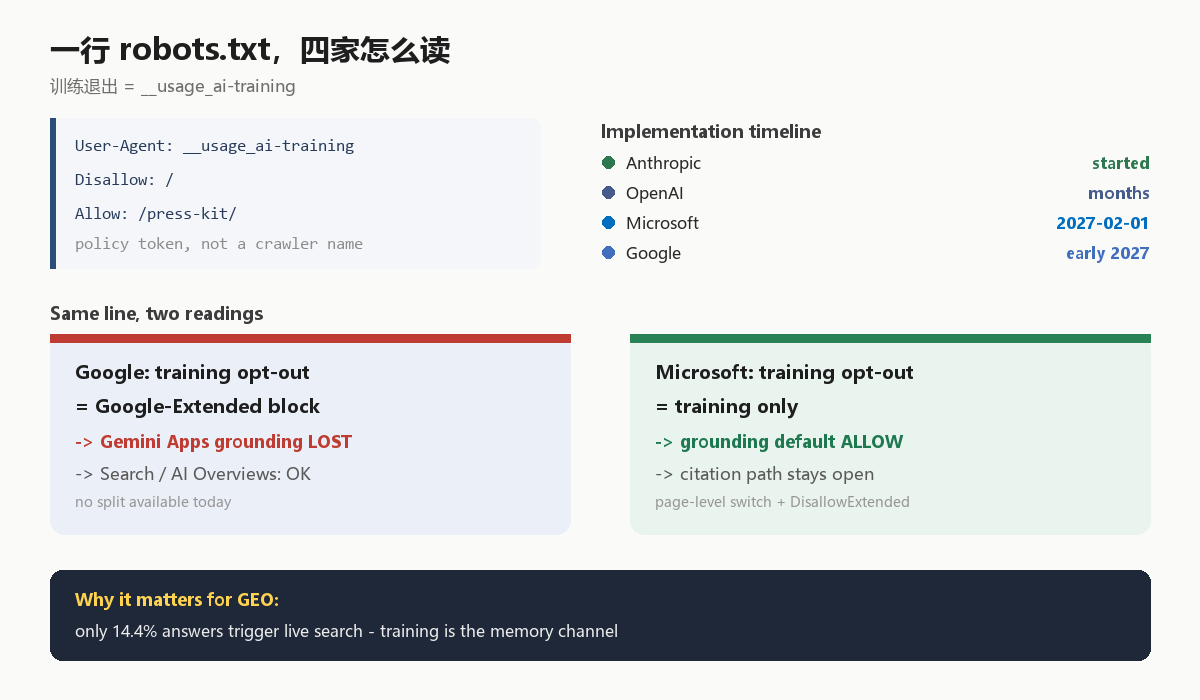
信号源头是 Anthropic 的 Kevin Kelley 向 IETF AIPREF 工作组提交的个人草案 draft-kelley-aipref-training-preference-signal-00,10 月 30 日与四家公告同日发布(10 页,2027 年 5 月 3 日到期,个人提交、未获 IETF 背书)。它不引入任何新语法,用的就是 RFC 9309 既有的 robots.txt 规则组,只是 User-Agent 一行填的不是爬虫名,而是一个政策令牌:
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
草案对「训练」的定义很窄:用内容去修改生成式 AI 模型的可学习参数;分类、排序这类非生成式系统不在范围内。三条性质决定它的边界:它是用途偏好不是抓取指令(想挡抓取仍要按爬虫名写 Disallow);它是自愿性的(私下协议可覆盖,无强制执行);它只面向未来(已被抓走、已进训练集的内容不受影响)。对 GEO 站来说,要害是第一段里那个「grounding」——训练和引用,在这一行里的拆法,三家完全不同。
二、三个坑:写错等于没写,写对可能写多
通读草案与四家实现说明,三个坑按踩中概率排:
| 坑 | 实际后果 | 正确做法 |
|---|---|---|
| 通配组不匹配令牌 | 已有的 User-Agent: * 规则不等于表态;没有单独写 __usage_ai-training 组,就等于没表达偏好 | 单独写一个该令牌的规则组,写完访问 /robots.txt 回读确认 |
| 把训练退出当抓取封锁 | 令牌不控制抓取;真正挡爬取的还得按 GPTBot/ClaudeBot 等名字写,两件事混在一起最容易误伤收录 | 抓取规则和用途偏好分两组写,别指望一行管两件事 |
| 没意识到不溯及历史 | 已抓取、已进训练集的内容不受影响,写完当天下架内容也回不去 | 把它当「面向未来的立场声明」,不当「删除键」 |
第四个坑不在写法在语义:这一行在 Google 和微软那里,管的根本不是同一件事。下面那张表是本篇的核心。
三、同一条线,三种读法:训练与引用的拆法
| 厂商 | 何时开始执行 | 对「引用(grounding)」的连带影响 |
|---|---|---|
| Anthropic | 已开始实施,未给全面落地日期 | 现有 ClaudeBot / Claude-User / Claude-SearchBot 控制继续有效 |
| OpenAI | 未来几个月内 | 现有控制继续有效;GPTBot(训练)与 OAI-SearchBot(搜索引用)本就分开 |
| 微软 | 2027-02-01 起抓取时执行 | 两个开关拆开:训练可退、grounding 默认放行可留;grounding 页面级另有 Disallow / DisallowExtended;2027-03-01 起停读 NoArchive / NoCache(2026-12-15 起 Bing 站长工具先开临时设置) |
| 2027 年初(爬虫文档口径) | 会连坐:写了共享退出、没单独写 Google-Extended,视同禁用 Google-Extended——连带 Gemini 应用与 Vertex AI 的 grounding 一起退;Google 搜索收录、AI Overviews / AI Mode 不受这一行影响(那两个另有 Search Console 开关) |
把这张表竖着读,结论只有一句:同样表达「不训练」,谷歌这边可能顺手把「可引用」也关了,微软这边引用默认还开着。想被 Gemini 应用引用,Google 那边不能只写共享令牌,还得想清楚 Google-Extended 要不要单独放行(Google 目前的文档里,没有「只禁训练、保留 Gemini 应用 grounding」的分档写法)。
四、对 GEO 意味着什么:退出训练,长期退的是「记忆型引用」
为什么对做「被 AI 引用」的站,这一行不是纯合规题:Ahrefs 6660 万条登出态响应里,只有 14.4% 的答案触发了联网检索——绝大多数回答靠的是模型「记住的」信源,训练与检索是两条供给引用的通路。退出训练,短期引用几乎无感(历史内容早已进训练集),长期是在慢慢抽走「记忆型引用」的补给;退出 grounding 才是当场切断「检索型引用」。两家的拆法由此产生完全不同的后果:
- Google 站:一行写下去,两条通路可能一起收窄(训练退 + Gemini grounding 连坐退),只剩搜索收录和 AI Overviews 那条独立开关。
- 微软站:两条通路独立,退训练不碰引用,是目前唯一能「只退训练、保住被引用」的分档。
- OpenAI / Anthropic 站:现有按名爬虫控制全部保留,过渡期风险最低,但「训练 vs 搜索」本来就该分开配。
五、三类站怎么写
品牌站 / 以被引用为目标的站:默认不写这一行。你要的就是被记住、被引用,训练退出对你是纯减分;要控制的是抓取节奏与页面级引用权限,按爬虫名写。内容站 / 媒体站:想退训练、留引用,选微软语义的写法,先别在 Google 侧写。这一行要等 2027 年才生效,现在写了不生效,而 Google 一生效就连坐;真正想退训练的,等 Google 的分档说明清楚再动,或接受「Gemini 引用一起退」的取舍。还在用 NoArchive / NoCache 的站:2027-03-01 前必须迁移。微软届时停读这两个标签,12 月 15 日先去 Bing 站长工具用临时设置接住,别到日子引用控制静默失效。
FAQ
Q:现在就把这一行写进 robots.txt,有用吗?
A:没用也没害。三家最快也要「未来几个月」(OpenAI),微软 2027-02-01、谷歌 2027 年初才执行,且它是自愿偏好、不溯及已抓取内容。现在写表达的是立场,不是立即生效的禁令;真正要盯的是生效后各家的连带语义。
Q:写这行会不会让 AI 搜索不再引用我的网站?
A:不会立刻,但分家。训练退出影响的是「模型记住你」,grounding 退出影响的是「回答时引用你」。微软把两者拆开,退训练不碰引用;Google 会把共享令牌连坐成 Google-Extended 禁用,Gemini 应用的 grounding 引用一起退,但 Google 搜索收录、AI Overviews 不受这一行影响。所以「想被引用就先别在 Google 侧写」,是在写之前就要做好的取舍。
Q:我已经有 User-Agent: * 的规则,算表态了吗?
A:不算。草案明文规定通配组不匹配这个令牌;没有单独的 __usage_ai-training 组,就等于没有表达偏好——这也意味着今天几乎所有 robots.txt 都还没表态。
Q:不写,会不会被 AI「惩罚」?
A:不会。它是退出机制不是准入机制,默认状态就是允许,不写没有任何负面信号;四家的现有爬虫控制也都明确「继续有效、不被替换」。对 GEO 站,真正的开关从来是按爬虫名的抓取规则和 Search Console / Bing 站长工具里的引用开关,而不是这一行。
延伸阅读
- AI 爬虫分三种,你 robots.txt 里挡的是哪一种?——训练爬虫、搜索爬虫、用户代抓怎么分开配(105 期)
- AI 读到你,和「接到你」,是两回事——抓取与引用的分野,本篇的前置概念(131 期)
- llms.txt 和 Schema 到底要不要做?GEO 技术基础设施清单——robots 之外的另外两个技术开关(62 期)
训练是昨天的事,引用才是明天的生意。
《四巨头同日宣布:一行 robots.txt,退出 AI 训练》有一个想法