你有没有过这种困惑:明明盯着同一个问题、同一批关键词做监测,工具报上来的”引用”数字和 AI 实际答案里看到的对不上。多数人以为是自己测早了、测少了。但一篇 2026 年 10 月的论文给出了一个更根本的解释:你用来监测的那套东西,从设计上就看不见大部分真实引用——不是误差,是结构性的漏。
这篇论文是西安交通大学与新加坡国立大学的 Jiang 等人写的《Understanding ChatGPT Citations: Evidence from Production Web Search Across Model Generations》(arXiv:2610.15382)。它做了一件同行很少做的事:不看 AI 最终吐出来的答案,而是抓 ChatGPT 网页版内部的 SSE 执行轨迹,看它到底改写了什么问题、跑了几次检索、抓了多少候选、最后引用了谁。结论对 GEO 监测的冲击,比”排名不等于引用”更进一层。
一、第一道断层:AI 几乎从不按你写的那句话去搜
论文把一次回答拆成三个动作:一次检索工具调用算一轮(round),一轮里发出去的每条查询算一个 executed query。传统 GEO 默认”用户问 A,引擎就搜 A”,而论文实测的四种设置里,原始问题被原样执行的比例低到接近零:
| ChatGPT 设置 | 原样执行用户问题的比例 | 多查询运行的比例 |
|---|---|---|
| 5.2-instant | 5.5% | 100% |
| 5.3-instant | 0% | 6.2% |
| 5.4-thinking | 0% | 99.4% |
| 5.5-instant | 0% | 31.3% |
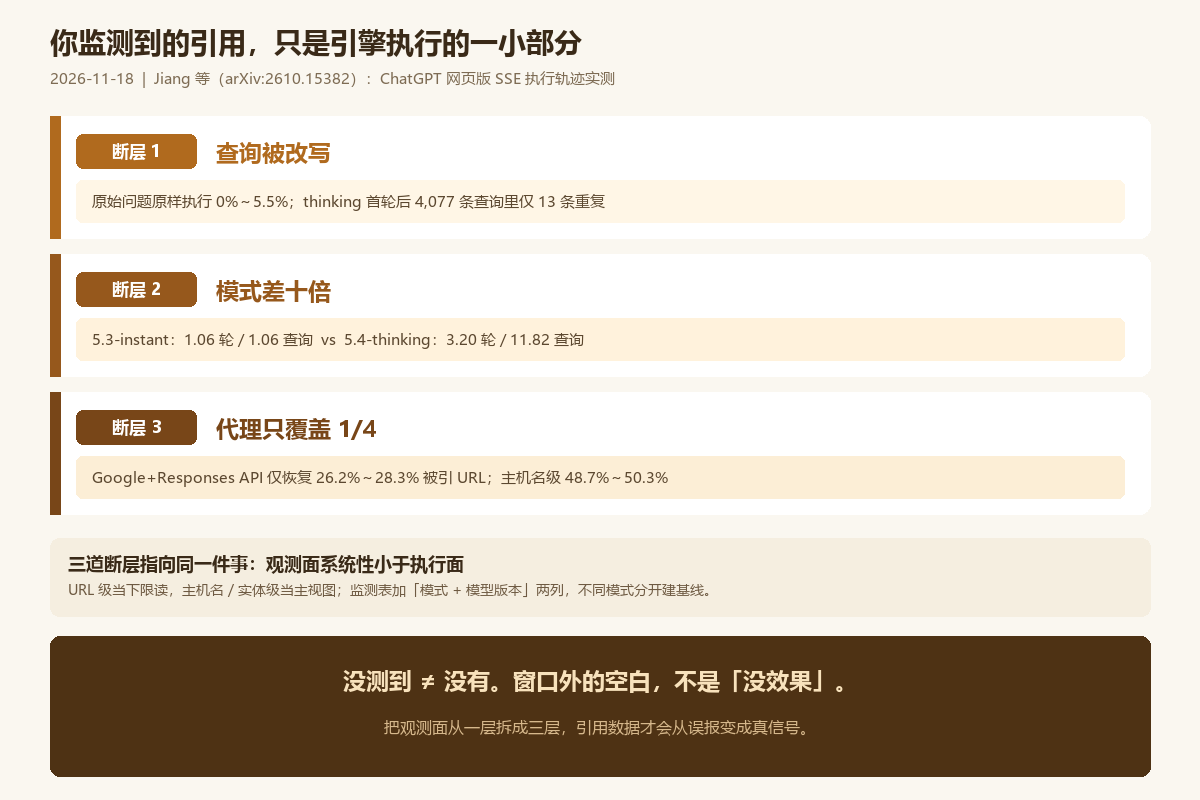
也就是说,除了 5.2 的 5.5%,其余三种设置下没有一次运行把用户原话当成检索词。引擎搜的是它自己改写的版本。Thinking 模式尤其极端:首轮之后发出的 4,077 条查询里,只有 13 条(0.3%)重复之前搜过的——几乎每一条都是新词。而且越到后面越”精准打击”:带 site: 的查询从首轮 25.1% 升到后续 54.7%,带引号的精确短语从 1.0% 升到 22.7%。
这一条就把”围绕用户问题写内容”的旧直觉打掉了一半。你需要覆盖的,不只是用户会问的那句话,还有引擎会把它拆成的那些子查询——价格、替代方案、适用场景、排除条件。177 期讲过 fan-out 把主查询拆开,但当时说的是机制;这里给的是实测频率:原话几乎不被搜,改写才是常态,而且越搜越窄。
二、第二道断层:同一个引擎,不同模式根本是两套检索系统
论文抓了四个设置的完整轨迹(采集窗口 2026-03-29 至 07-29,80 个真实问题、四种意图、中英各半,取自 Search Arena 的 2.4 万条真实交互)。四套设置的行为差异大到不像同一个产品:
| 设置 | 每次回答平均查询数 | 平均检索轮数 | 多轮运行占比 | 平均主候选URL | 平均引用URL |
|---|---|---|---|---|---|
| 5.2-instant | 2.36 | 1.18 | 17.4% | 39.38 | 5.91 |
| 5.3-instant | 1.06 | 1.06 | 5.5% | 18.74 | 5.55 |
| 5.4-thinking | 11.82 | 3.20 | 71.3% | 73.51 | 7.81 |
| 5.5-instant | 1.45 | 1.04 | 3.8% | 23.47 | 6.53 |
看这两行对比:5.3-instant 一次回答平均搜 1.06 次、抓 18.74 个候选;5.4-thinking 平均搜 11.82 次、跨 3.20 轮、抓 73.51 个候选。同一家引擎、同一个问题,检索强度差了十倍以上。这解释了 182 期那个”排名没动、引用却变了”的困惑——除了模型换脑,模式本身就是隐藏变量。你如果把这个月的 instant 数据和上个月的 thinking 数据放在一张图里比,等于把两把不同刻度的尺子接在一起。
论文还给了一个容易被忽略的发现:跨次运行抓到的网页很不一样,但反复被抓到的候选更容易被引用,更长的摘要片段也是稳定但较弱的引用信号。换句话说,”被搜到的次数”本身就是资产——这正对应 25133 期讲过的”被引次数要按次统计”,只是这里前移到了检索层。
三、第三道断层:你的代理监测,天生只能看到四分之一
这是全篇最狠的一条。绝大多数团队没有能力抓引擎内部轨迹,只能用外部代理去”近似”——拿 Google Search 的排名、或 OpenAI Responses API 的返回,当作 ChatGPT 引用的替身。论文专门测了这个替身到底靠不靠谱:
- URL 级:Google Search + Responses API 两个代理合起来,只恢复了 26.2%~28.3% 的被引 URL。翻译过来——你用这两套工具做监测,大约四分之三的真实引用根本进不了你的报表。
- 主机名级和实体级好得多:恢复了 48.7%~50.3%。也就是按”域名”和”品牌实体”去看,能看到接近一半;按”精确 URL”去看,只剩四分之一。
- Responses API 的候选覆盖更广,但它的引用结果更接近 ChatGPT 网页版;两个代理在主机名、实体层的吻合度都高于精确 URL 层。
- 把两类代理信号送进监督模型,AUC 达到 0.74~0.78(5.3-instant 三个层级 0.782/0.763/0.743,5.5-instant 为 0.779/0.763/0.742)。这是”有预测力”,但不是”能复原”——两者差别很大。
这条结论要精确理解:它不是说 Google 和 Responses API 没用,而是说它们是有偏的观测面,且偏差方向明确——越细的粒度丢得越多。你以为”没被监测到=没被引用”,实际可能只是”被引用了但代理看不见”。这和 25127 期的”rank 不再预测引用”是同一条线,但更进一层:那篇说排名和引用脱钩,这篇说连你用来测引用的代理本身,都只覆盖四分之一。
四、对你意味着什么:把”一层监测”改成”三层 + 分模式”
三条断层合起来指向同一件事:GEO 的观测面系统性地小于引擎的执行面。对应的做法不是换一个更贵的工具,而是换一套观测结构。
| 断层 | 论文证据 | 你该改什么 |
|---|---|---|
| 查询层:原话几乎不被搜 | 原样执行 0%~5.5%;thinking 首轮后 0.3% 重复 | 问题清单从”用户会问什么”扩到”引擎会拆成什么”,按子问题建内容 |
| 模式层:强弱检索差十倍 | 1.06 轮 / 1.06 查询 vs 3.20 轮 / 11.82 查询 | 监测记录加”模式+模型版本”两列,不同模式分开建基线 |
| 代理层:只覆盖约四分之一 | URL 恢复 26.2%~28.3%,主机名 48.7%~50.3% | URL 级当”下限”读,主机名/实体级当”主视图”,别把代理零当真实零 |
- 1)把”没测到”和”没有”分开记。代理工具报零时,先标成”未观测”而不是”未引用”。URL 级零、主机名级有,是这篇论文预测到的最常见形态——你的域名在被引,只是被引的不是代理能看到的那条精确链接。
- 2)监测表加两列:模式、模型版本。这与 182 期的”界面变体/设备”两列是同一个思路的延伸。不记这两列,你把 instant 的窄检索和 thinking 的宽检索混在一起,任何同比都是错的。论文原话直接点明:部署设置变了,GEO 策略就该重评。
- 3)内容按”子问题”铺,不按”主问题”堆。原话几乎不被搜,改写越到后面越带 site: 和引号。与其把主关键词密度堆高,不如给每个可预期的子问题(价格、替代、兼容、不适合谁)一个能独立成立的段落——这是 25130 期 passage 粒度打法在查询层的对应面。
- 4)实体一致性比精确 URL 更划算。既然主机名、实体层的观测恢复率接近 URL 层的两倍,就把资源放在”品牌实体在多个源里说法一致”上——这是 25096 期的老结论,这篇论文从观测角度给出了新理由。
FAQ
Q:”代理只恢复四分之一”是不是说这些监测工具都不能用了?
不是。论文说的是覆盖率,不是有效性。在可观测的那部分候选里,两类代理组合起来对引用仍有 0.74~0.78 的预测力。正确用法是:把 URL 级数字当下限(低于它一定不对,高于它不是全部),主机名和实体级当主视图,并且明确标注”这是代理观测,不是引擎内部真值”。
Q:这篇和 182 期”换脑期归因陷阱”有什么区别?
182 期讲的是外部事件叠加(核心更新、模型换脑、界面改版)让复测对照组失效,是”时间维度”的干扰。这篇讲的是:就算什么外部事件都没有,观测面本身也天生小于执行面——查询被改写、模式强度差十倍、代理只覆盖四分之一,是”结构维度”的漏。前者靠切时间段解决,后者靠改监测结构解决。
Q:那到底该监测什么才算数?
论文的建议是三件事同时做:区分”检索可见性”和”引用可见性”(被抓到不等于被引用);把改写查询和运行间波动纳入记录(同一问题多跑几次);除精确 URL 外,同时看主机名和实体层 presence。落到执行上,就是本文第四节的四条动作。
Q:论文数据来自 5.2~5.5,对现在的引擎还适用吗?
具体数字绑的是当时的设置,不宜直接套到今天的具体版本。但三条结构性结论——原话很少被原样执行、不同模式检索强度差异巨大、外部代理粒度越细丢得越多——是关于机制的描述,论文也明确提示”部署设置变化时要重新评估 GEO 策略”。把它当成监测设计的依据,而不是当成一个固定常数。
Q:口播里说的”漏掉四分之三”是指答案里四分之三的品牌都是假的吗?
不是。指的是用 Google Search 加 Responses API 这两个外部代理,合起来只能恢复 ChatGPT 真实被引 URL 的约 26%~28%,剩下的约 72%~74% 未能被代理观测到。是”监测覆盖率”问题,不是”答案真实性”问题。
结语
这篇论文真正改变的是 GEO 的自我认知:我们一直在用一个比引擎小得多的观测窗口,去推断引擎的完整行为。窗口小不可怕,可怕的是不知道它小,还把窗口外的空白当成”没效果”。把观测面从一层拆成三层,把模式当变量记下来,你看到的”没被引用”才会从误报变成真信号。