今天(2026-11-20)中午的资讯里,一批新数据把 GEO 里最容易被误解的环节——”AI 到底凭什么推荐一个品牌”——第一次拆到了可核查的粒度。Supercite 在 11 月 17 日发布首日研究:210 个购买问题、21 个品类、四个引擎、839 条回答、6,867 条引用;紧接着 11 月 18 日又发了隔日复测,并在 11 月 19 日更正了一个关键数字。
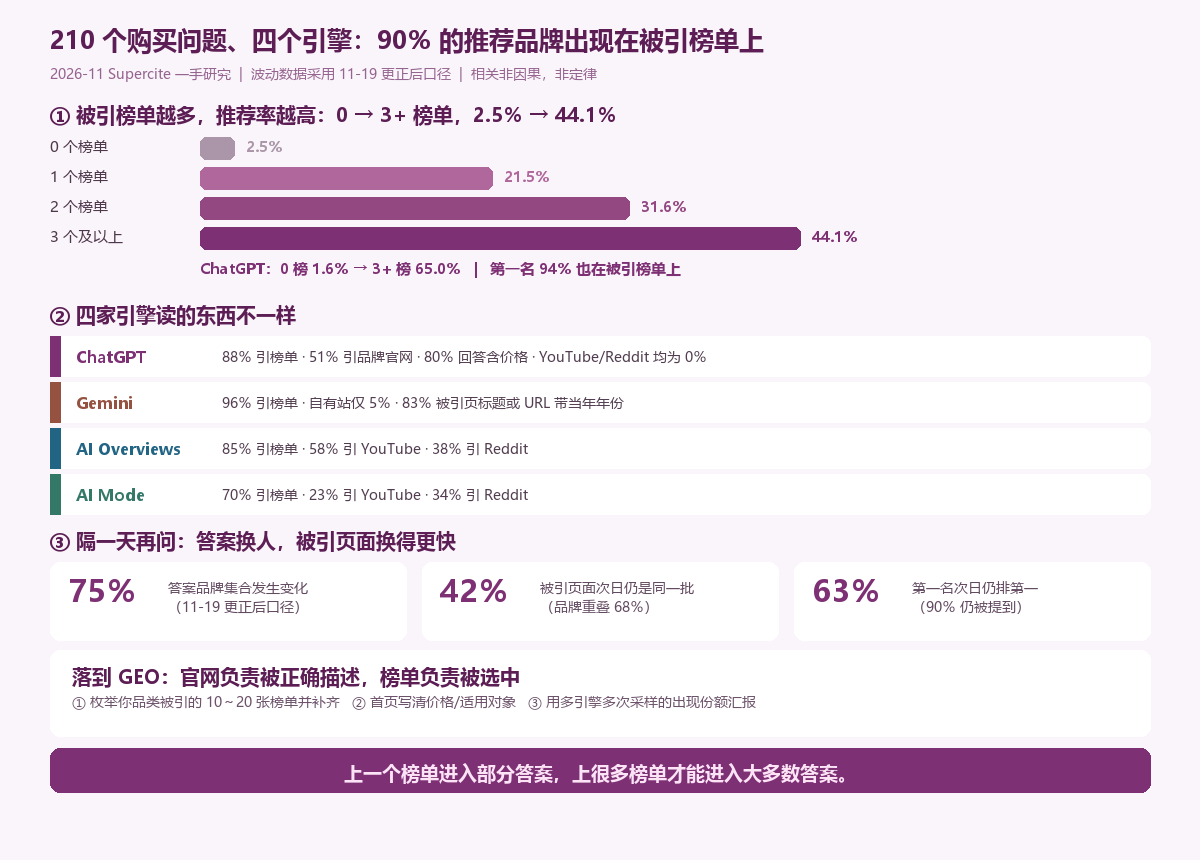
结论有两层。第一层:90% 被 AI 推荐的品牌,出现在该次回答引用的”best X/top X”榜单里;品牌被引用的榜单从 0 个增加到 3 个以上,推荐率从 2.5% 升到 44.1%(在 ChatGPT 上是 1.6% 到 65.0%)。第二层:答案本身极不稳定——同一批问题隔一天再问,按作者更正后的口径,75% 的回答换掉了品牌集合,只有 42% 的被引页面还是同一批。
这两层合起来,推翻了”把官网写好就会被推荐”的直觉。本期不谈关键词和 schema 的常识,只讲这批一手数据能证实的机制:推荐从哪来、榜单集中在哪、四家引擎各读什么、以及为什么单次截图不能作为决策依据。
一、90% 的推荐,来自引擎刚刚读过的榜单
先把口径说清楚。Supercite 在 2026 年 11 月 17 日以美国用户身份用英文向 ChatGPT、Gemini、Google AI Overviews、Google AI Mode 各问了 210 个购买问题(如”best CRM for a small team””cheaper alternative to Zendesk”),共 839 条回答、6,867 条引用。其中 43% 的引用是标题或 URL 含 “best”/”top” 的榜单页,指向 1,535 个不同页面,当天成功抓取到 1,473 个。”被推荐”的判定是品牌出现在标题、加粗、链接、表格或列表开头,而不是顺带被提到。
把”该次回答引用的榜单里有几个提到了这个品牌”与”品牌是否被推荐”对照,结果是一条陡峭的阶梯:
| 被引榜单中提到该品牌的数量 | 品牌被推荐的比例 |
|---|---|
| 0 个 | 2.5% |
| 1 个 | 21.5% |
| 2 个 | 31.6% |
| 3 个及以上 | 44.1% |
在能够读到被引榜单的 3,284 次推荐里,2,943 次(90%)给了至少一个出现在榜单上的品牌;答案的第一名有 656/695 次(94%)也在榜单上。分引擎看,从”0 个榜单”到”3 个以上榜单”的跃升幅度是:ChatGPT 1.6%→65.0%,Google AI Mode 3.0%→48.4%,AI Overviews 3.3%→47.6%,Gemini 2.1%→37.5%。
还有一个细节支持”读榜再答”:ChatGPT 会公开它运行过的网页搜索。210 个问题里有 109 个,它在读任何页面之前就把品牌名放进了搜索词——例如”best help desk software for SaaS startups 2026 pricing features Intercom Zendesk Help Scout Freshdesk Crisp”。这不是”它记住了你所以推荐你”这么简单:它先点名再推荐的品牌里,98% 同时也出现在它引用的榜单上;而它没有预先点名的品牌,也有 90% 是通过榜单进入答案的。记忆和检索两条路,最终都汇合到同一批页面上。
二、不是”大品牌无处不在”:同一品牌自对照,且榜单只有十来个
看到这里最自然的反驳是:大品牌本来就到处都被写,当然更容易上榜、也更容易被推荐。研究方做了同品牌自对照来排除这个效应:在 313 个”既出现过在榜单上、也出现过不在榜单上”的品牌里,同一个品牌在被引榜单上的回答中被推荐 26.6%,不在榜单上的回答中只有 4.6%。会计软件 Wave 在 33 次被引榜单提到它的回答里被推荐了 26 次,在 5 次没有榜单提到它的回答里是 0 次。
更可操作的是第二件事:这些榜单不是无限长的尾巴,而是一个很短、可以枚举的集合。每个品类有 21~78 个不同站点提供榜单,但引用量前十的站点占了 38%(会计软件)、47%(CRM)、63%(邮件营销),家庭安防甚至达到 90%。而且它们不全是大众媒体:CRM 里被引用最多的包括两家 CRM 厂商自己的博客;邮件营销里有一个被引最多的小工具厂商博客;”AI 搜索工具”品类里被引前三的站点全是该品类内的公司。
研究方也测了”自己写榜单”:在 120 次回答引用了品类内某品牌自己写的 best X 页面的案例中,该品牌有 82 次(68%)被推荐;其他情况下品牌被推荐的比例是 14%。但作者明确警告——把自己排第一、贬低所有竞争对手的页面一眼假;真正被引的是诚实对比:列出多个选项、说明各自适合谁、包含真实价格。
三、四家引擎读的东西不一样:ChatGPT 看首页,Gemini 只看榜,Google 看视频和社区
同一批回答按引擎拆开,信源差异非常直观(数字为”该类页面出现在该引擎回答引用中的回答占比”):
| 引擎 | 引用 best X 榜单 | 引用 YouTube | 引用 Reddit | 推荐品牌的自有站被引用 |
|---|---|---|---|---|
| ChatGPT | 88% | 0% | 0% | 51% |
| Gemini | 96% | 11% | 27% | 5% |
| Google AI Overviews | 85% | 58% | 38% | 13% |
| Google AI Mode | 70% | 23% | 34% | 11% |
- ChatGPT 读你的官网:约一半的推荐品牌自有站被引用,其中 70% 是首页;80% 的回答引用了价格。如果首页没有清楚写”多少钱、给谁用、解决什么问题”,ChatGPT 会从别处替你填。
- Gemini 几乎只读榜单:96% 的回答引用 best X 页面,三分之二的引用是榜单,品牌自有站只占 2%。
- Google 的两家 AI 界面看视频和社区:AI Overviews 在 58% 的回答里引用了 YouTube、38% 引用了 Reddit;ChatGPT 这两项都是 0。
还有一件小事但很硬:ChatGPT 对 210 个问题每一个都在搜索词里加上了 “2026”;紧随其后的高频追加词是 comparison(37%)、pricing(34%)、reviews(29%)、features(22%)。Gemini 被引页面中有 83% 在标题或 URL 里带 2026。一篇标题写”2024 年最佳 CRM”的榜单,在这轮搜索里基本不可见。
这和 191 期不矛盾:那期用 RankBits 数据说”Reddit 是 ChatGPT 的主场、YouTube 是 Google 的主场”,指的是品牌被点名的信源分布;这期说的是产品推荐环节的榜单构成。两份研究口径不同,但在”Google 系更吃视频/社区”这一点上方向一致,而 ChatGPT 在推荐场景里更依赖榜单与品牌首页。
四、隔一天,75% 的答案换掉一批品牌:单次截图不能决策
11 月 18 日,Supercite 用同样的 210 个问题、四个引擎、同样设置隔一天再问一次,得到 839 组可比对回答。这里必须说清一个口径更正:文章首版写”84% 的答案变了”,11 月 19 日作者更正为 75%——原数字来自应用内自动品牌匹配,把一些并非推荐的平台名也算进去;按研究公布的品牌清单重算,75% 的答案品牌集合发生变化,品牌重叠率 68%。目前不少二手报道仍在引用 84%,本期一律采用更正后的 75%。
其余波动数字:
- 第一天被提到的品牌,27% 第二天消失;
- 第一名相对稳固:90% 次日仍被提到,但只有 63% 仍排第一;第 2~3 名 79%、第 4~5 名 66%、第 6 名以后 61%;
- 品类领导者保住 73% 的位置,小品牌只保住 51%;
- 被引页面换得比品牌还快:只有 42% 的引用页面次日仍是同一批;分引擎看,AI Overviews 47%、Gemini 41%、ChatGPT 40%、AI Mode 39%;
- 分引擎答案变化率:Gemini 95% 最高,ChatGPT 88%,AI Mode 84%,AI Overviews 67% 最低;ChatGPT 对第一名最忠诚,71% 的回答次日仍是同一个第一名。
一个真实例子:同一句”easiest CRM for a team that has never used one”问 Google AI Mode。17 日的第一名是 Less Annoying CRM,理由是”zero-frills simplicity”,引擎只读了 Zapier 的一篇最佳 CRM 榜单;18 日这个品牌完全消失,HubSpot 升到第一,引擎这次读的是 Slack 博客的一篇指南和 HubSpot 自己的产品页。两款 CRM 一夜之间什么都没变,变的只是引擎读到了哪些页面。
把两篇研究接起来,逻辑就闭合了:90% 的推荐来自被引榜单,而被引榜单每天只留 42%——上一个榜单能让你进入部分答案,上很多榜单才能让你进入大多数答案。这也解释了为什么小品牌波动更大:它们在少数几个页面上,引擎一旦换页,它们就出局。研究还提到,单次回答平均点到约 6 个品牌,但把四个引擎两天的 8 次回答合起来,同一问题出现了 14 个不同品牌,其中 30% 只被提到一次,只有约 2 个品牌 8 次全勤。所以该看的指标是多次采样中的出现份额(share of answer),而不是”被推荐/没被推荐”的二值判断。
五、落到 GEO:把”被正确描述”和”被选中”分开做
| 环节 | 一手证据 | 动作 |
|---|---|---|
| 进入推荐 | 0/1/3+ 榜单对应 2.5%/21.5%/44.1% 推荐率;90% 推荐品牌在被引榜单上 | 先找出买家问题在四个引擎里被引的榜单,再逐个补上遗漏的那几个 |
| 榜单可枚举 | 每品类前十站点占 38~90% 榜单引用,多为小博客与厂商博客 | 列出你品类的 10~20 个被引榜单,优先攻更新频繁的小站,而不是只盯大媒体 |
| 自有页面 | ChatGPT 51% 推荐品牌官网被引用、80% 回答引用价格;Gemini 仅 5% | 首页顶部写清价格、适用对象、解决的问题;自有 best X 对比页要诚实、带竞品 |
| 时效标记 | ChatGPT 210/210 次搜索加当年年份;Gemini 83% 被引页标题或 URL 带年份 | 榜单与对比页标题写明当前年份,并在换年后更新 |
| 监测口径 | 75% 答案隔日变化、被引页仅 42% 保留;单次回答约 6 品牌,8 次回答出现 14 个 | 同一问题多引擎、多日重复采样,记录出现份额与来源页变化,不用单次截图汇报 |
一句话收口:官网负责让模型把你描述对,榜单负责让模型把你选出来。这两件事的证据、指标和动作都不同——把预算全押在官网,等于只做了入场券,没做点名。
FAQ
Q:为什么有的报道说 84% 的答案会变,这里说 75%?
84% 是 Supercite 11 月 18 日首版数字。11 月 19 日作者发布更正:原统计用了应用内自动品牌匹配,把并非推荐的平台名也算作品牌;按研究公布的清单重算后是 75% 的答案发生变化,品牌重叠率 68%。本期采用更正后口径,并保留 27% 品牌次日消失、42% 引用页次日保留等未受该更正影响的数字。
Q:这是因果吗?上榜单就能被推荐吗?
不是因果。作者在方法局限里明确写”相关”:榜单和答案都可能偏爱更契合问题的品牌。同品牌自对照削弱了”大品牌无处不在”的解释,但不能消除问题之间的差异。另外这是 7 天实验的第 1、2 天,美国英文单次采样,榜单按标题识别、”上榜”只查名字出现不查排名;作者说会在 11 月 24 日更新完整一周数据。把它当强观察与可执行假设,不当定律。
Q:自己写一篇 best X 把自家产品放进去,算不算作弊?
研究确实发现品牌自写的榜单被引用时,该品牌 68% 被推荐(其他情况 14%)。但作者同时提醒:把自己排第一、贬低所有对手的页面读者一眼就能看穿;真正被引的是列出多个真实选项、说明各自适合谁、给出当前价格的诚实对比页。用可被核验的信息进入候选集,和操纵榜单是两件事。
Q:既然 Gemini 只有 5% 引用品牌自有站,官网还用做吗?
要,但目的不同。在 ChatGPT 上官网是主渠道(51% 的推荐品牌官网被引用、80% 回答涉及价格);在 Gemini 上官网主要用于”被正确描述”,而进入答案靠榜单。这也是本期和 190 期”读取层”的分工:190 讲的是模型读取页面那一刻的规则变化,本期讲的是在它读取的页面里,榜单如何决定品牌是否被点名。
Q:这期和 188、190、191 期怎么区分?
四层递进:188 是”进池权”(决定引用的是进没进候选集,32% 对 2.8%);190 是”读取层”(快照时效、按域放行、Cache 优先);191 是”跨引擎点名率差异”(同题六家点名率不同、各家的检索依赖和信源偏好不同);本期是”推荐决定机制与波动”——推荐是从被引榜单里产生的,且这些榜单天天轮换。四者串联,没有重复。
结语
今天这批一手数据给 GEO 一个少见的确定性:AI 推荐不是一个玄学的”品牌印象分”,而是一个可以被观察的采样过程。引擎先搜索、再读几张 best X 榜单、从榜单里挑品牌;品牌在榜单上从 0 到 3 个,推荐率从 2.5% 涨到 44.1%(ChatGPT 上到 65.0%)。同时,被引榜单每天只保留 42%,导致 75% 的答案隔日换人——所以”被推荐过一次”和”稳定被推荐”完全是两回事。可执行的顺序是:先找到引擎为你买家的问题读了哪些榜单,再确保你在尽可能多的榜单上;把官网写成能被准确摘录的事实页;最后用多引擎、多次采样的出现份额,而不是单次截图,来判断自己到底有没有被选中。