一家做工业设备的公司,去年把官网做了一轮完整改造:每页加 FAQ 块、上结构化数据、开头加摘要框、配作者简介,还把页面速度从五十多分提到了九十以上。
改完半年,AI 里的引用量几乎没动。
更让他们想不通的是另一件事:同一批内容里,有三篇 2023 年写的旧文,什么优化都没做,格式还很乱,却一直稳定出现在 AI 答案里。
他们问我:是不是我们改错了方向?
十月初,一份研究给出了答案。它做了一件之前很少有人做的事——不再跨网站比较,而是只在同一个网站内部比页面。
一、为什么「只在站内比」这么关键
过去两年绝大多数 GEO 结论,都是拿不同网站来比的。问题是:大站本来就更容易被引用,原因可能是品牌、可能是域名、可能是历史积累。你拿一个加了 FAQ 块的大站,去比一个没加的小站,测出来的其实是「大站更容易被引」,不是「FAQ 块有用」。
这项研究换了做法:只在同一个网站内部,比它自己的一批页面。这样一来,品牌、域名、整体权重全都被固定住了,剩下的差异只能来自页面本身。
样本不小:十五万八千多个 AI 答案、四十六万八千多条引用,连续九十天,覆盖消费者和细分 B2B 两个市场,三个引擎。
结论出来的时候,很多人的第一反应是不相信:
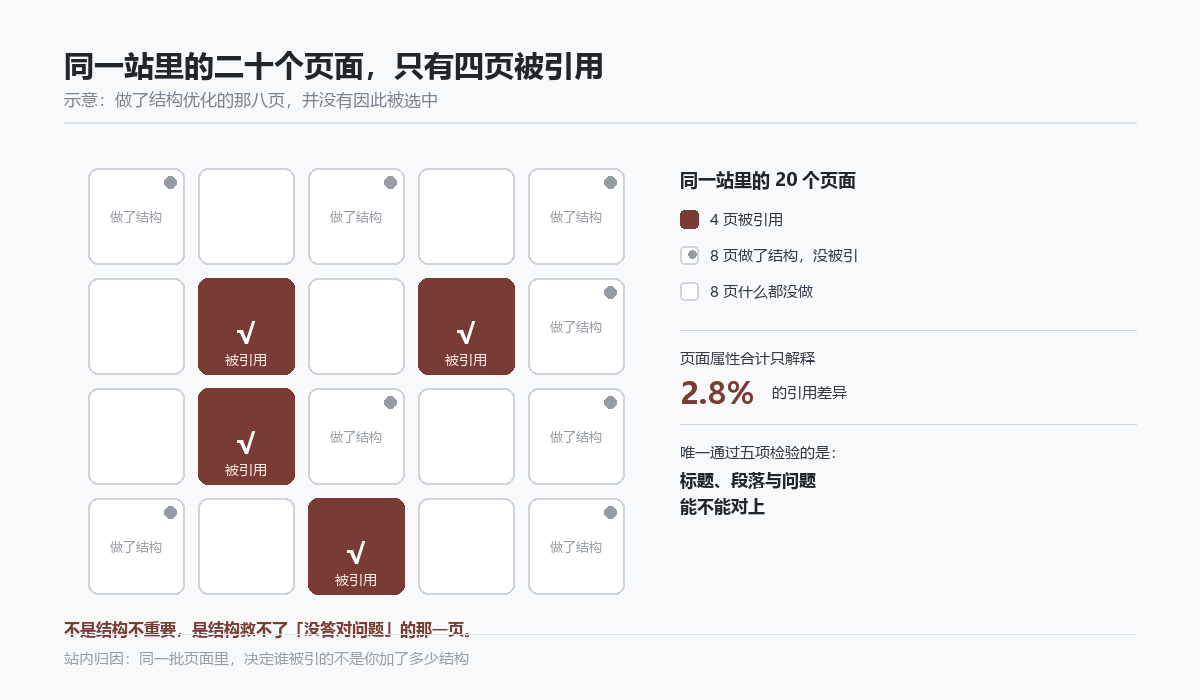
所有页面属性加在一起,只解释了 2.8% 的引用差异。而引擎自己的检索,解释了 32%。
二、哪些「标配」在站内消失了
研究逐项测了那些被说烂了的做法。跨站看,它们都有效;站内看,几乎全部不显著:
| 优化项 | 跨站比较时看起来 | 站内比较时实际 |
|---|---|---|
| FAQ 块 | 有提升(约十八个百分点) | 不显著 |
| 摘要框 | 有提升(约二十一个百分点) | 不显著 |
| 结构化数据 | 有提升 | 不显著 |
| 作者框 | 有提升 | 不显著 |
| 页面速度 | 有提升 | 不显著 |
同一招,两种比法得出两个结论,差在哪里?差在你测的是「谁」。做这些优化的,本来就是那些运营更认真、更容易成功的站。跨站比较把这些都算进了「优化」的功劳里。
还有一个数字更让人清醒:站点与站点之间的差异,只占全部引用差异的不到一成半。也就是说,同一站里「哪一页被引、哪一页没被引」,本身就是一件很大的事。
三、唯一活下来的那一个
研究设了五道稳健性检验,逐项过关才算「真的」。所有内容类变量里,只有一组稳定通过:
- 最佳段落与问题的匹配度:高一个标准差,引用多约 15.5%
- 标题与问题的匹配度:多约 14.1%
- 词重合度:多约 9.1%
三项都是同一件事:你写的东西,和用户问的那句话,像不像。
这解释了一个常见现象。很多企业把首页写得非常完整——公司简介、发展历程、资质荣誉、服务范围一应俱全,然后指望 AI 在回答「你们能不能做某某工艺」时引用它。问题在于,那一页里没有一句话长得像这个问题。
四、那 32% 是什么
研究里有个容易被忽略的细节:被引用的页面,百分之百都先被检索到过。
这句话听起来像废话,但它把优化的顺序彻底改了。引用不是一个「评价」动作,是一个「先被选中、再被摘取」的两段流程。第一段发生在页面上你看不见的地方:引擎把你的问题改写成好几条子查询,然后去检索、排序、挑出候选页。
你能碰的只有一件事:在那次检索里被选中。而检索选的是「语义上最接近这个问题的段落」,不是「结构最漂亮的那一页」。
还有一个数字可以佐证:另一份针对十七万多个被引用页面的分析发现,页面字数与被引概率的相关性接近于零,超过一半的被引页面不到一千字。写长不是没用,但它不是被引的原因。
五、顺序要反过来
过去我们建议的顺序是先上结构,再想内容。按这项研究,得先做内容对齐,再上结构:
| 以前的顺序 | 现在的顺序 |
|---|---|
| 先加 FAQ 块和摘要框 | 先把标题改成用户会问的那句话 |
| 先上结构化数据 | 先把首段写成一句能独立成立的答案 |
| 先找工具做检测评分 | 先拿客户的原话去比一次自己的标题 |
| 结构做完了再看内容 | 内容对上了,再用结构让它更好抽 |
不是结构没用了,是结构只能放大已经对上的答案,救不了没对上的那一页。给一个答非所问的页面加 FAQ 块,只是让它更整齐地答非所问。
六、四周就能做完的自查
- 第一周:把主推页面标题抄下来,和客户在 AI 里的原话并排放,看像不像同一句话。
- 第二周:每页挑出一段,单独读一遍,问它能不能独立回答那个问题。不能,就重写这一段。
- 第三周:把行业俗称和口语问法,补进标题或首段一次。
- 第四周:再测一轮,只看趋势,不看单次结果。
七、常见问题
那结构化数据到底还要不要做
要做,但别指望它决定「哪一页被引用」。研究说得很清楚:跨站比较时它有用(整站更容易被引),站内比较时它几乎不解释差异。所以它是「进场资格」,不是「排名依据」。正确的期待是:让机器更少猜错,不是让这一页排到前面。
我们的词是行业术语,客户不会这么说,怎么匹配
这正是要改的地方。术语用于专业解释,标题和首段用客户的原话。研究测的是「标题与问题的相似度」,不是「标题够不够专业」。一个行业的土话、俗称、口语问法,都该在主推页面的标题或首段出现一次。
这个研究是不是说 GEO 没用
恰恰相反,它把力气指到了对的地方。它说的是:在同一站里,页面属性几乎不解释差异,检索解释了约三成——也就是「能不能被选中」比「页面做得多漂亮」更要紧。而「被选中」取决于你写的是不是那个问题的答案。
页面属性只解释 2.8%,那剩下的部分还优化什么
分两层看。站内那 2.8% 之外,大头在引擎检索(约 32%)和引擎自身的波动里,你改不动。但「检索时选不选你」这一层,恰好是你能碰的:标题、首段、段落与问题的对得上程度。剩下还有更大一块是跨站层面的品牌与信源,那是另一个战场。
延伸阅读
同一批页面里,决定谁被引用的不是加了多少结构,而是哪一段正好是那个问题的答案。结构决定它好不好抽,内容决定它配不配被抽。