做 GEO 的人最近有一种说不清的不适感:内容没少发,收录也没问题,但 AI 答案里就是没有你了。不是排得靠后,是压根不在名单里。
2026 年 10 月,三件事同时发生,把这种「说不清」说清楚了——AI 搜索正在从「引不到」变成「主动剔除」,而且有三个明确的信号可以对照。
一、三个信号分别是什么
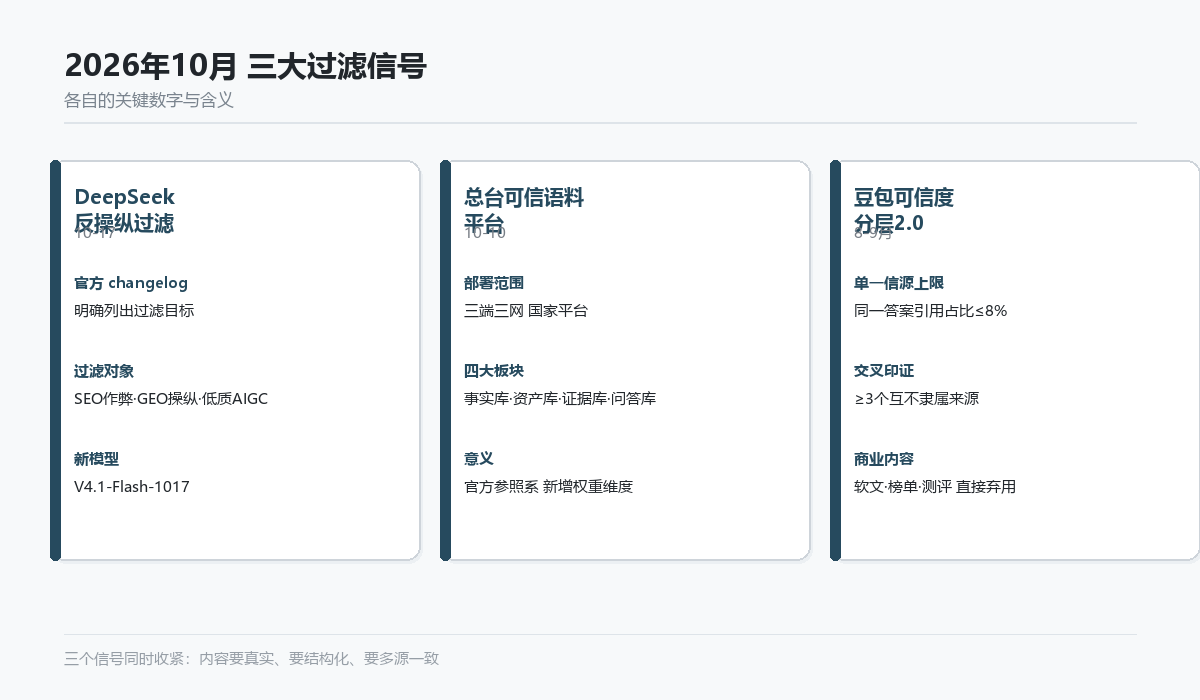
| 信号 | 时间 | 关键数字 | 意味着什么 |
|---|---|---|---|
| DeepSeek 反操纵过滤 | 10-17 | 过滤对象:SEO作弊·GEO操纵·低质AIGC | 批量水文的成本变高,正规内容相对受益 |
| 总台可信语料平台 | 10-10 | 三端三网·四大板块·官方事实库 | 品牌信息有了官方参照系,对不上直接掉分 |
| 豆包可信度分层2.0 | 8-9月落地 | 单一信源≤8%·≥3个互不隶属来源·商业内容弃用 | 多源一致性成为硬门槛,单渠道布局失效 |
二、信号一:DeepSeek 把「操纵」写进了 changelog
10 月 17 日,DeepSeek 同步开放自研搜索 API 和 V4.1-Flash-1017 模型,官方变更日志里有一句话很关键:过滤 SEO 作弊、GEO 操纵、低质量 AIGC 内容。
这不是行业解读,是平台自己写的。三个过滤对象拆开看:
- SEO 作弊:关键词堆砌、门页、隐藏链接——老一套,AI 搜索也识别了
- GEO 操纵:批量 AI 水文、虚构用户评价、伪造第三方背书——专门针对 AI 内容生态
- 低质 AIGC:模板化改写、低信息密度内容——收录率持续下滑
还有一个具体动作:测评类、榜单类内容被拦截处理,直接不进候选池。这意味着「花钱上的排行榜」这条老路,在 DeepSeek 这条线上彻底走不通了。
对正常做 GEO 的人,这是利好——噪声被清掉,真实事实内容的相对权重在上升。
三、信号二:总台入局,可信度有了官方参照系
10 月 10 日,中央广播电视总台启动「2027 品牌强国战略」共建行动,同步上线国家品牌可信语料平台。部署范围是「三端三网」——央视频、央视新闻、央视财经,加上央视网、央广网、国际在线。平台设了四个板块:品牌事实库、内容资产库、公共证据库、品牌问答库。
需要厘清:总台启动的是可信语料平台,不是发布「GEO 战略」。但这件事的实质影响很明确——品牌信息从此多了一个官方交叉验证层。
你的核心数据(成立时间、业务定位、资质、服务范围)跟官方库里的一致,AI 引用你时的可信度加分;对不上,就是减分。过去「全网自己说」的玩法,现在要面对「官方记录说什么」这道题。
叠加上半年新华网的 GEO 智能体平台、人民网的「主流价值语料生态联盟」(16 家单位参与),官媒侧的可信语料基础设施正在加速成型。GEO 的评价体系,「拼谁发得多」正在变成「拼谁更可信、更结构化」。
四、信号三:豆包分层2.0,单渠道布局正式失效
豆包在 8 月底到 9 月上线可信度分层 2.0,核心规则三条:
- 同一条答案里,单一信源引用占比不超过 8%——你在一个平台上做得再好,也占不了答案的大头
- 同一个事实需要三个以上互不隶属的来源互相佐证,孤证直接降权
- 公众号软文、行业榜单、第三方测评被归为商业营销内容,直接弃用;识别 SEO 矩阵站并降权
第三条最容易被忽略:「第三方测评」被弃用不等于「第三方内容」被弃用。真实用户的评价、有数据支撑的独立报道,仍然是有效信源;「XX 行业 TOP10」这类榜单物料,在 AI 眼里跟广告没有区别。
五、怎么判断自己是否已被过滤
过滤和降权的区别:降权是「还在池子里但排得靠后」,过滤是「根本没进池子」。两套自检方法:
- 缺席连续性:同一组核心问题(业务关键词 + 「哪家好」「多少钱」类问句),连续 4-5 周查,如果一次都没有你的名字,不是波动,是缺席。
- 引用来源列表:AI 回答后展开「引用来源」,如果列表里一个你发过的链接都没有,说明召回阶段就把你滤掉了,不是精排阶段输的。
两个都中了,优先检查内容里的商业营销痕迹(纯宣传话术、榜单背书、批量 AI 生成),这是三个平台同时识别的特征,也是被过滤最常见的原因。
六、修完过滤,再谈增量
面对这三条信号,优先级是清晰的:
| 优先级 | 动作 | 对应哪个信号 |
|---|---|---|
| 第一 | 清除商业营销痕迹,把宣传话术换成可验证事实 | DeepSeek 反操纵 + 豆包商业内容弃用 |
| 第二 | 核心事实多源对齐:官网 = 公众号 = 行业媒体,口径一致 | 豆包孤证降权 + 总台参照系 |
| 第三 | 检查是否被识别为矩阵站(同内容多平台改写分发) | 豆包矩阵站降权 |
| 第四 | 把结构化数据(Schema.org)补全,让事实机器可读 | 总台结构化权重 + 全平台趋势 |
前两项做完,再考虑增量。过滤没修就加量,等于往漏的桶里倒水。
七、常见问题
被过滤了会有什么外在表现
最直接的信号:同一组问题,之前 AI 答案里有你的名字,最近两轮都没有了,而且不是某一次波动,是持续缺席。再查引用来源列表——如果列表里一个你发过的链接都没有,说明你的内容根本没进候选池,不是排序靠后。两个都中了,就是被过滤,不是降权。
DeepSeek 的反操纵过滤会误伤正常 GEO 吗
不会。changelog 写得很清楚:过滤对象是「人为污染信息生态」的行为——批量 AI 水文、堆砌关键词、虚构评价、伪造背书。正常的品牌官网、结构化事实、第三方独立报道,恰恰是它要优先呈现的内容。做 GEO 的方向没有变,变的是「用脏手段」的成本变高了。
总台的可信语料平台跟普通企业有什么关系
它是信源权威度的新增参照系。平台部署了品牌事实库、内容资产库、公共证据库、品牌问答库四大板块,未来 AI 引用品牌信息时,有官方事实库做交叉验证——你的信息跟总台库里的一致,可信度加分;对不上,直接掉分。短期影响不大,中长期是新的硬标准。
现在该优先修哪个信号
先查你的内容里有没有「商业营销痕迹」:纯宣传话术、榜单背书、批量 AI 生成。这是被三个平台同时识别的特征。然后检查多源一致性:同一核心事实,在官网、公众号、行业媒体三处是否口径统一。这两项修完,再谈增量。
延伸阅读
AI 搜索的红利没有消失,只是换了一种领法——不再奖励最会喊的人,奖励最经得起追问的人。这三条信号,就是「经得起追问」的最低标准。