做 DeepSeek GEO 的人手里通常有一张”权重表”:四层信源金字塔、A/B/C 三级分类、术语密度和权威度打分……这些数字流传甚广,却几乎都出自服务商的”实测推演”,发布方自己就标注了”权重比例待验证”。2026 年 11 月 13 日,DeepSeek 在官方 API 文档更新日志里发布”全家桶应用 API”,第一次把这件事说清楚了一半——不是把权重规则公开给你,而是把搜索、抓取、拼上下文、生成引用这一整条链路,全收进了服务端。开发者拿到的,只有一个开关。
这一半的公开,恰好说明了另一半为什么猜不准:连开发者都拿不到”来源怎么筛、引用怎么呈现”的控制权,站外流传的权重表自然只能是对黑盒的逆向猜测。本期不重复 183 期”官方 vs 民间权重表”的框架,而是讲一个更少被讨论的问题——引用控制权到底在谁手里,以及你还能优化什么。
一、先把官方公告钉死:开放的是工具,不是算法
11 月 13 日 DeepSeek 官方 API 文档站点的公告,经官方中英文新闻页、开发者指南及多家独立报道交叉印证,可确认的硬事实有五条:
- 能力范围:把 DeepSeek App(含网页端)里的联网搜索、文件输入、阅读链接、语音交互、安全审核整合进原有 API,底层 Search、Fetch、OCR、ASR、TTS 也能单独调用。这是继 10 月 17 日自研搜索/抓取 API 之后的进一步开放。
- 承载模型与接口:跑在 V4.1-Flash(模型名
deepseek-flash)上,覆盖 Messages(兼容 Anthropic)、Responses、Chat Completions 三类接口。 - 搜索开关:非思考模式下打开
deepseek_web_search,模型自动发起网页或图片搜索、附引用作答;思考模式下打开同一工具,可在多步推理中自主联网并阅读链接,官方称为”深度思考搜索”;另有deepseek_read_url自动抓取消息里的链接。 - 架构是关键:官方 chatbot 指南写明,搜索与页面抓取由服务端执行、上下文由服务端拼装,客户端只展示返回的内容块并在下一轮原样回传。工具循环跑在 DeepSeek 侧,不在开发者侧。
- 官方明确的空白:搜索索引的规模未公开;搜索的来源筛选与引用呈现方式按 DeepSeek 默认规则走;工具调用在 token 费用之外单独计费(搜索与抓取每千次 5 元,OCR 每千页 1.5 元,语音识别限时优惠后每小时 0.39 元,语音合成限时优惠后每万字符 1.5 元)。
还有一条容易被忽略:官方同步开源了一份纯前端演示客户端 deepseek-ai/chat-demo(MIT 协议,11 月 12 日建仓,11 月 16 日约 3700 星),可以 1:1 复刻 DeepSeek App,官方明确”仅供演示”。Tech Times 11 月 16 日的核查还点出几处能力边界:语音识别单次最多 120 秒音频、不支持流式;纯文本解析会丢掉图表图片,更丰富的版式模式也可能漏掉部分数据;OCR 与语音服务未标注背后模型。
把这些放在一起读,结论很清楚:DeepSeek 开放的是”能不能调用这套能力”,不是”这套能力怎么给你排名”。把它读成”官方公开了引用算法”,是这两天最常见的误读。
二、引用控制权的三层分界:你能碰的、引擎碰的、谁都碰不到的
把这次公告拆开,GEO 从业者第一次能清楚看到一条控制权边界。它分成三层:
| 层 | 具体环节 | 控制权在谁手里 | 对 GEO 的含义 |
|---|---|---|---|
| 你能碰的 | 页面写什么、段落怎么切、数据带不带出处、实体口径是否一致 | 站点自己 | 唯一可直接优化的资产:送进检索池的材料质量 |
| 引擎碰的 | 搜什么、抓哪些页、拼哪些块进上下文、答案里怎么呈现引用 | DeepSeek 服务端,开发者也只有开关 | 只能适应,不能调参;任何”定向调参”承诺都应存疑 |
| 谁都碰不到的 | 索引规模、来源筛选规则、引用呈现规则 | 官方未公开 | 民间权重表只是在给这一层编说明书,不能当参数表用 |
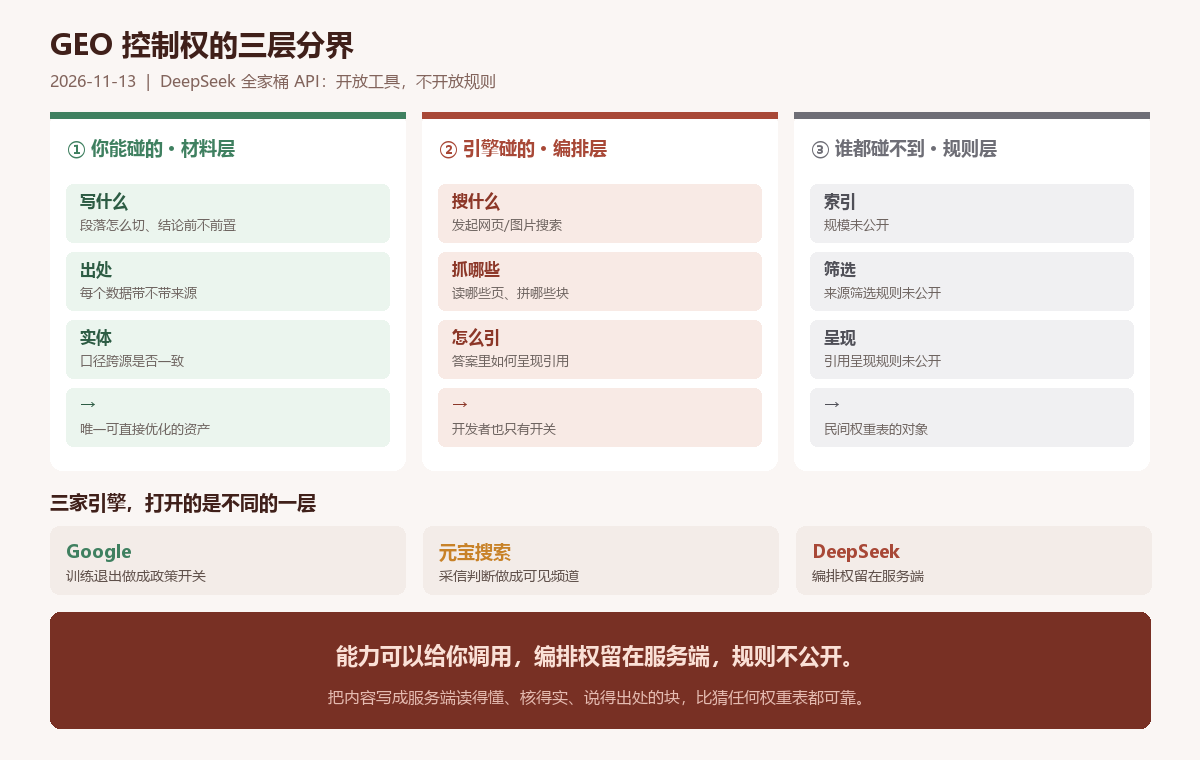
这张分界图能解释一个长期困惑:为什么”权重表”看起来有用,却从没人能拿它稳定复现结果?因为它描述的是第三层(未公开规则),而你真正能改的是第一层(材料质量)。中间隔着整个服务端编排——你的页面要先被检索到、被抓走、被拼进上下文,才轮到”权重”发挥作用。第一层不过关,后面两层根本不读你。
三家引擎最近把黑盒打开的方向,正好可以对照着看:
| 引擎 | 近期动作 | 打开的是哪一层 |
|---|---|---|
| Google(180 期) | robots.txt 统一训练退出令牌 | 把”要不要被训练”做成可配置的政策开关 |
| 元宝搜索(181 期) | 信源做成可见、可切换的频道入口 | 把”采信判断”做成用户能看见的界面 |
| DeepSeek(本期) | 全家桶 API 把检索编排收进服务端 | 把”调用能力”开放,但把编排规则留在服务端 |
三个方向完全不同。做跨平台 GEO 最忌讳的,就是把一家打开的那一层当成通用规律——拿元宝的频道逻辑去解释 DeepSeek,或者拿 DeepSeek 的权重表去指导 Google,都会错位。
三、为什么全家桶开放反而让”权重表”更不可信
这次公告最有价值的副产品,是它给”民间权重表”画了一条证伪线。流传最广的几套说法彼此矛盾:
- 分层数量就不一致:一套说四层金字塔(官方信源/一手数据/媒体/社区口碑),一套说 A/B/C 三类(A 类高权重官网、B 类行业媒体、C 类批量软文),还有本站 25053 期记录过的按 host 打五档观测——三套分类互相打架。
- 具体指标无法对应到任何公开接口:术语密度、数据引用规范性、论述逻辑完整性、
rerank_score/authority打分——这些名字在官方 API 文档里一个都找不到。 - 发布方自己留了退路:流传最广的四层金字塔原文末尾就写着”具体权重比例待验证”;另一些则明确标注”实测推演、非官方规则”。
关键不在于这些说法一定错,而在于它们的对象搞错了。它们描述的是”引擎内部怎么判断可信度”——也就是第三层;而这次官方说得很明白:这一层没公开,连调用 API 的开发者都只能通过开关使用,看不到里面的来源筛选与引用呈现规则。用一个自己都标”待验证”的推测,去指导一个官方没开放的黑盒,不可能稳定复现。
更值得注意的是触达面的变化。既然任何人都能用开源 demo 1:1 复刻 DeepSeek App,那么你的内容一旦被这套检索链路抽走,就可能在 DeepSeek 官方 App 之外,同时出现在所有接了全家桶 API 的第三方应用里——而且这些应用的引用呈现都走 DeepSeek 默认规则。GEO 的监测范围,也要从”官方入口”扩到”哪些第三方应用在调这套 API”。
四、你还能优化什么:把内容写成”可直接拼进上下文的块”
控制权边界划清之后,动作反而变简单了——只盯着第一层,把材料做成服务端低成本、高置信就能抽走的样子。
- 1)一段一答,结论前置。服务端拼上下文时要的是能整段搬走的答案块,不是需要读者通读全文才能拼出结论的铺陈。每个 H2 下面先给一句可独立成立的答案,再展开论据——这和 179 期讲的段落级验收、25027 期讲的搜索 API 验收是同一件事在不同引擎上的落地。
- 2)每个数据带出处,实体口径跨源一致。服务端无法替你核实一个孤立的数字,但能识别”这个说法有可追溯的出处”。品牌名、地域、类目、参数在官网与第三方渠道保持一致,是 183 期和 25059 期反复强调的地基,在 DeepSeek 这里同样成立。
- 3)别买”定向调 deepseek_web_search”的服务。来源筛选和引用呈现按官方默认规则走,开发者拿不到旋钮——任何声称能针对这个工具调参、买位、加权的承诺,在架构上就不成立。预算应该投在材料质量与结构化上。
- 4)监测加上”第三方应用”这一列。既然全家桶 API 让复刻变得容易,引用信号就不再只来自 DeepSeek 自己的入口。做监测时记录”这条引用出现在哪个应用”,比只盯官方 App 更接近真实的触达面。
FAQ
Q:全家桶 API 开放,是不是等于 DeepSeek 公开了引用算法?
不是。开放的是”能不能调用这套能力”——联网搜索、读链接、文件解析、语音等工具的参数与计费。来源筛选规则、引用呈现规则、索引规模都没有公开,官方 chatbot 指南还明确说上下文由服务端拼装、客户端不参与编排。看到”官方公开算法”的说法,先问一句:公开的是工具层还是规则层?
Q:那网上那些”DeepSeek 信源权重表”还能不能用?
可以当观测假设,不能当参数表。几套流传版本连分层数量都互相矛盾(四层/三级/五档),发布方自己标注”权重比例待验证”,而且描述的是官方未公开的那一层。真正可控的是材料质量:段落可抽取性、数据可核验性、实体一致性——这些在任何一套说法里都成立,且不依赖权重数字。
Q:1:1 复刻 DeepSeek App 对我的站点有什么实际影响?
主要是触达面扩大。官方开源了 MIT 协议的 chat-demo,任何开发者都能搭出体验相近的应用,而这些应用都走同一套服务端检索与默认引用规则。你的内容被抽走后,可能同时出现在多个第三方应用里。监测表建议增加”出现在哪个应用”一列。
Q:这和 180 期的 robots.txt 退出训练、181 期的元宝频道入口怎么区分?
三件事打开的是三层。robots.txt 管的是”要不要被拿去训练”;元宝把”采信判断”做成用户可见的频道;本期讲的是 DeepSeek 把”检索编排”收进服务端、只对外开放开关。同一家站点可以同时应对这三件事,但不能互相套用打法——尤其是别把元宝的频道逻辑搬来解释 DeepSeek。
结语
11 月 13 日这次开放,最值得记住的不是那五个工具名,而是官方把边界画在了哪里:能力可以给你调用,编排权留在服务端,规则不公开。这对 GEO 从业者其实是个好消息——它把”我该优化什么”从一堆玄学权重里解放出来,回到一个朴素的判断:服务端只会拼走它读得懂、核得实、说得出处的块。把内容写成这样的块,比猜任何权重表都可靠。