多伦多大学的 Mahe Chen 与 Nick Koudas 做了一项 2026 年规模最大的 AI 引用对照研究——158,099 条回答、468,037 条引用、两组各 90 天的商业问答。25047 期已经讲过它最出名的那条结论:页面属性能解释的引用差异只有 2.8%,而引擎自己的检索能解释 32%。但论文里还藏着一条同样重要、站内却从没展开过的发现,它解释了一个很多人遇到的怪事:有些品牌明明没有任何页面在说它,AI 却照样把它写进了答案。
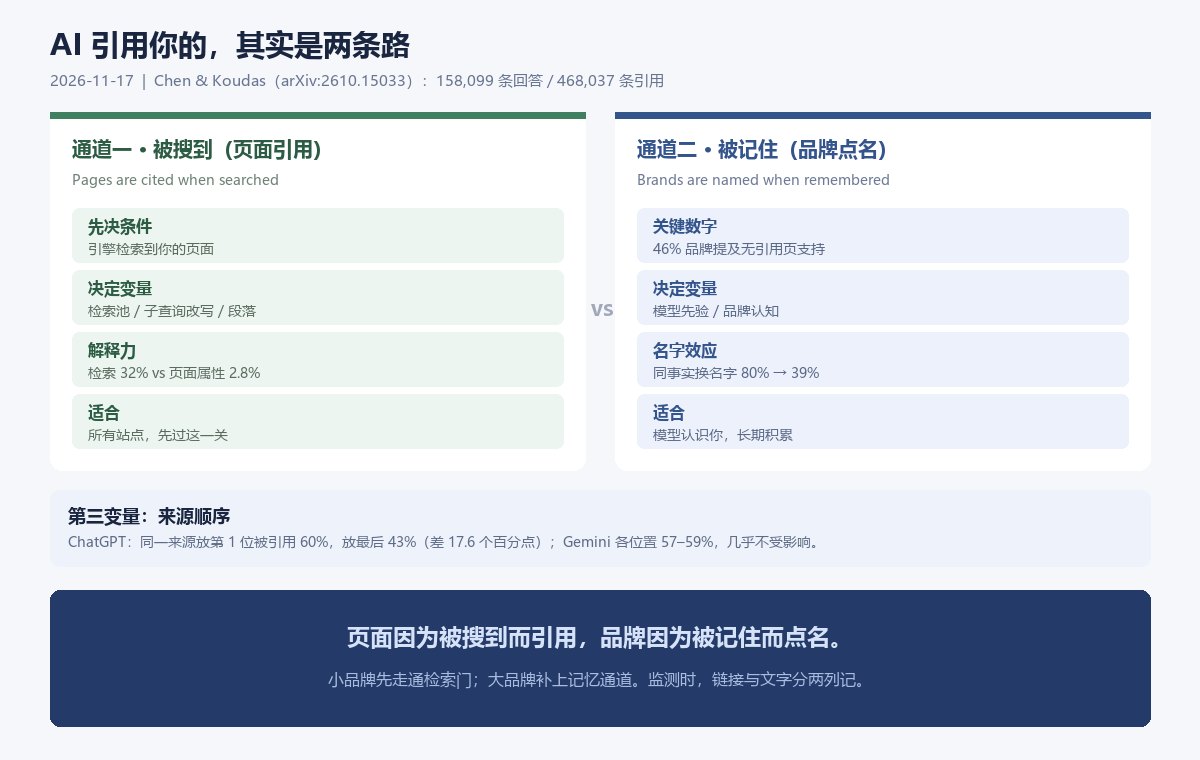
论文的原话是:“Pages are cited when searched; brands are also named when remembered.”(页面因为被搜到而引用,品牌因为被记住而点名。)引用和点名,走的是两条不同的路。这一篇就讲这两条路,以及它们对你意味着什么。
一、一个反直觉的数字:46% 的品牌提及没有出处
研究者先做了一件很聪明的事:把搜索引擎的联网功能关掉,直接问模型”这个问题你会推荐哪些品牌和网站”,测出模型脑子里本来就有什么(论文称为 prior,先验)。然后回头核对真实答案里那些”用户问题里根本没提到、模型自己说出来的品牌”,看有没有被引用页面在给这个品牌背书。
结果:ChatGPT 提到的这类”额外品牌”里,46% 没有任何一条引用页面提到这个品牌。也就是说,接近一半的品牌点名,是模型从记忆里直接写出来的,不是从网页上抄来的。这几个数字把机制钉得很死:
| 测量项 | 数值 | 怎么读 |
|---|---|---|
| 品牌在模型先验里时,被写进检索词的比例 | 67%(不在先验时仅 11%) | 模型想得到的品牌,会被它主动搜出来 |
| 先验里的网站,排名与被引优势 | 排名高 1.38 倍,同等排名下被引几率 1.60 倍 | 模型偏爱我本来就认识的站 |
| ChatGPT 引用来自”无需搜索就能点名的网站” | 47%(换用别的问题的先验作基线只有 25%) | 近半引用指向模型本就熟悉的站点 |
| 问题未点名的品牌提及中,无引用页支持的比例 | 46% | 接近一半的品牌点名,凭的是记忆不是证据 |
| 先验里的品牌,在同等引用支持下的点名几率 | 5.8 倍 | 记忆本身就是一个独立的放大因子 |
这里必须说清一个边界,避免被自媒体写歪:46% 说的不是”关掉搜索后 46% 的回答在瞎编”,而是”在模型主动提到、且用户没问的品牌里,46% 找不到一条点名它的引用页”。它是”品牌能被凭记忆点名”的证据,不是”答案错误率”。把它讲成”AI 有一半在胡说”是误读。
二、品牌名本身就是一个排序变量:同事实,换个名字排名就变
更硬的证据来自对照实验。研究者做了 60 组测试:每组一个真实问题、五个事实完全相同(等长、同措辞、同顺序、同长度)的产品档案、每个产品配一条第三方摘录,然后独立地显示或遮蔽品牌名与出版者名,共 1,920 次回答。因为每个答案恰好有三个产品进前三,显示名字不可能让所有品牌一起受益,所以比较的是”每个产品进前三比率的变化”相对于重复测试的基线。
- 品牌名的作用远大于出版者名:显示品牌名带来的排名变化,是重复基线的 2.1 倍(ChatGPT)和 3.3 倍(Gemini);显示出版者名只有 1.3 倍和 1.6 倍。换句话说,是”谁的产品”在起作用,不是”谁报道的”。
- 具体品牌的涨跌非常剧烈:Spectrum 一旦被点名,在 ChatGPT 上掉 33 个百分点;Google Fiber 涨 12,小厂商 Loopio 涨 16。原因很直白——在光纤宽带问题上,模型把”有线电视供应商”这个记忆带了进来,于是同样的参数,排名被品牌认知重写了。
- 即使明说”这些名字是随机分配的、不含任何信息”,名字效应依然存在:同一份产品档案,用一个名字时有 80% 的答案进前三,换成另一个名字只有 39%。品牌名的增益与”这个名字本身引发的联想”高度相关(Spearman 0.81),而与”遮蔽状态下能否认出这份档案”无关。
这解释了一个常见困惑:为什么把参数、功能写得一模一样,AI 推荐里却总有它更偏爱的那几个名字?因为这些名字进入模型时,不只是字符串,还带着模型多年来对它们的认知。事实相同,名声不同,答案就不同。
三、还有第三个变量:答案里”先读到的”更容易被引用
论文还测了来源顺序效应:给 100 个问题各准备 8 条真实来源,在 8 种排列下全部跑一遍,共 9,600 次回答。结果是——同一条来源,放在第一个位置时被 ChatGPT 引用 60%,放在最后一个位置时只有 43%,差 17.6 个百分点(95% 置信区间 15.1–20.3);而 Gemini 在各个位置都是 57–59%,几乎不受影响。
这条结论有两层含义。第一,ChatGPT 的”引用排序曲线”里,有一部分是位置偏差造成的,不完全是它认为来源更好;第二,不同引擎的机制真的不同——把”顺序偏差”当普遍规律套到 Gemini 上就是错的。这和 181 期讲元宝、185 期讲 DeepSeek 的启示一致:跨引擎不能照搬打法。
四、对你意味着什么:引用与点名要分开做
把三条发现合起来,GEO 的目标函数就该拆成两个,而不是一个:
| 通道 | 发生条件 | 决定性变量 | 你该做什么 |
|---|---|---|---|
| 被搜到 → 页面引用 | 引擎检索到你的页并抽走段落 | 引擎检索池、子查询改写、段落可摘性 | 过检索门(25047 期四道关卡)、写可自包含段落 |
| 被记住 → 品牌点名 | 模型先验里有你,无需页面支撑 | 品牌认知、全网一致表述、第三方权威密度 | 一致实体 + 第三方网络(25096 期 Citation Gravity) |
- 1)先判断你缺的是哪条通道。同样的”AI 没提我”,成因可能完全相反:大品牌通常记忆充足、缺的是具体页面的引用;小品牌和新品牌往往是模型压根不认识——论文第二个数据集(55 个问题的小 B2B 市场)里,模型几乎不认识那些厂商,纯记忆回答的一致性只有 Kendall τ 0.36,靠搜索才恢复到 0.59。对小品牌,先把”被搜到”这条路走通,比纠结”怎么让模型记住我”更现实。
- 2)引用看链接,点名看文字,监测要分开记。25096 期已经量化过:引擎在”引哪个链接”上分裂、在”提哪个品牌”上收敛。所以监测表里”是否被引用”和”品牌名是否出现在答案文字里”应该是两列。你可能在链接列长期为零,却在文字列稳定出现——那说明记忆通道已经通了,只是没有页面被抽走。
- 3)别把”品牌名效应”做成玄学。论文说的是:名字会激活模型的既有认知。能做的是让这个认知准确且一致——全网实体表述统一、可核验事实绑定品牌名、第三方权威渠道反复印证。而不是幻想换个好听的名字就能翻盘;事实上 Spectrum 的案例说明既有认知也可能是负资产。
- 4)接受引用层的位置偏差,但不迷信它。在 ChatGPT 上,被排在前面的来源天然占优,所以”进池 + 靠前”值得投入;但这套位置效应在 Gemini 上几乎不存在。按引擎分别设验收标准,别用一个 KPI 拷所有引擎。
FAQ
Q:46% 的品牌提及没有出处,是不是说明 AI 答案有近一半不可信?
不是。这个数字的分母是”模型主动提到、且用户问题里没点名的品牌”,其中 46% 找不到点名它的引用页。它证明的是”品牌能被凭记忆点名”,不是”答案的错误率”。判断答案是否可信,仍要看具体事实 assertions 有没有证据支撑。
Q:这和 25047 期讲的”检索门 2.8% vs 32%”是什么关系?
同一篇论文的两条线。25047 讲检索门——页面要先被引擎搜到才谈得上引用,讲的是”页面引用”这一条通道;本期讲模型先验——品牌不需要页面就能被点名,讲的是”品牌点名”这条通道。前者是 Chen & Koudas 的 RQ2/RQ3 检索部分,后者是同一篇的 6.5/6.6 节模型知识部分。
Q:既然品牌名能改变排名,是不是改个名、或者多铺品牌词就能见效?
不是。实验里的名字效应来自模型对该品牌的既有认知(Spectrum 在光纤问题上被扣分),随机名字测试虽然也有差异,但那反映的是模型对”这个名字像什么”的联想,不是可控的杠杆。可操作的是让认知变得准确一致:实体统一、事实可核验、第三方印证——也就是 25096 期的第三方权威密度打法。
Q:小品牌是不是就没机会进”记忆通道”了?
短期内确实不是主战场。论文的小 B2B 市场数据说明,模型对小厂商几乎无记忆,纯记忆回答最不稳定(τ 0.36),靠搜索才稳定(0.59)。对这类品牌,先把检索路径做扎实——进引擎自己的检索池、页面有可摘段落、核心事实全网一致。记忆是长期被反复正确提及后才慢慢形成的结果,不是可以直接购买的开关。
结语
这篇论文最值得记住的,是它把”被 AI 提到”拆成了两件事:页面因为被搜到而引用,品牌因为被记住而点名。这两件事的变量不同、验收不同、对不同规模的站点难度也不同。搞清楚你缺的是哪一条,比笼统地问”我的 GEO 为什么没效果”要有用得多。