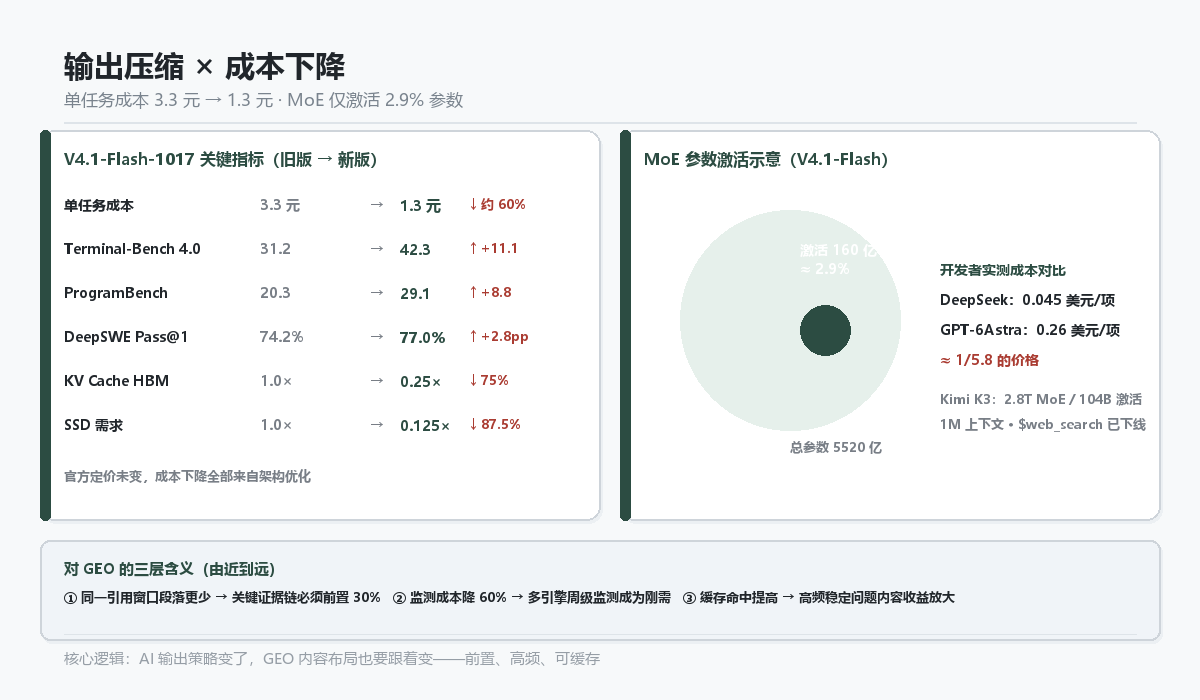
10 月 17 日,DeepSeek 上线 V4.1-Flash-1017。更新日志里有一句很直白的话:「输出更短、任务完成更快」。配合 MoE 架构优化和 KV 缓存压缩,官方测试数据是:单任务成本从 3.3 元降到 1.3 元,降了约六成。
用户社区的第一反应是调侃:「终于不啰嗦了」。但这句话对做 GEO 的人来说,远没有社区讨论的深度——它改变了 AI 回答你问题的物理结构,而这个结构直接决定了你的内容能不能被引用。
一、先看清楚:「变短」到底短在哪里
这不是简单砍字数。三个维度同时变了:
- 思考过程压缩——旧版会先输出一大段「分析思路」,新版直接给结论。Token 消耗少了,但任务完成率反而涨了:Terminal-Bench 4.0 从 31.2 分涨到 42.3,DeepSWE Pass@1 从 74.2% 升到 77.0%。
- 推理架构变了——MoE 混合专家架构下,总参数 5520 亿,但每次生成只激活约 160 亿(2.9%)。KV 缓存的 HBM 占用压到上一版的四分之一,SSD 需求压到八分之一。
- 成本结构变了,定价没变——API 单价不变,但单任务实际成本降约 60%。开发者实测(10 项编程任务):DeepSeek 平均 0.045 美元/项,对比 GPT-6Astra 的 0.26 美元,约 1/5.8 的价格。
换句话说:AI 用更少的算力干了更精准的活。这不是成本妥协,是架构效率提升——就像老手不用写满三页纸,几句话就能说清结论。
二、回答变短,对「能不能被引用」意味着什么
这是本次更新对 GEO 最直接的物理影响,但社区几乎没有讨论过:
AI 生成答案时,有一个隐性的「引用窗口」——它从检索到的多个信源里,挑选段落嵌入自己的回答。回答越短,这个窗口越小,能同时嵌入的段落数量就越少。
具体影响分两层:
- 段落竞争加剧——以前 AI 回答一段 800 字,可以塞 3 个不同信源的段落;现在回答 400 字,可能只留 1-2 个。原来排第二的引用段落,很可能被直接裁掉,用户根本看不到你的内容。
- 「自包含段落」价值翻倍——能被保留进短回答的段落,必须是「单独拎出来也成立」的:有数字、有结论、有来源。铺垫型段落(「我们先来看看背景……」)没有独立引用价值,在短回答里最先被裁。
146 期讲过信息密度线(15+ 独特数据点 vs 全网平均 4 个),这次更新让那个结论更具体了:密度达标是必要条件,但密度集中在页面最前面 30% 是充分的——因为 AI 取内容时,前置段落被截断的风险最低。
三、成本降了六成,GEO 预算该往哪挪
这是本次更新最被低估的杠杆。把几类监测的成本变化摆出来:
| 监测动作 | 此前节奏建议 | 本次更新后建议 | 成本变化 |
|---|---|---|---|
| 单引擎引用监测 | 月跑 1 次 | 月跑 1 次(维持) | 不变 |
| 多引擎交叉监测 | 季度 1 次(成本高) | 周跑 1 次(可行) | 单次成本 ↓ 约 60% |
| API 字段级诊断(authority/rerank) | 按需(贵) | 月度常态化 | 单次成本 ↓ 约 60% |
| 内容铺量(批量发稿) | 主力预算 | 削减 30-40% | ROI 持续下滑(70% 铺稿引用率已在下降) |
核心逻辑:成本下降打开的空间,不是让你「更便宜地铺更多稿」,而是让你把预算从「铺量」转「监测」——现在多引擎周级监测的成本已经足够低,是 ROI 最高的动作。
四、缓存命中:高频稳定问题的内容收益被放大
还有一个更隐蔽的机制:KV 缓存压缩后,AI 处理高频问题时,更倾向于直接命中缓存,而不是重新搜索。
这意味着内容类型不同,收益方向完全不同:
| 内容类型 | 缓存命中影响 | GEO 策略 |
|---|---|---|
| 高频稳定问题(行业方案/产品选型) | 收益放大:被命中一次后,后续大量请求直接复用 | 确保该问题的核心答案段落「自包含」,放在页面最前 30% |
| 时效性内容(新闻/价格/活动) | 无收益:缓存命中对你无意义,AI 会绕过缓存直接搜索 | 提高更新频率,145 期讲的时效衰减曲线仍适用 |
| 长尾细分问题 | 低频但命中率高:一旦进入缓存,持续引用周期更长 | 优先做细分场景的深度内容,而不是泛化内容 |
五、GEO 内容布局的三个具体动作
基于以上分析,现在可以落地三件事:
- 把核心证据链前置到前 30%——每篇内容的第一屏内,必须有:核心数字 + 明确结论 + 可核验来源。不要「铺垫三段再给数据」。AI 取前 30% 时,拿到的应该是完整证据链,不是引言。
- 每段末尾加「可独立引用句」——判断句格式:「数据显示……因此……」/「对比来看,……的结论是……」。这种句子即使被单独抽出来嵌入短回答,逻辑也是完整的,不依赖上下文。
- 把监测预算从铺量转出来,周级跑一次多引擎——固定 10-20 个核心问题,在 DeepSeek、豆包、Kimi 各跑一遍,记录引用出现/消失/降级。成本已经降了六成,这是现在性价比最高的动作。
六、常见问题
回答变短了,原来做的一批 GEO 内容还有效吗?
基本有效,但优先级要重排。输出压缩不会改变「什么内容容易被引用」的底层规则——事实密度、多源一致性、权威信源仍然是核心。变化的是引用窗口的竞争格局:同样篇幅的引用池里,能挤进去的段落数量减少了,原来排第二、第三的内容段很可能被裁掉。实操建议:把你现有内容里最关键的「可引用段落」(数据+结论+来源)往页面最前面移,后移的段落被截断的风险明显上升。
多引擎监测的频率可以因此提高吗?预算怎么分配?
可以,而且这是本次更新对 GEO 操作层面最直接的利好。API 单价未变但单次调用成本已降约六成,跑 10 个问题的监测周期从「月跑一次」可以升级到「周跑一次」。预算分配建议:把原来给「内容铺量」的预算转 30-40% 到「多引擎监测」——现在监测成本下降后,这是 ROI 最高的杠杆。147 期讲过三把尺子(一致性/孤证密度/发布量-引用率比),这些尺子都需要定期跑数才有意义。
KV 缓存压到 1/4,对内容方有什么实际影响?
直接影响是:AI 能同时处理更多并发请求,意味着「同一个问题被不同用户问到」时,AI 更有可能直接从缓存里拿答案,而不是重新搜索。缓存命中的前提是问题语义稳定,如果你的内容回答的是一个高频稳定问题(比如「XX 行业有哪些主流方案」),被缓存命中的概率也更高。反过来,如果你的内容是新闻/时效性强的内容,缓存命中对你没意义——AI 会绕过缓存直接搜索,时效性内容反而需要更高的更新频率。
「少而准」的输出策略,对内容结构有什么具体要求?
核心要求是:前 30% 的内容必须是「自包含可引用段落」——有数字、有结论、有来源,单独拎出来也能成立。具体来说:①页面开头 3 段内必须出现核心数据(15+ 独特数据点,146 期讲过);②关键结论紧跟数据,不要「先铺垫再给数字」;③每个段落末尾加一句可独立引用的判断句(「数据显示……因此……」)。这样即使 AI 只取前 30%,拿到的也是完整证据链,而不是铺垫。
延伸阅读
AI 的回答在变短,但被引用的门槛没有降低——只是更残酷了:同样的窗口里,能进几段,少了一半。你的内容如果还在「先铺垫再给结论」的节奏里,被裁掉的概率只会更高。把证据链往前挪,把监测频率拉起来,这两件事现在都比多铺十篇稿子更值得。
《AI 的回答变短了,GEO 的性价比账怎么算》有一个想法