有位做企业服务的朋友最近很困惑。他三个月前发的一篇内容,当时被豆包当成回答「这类方案怎么选」的主要参考;这个月再问同一个问题,AI 提到的还是那批事实,但引用的已经不是原来那一整段,而是把答案拆成更细的几条,从不同页面上分别抽出来拼的。
他问我:是不是我内容退步了?
都不是。是 2026 年 9 月这一个月里,AI 搜索的「读法」集体升级了。
一、9 月这一个月,三家模型接连动了大手术
把时间线摆出来,你会看到这不是巧合,而是一次同步转向:
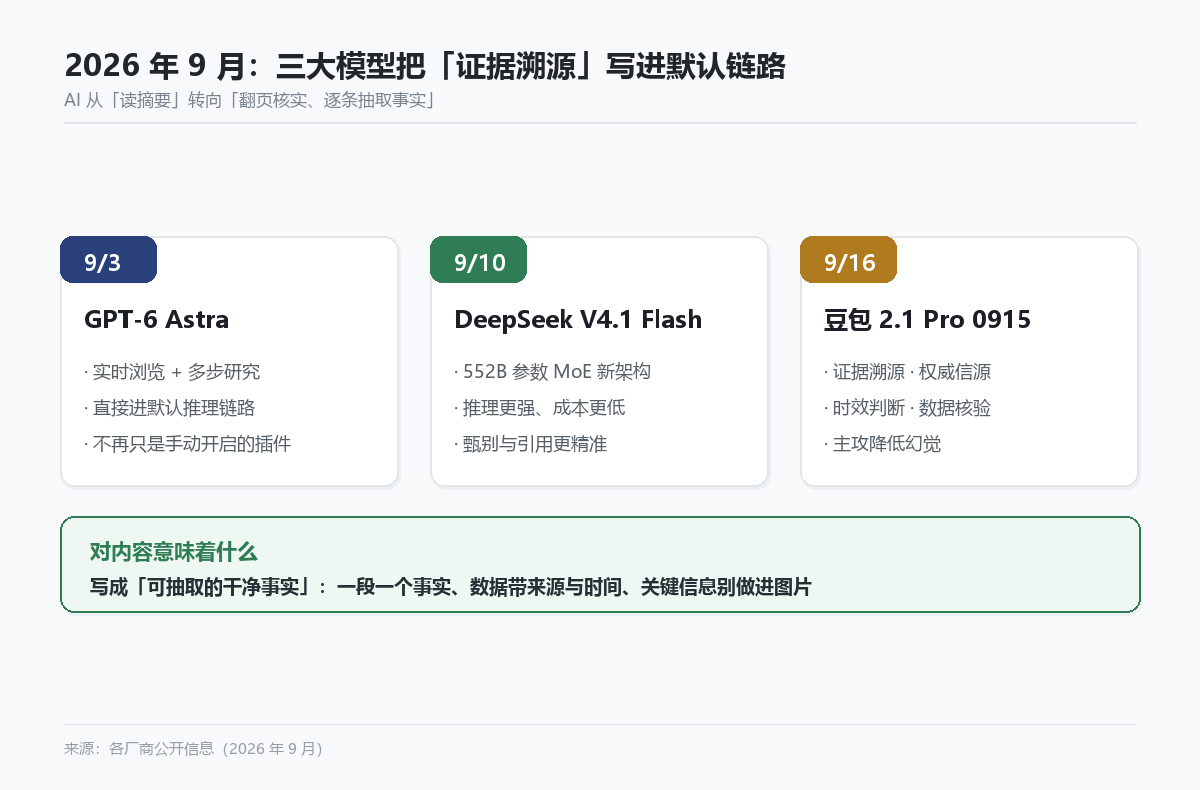
| 日期 | 模型 | 关键变化 | 对内容意味着什么 |
|---|---|---|---|
| 9/3 | OpenAI GPT-6 Astra | 把「多步网页研究 + 电脑操作」直接写进默认推理链路,不再只是要手动开启的插件;会打开页面、逐条提取事实再组装答案 | 内容要经得起被「逐条摘取」 |
| 9/10 | DeepSeek V4.1 Flash | 552B 参数 MoE 新架构,推理更强、成本更低;公开信息称性能、费用、速度全面超越上一代,随后旧模型请求被全量路由到新模型 | 模型甄别、对比更精准,结构乱的内容更容易被略过 |
| 9/16 | 豆包 2.1 Pro 0915 | 官方明确强化「证据溯源、权威信源检索、时效判断、数据核验」四项能力,主攻降低幻觉 | 没有来源、时间、口径的内容会先被筛掉 |
据公开信息,豆包这个新版本在一次演示里可以调度 500 多个子 Agent、检索 1000 多个网页做交叉比对;DeepSeek 也把旧模型的请求全部切到了新模型。这些厂商动作指向同一件事:模型正在从「读片段」转向「做核验」。
二、底层变了:以前是「看摘要」,现在是「翻页核实」
过去,AI 回答你的问题,多半是拿搜索引擎已经切好的索引片段来拼;现在,尤其是升级后的版本,它会真的打开页面、读正文、挑事实。几个可参考的数字:
| 指标 | 数值 | 口径来源 |
|---|---|---|
| ChatGPT 搜索每周查询量 | 约 2.5 亿 – 5 亿次 | StackMatix |
| ChatGPT 在 AI 搜索中的份额(2026 Q1) | 约 61.4% | StackMatix |
| ChatGPT 搜索引用与 Bing 前十结果的重合度 | 约 87% | 第三方观测 |
| 第三方内容被引频次 ÷ 品牌官网 | 约 3 倍 | Peec AI 口径 |
| 我国生成式 AI 用户规模(2025-12) | 6.02 亿(普及率 42.8%) | CNNIC 第 57 次报告 |
| AI 原生 App 月活(2026-06) | 4.99 亿,同比增 85.4% | QuestMobile |
结论很直白:模型越是「翻页核实」,你页面里的信息就越要「摆得清清楚楚、随手能抄走」。能一眼被抽出来的事实会被引用;需要模型自己去理解、归纳的段落,容易被跳过。
三、什么样的内容,会被「抽不出来」
升级之后,这几类内容最容易在被浏览时漏掉:
- 事实埋在长段落里:结论和数据混在几百字的叙述中,模型翻到了也抓不住重点;
- 数据缺「三件套」:只给一个数字,没有口径、时间、来源,等于不可核验,模型不敢用;
- 关键信息做成了图片:价格表、参数图、流程图,机器读不到,等于不存在;
- 正文依赖脚本渲染:模型翻页看到一个空壳,实际内容要么没渲染,要么藏在交互后面。
四、五条改造清单,照着改就行
- 一段一个事实:把「一段讲三件事」拆成「一段一个结论」,原子化之后才方便被抽取;
- 数据补三件套:每个关键数字后面跟口径、时间、来源,最好来源可点击;
- 用清单、表格、FAQ 承载答案块:让「可直接抄走的答案」以独立模块存在,而不是散在散文里;
- 补结构化数据:Organization、Product、FAQPage 等标记齐上,并保证关键信息在禁用脚本时依然可见;
- 把时效写出来:页面底部放「最后更新」时间,参数、案例、报价按季度核一遍。
五、一个反例:为什么「捷径」越来越不好使
9 月还有一条容易被忽略的消息。据第三方监测机构 Prompt Watch 的数据,ChatGPT 回答中 Reddit 内容的引用占比,从 7 月 18 日到 8 月 7 日的 3.83%,跌到了 8 月中旬的 0.5%。期间 8 月 8 日,ChatGPT 调整了搜索规则,把抓取重心从「全网开放扫描」转向「特定站点」。
业内普遍推测,导火索是此前被大量使用的「在 Reddit 刷品牌提及」操作。平台上线了 AI 垃圾信息举报工具,模型也在识别这类作弊——逻辑和当年搜索引擎打击 SEO 作弊一样:一旦发现有人利用规则漏洞刷排名,就对整个信源降权。
这条新闻对做 GEO 的人价值很大:靠投毒、刷量换来的引用,是会被成批「收回」的。真正稳的,还是内容本身经得起核验。
六、几个被问得最多的问题
问:我之前发的内容,是不是白做了?
不白做。事实和数据不会贬值,需要补的是「可抽取性」——把埋在段落里的事实拎出来,补上来源和时间。这是改造,不是重写。
问:这波升级主要影响哪些平台?
目前动作最明确的是豆包、DeepSeek 和 ChatGPT 系。但「证据溯源 + 实时浏览」是共同方向,其他平台大概率跟进,按同一套标准改内容,不会亏。
问:内容是不是要写得更长?
不建议。模型要的是「信息密度高、能直接抄走」,不是字数。同样的事实,能用表格和清单表达,就比散文更容易被抽取。
问:怎么验证改造有没有效果?
用具体的真实问题去问 AI,看它引用的内容是不是变得更准、更细;同时盯自己的页面,确认关键事实在「禁用脚本」的情况下依然可见。方向对了,再谈量。
今天就能做的一件事:挑你最重要的一篇内容,把里面的数字全部圈出来,逐个问自己三个问题——口径是什么?什么时间的?来源在哪里?三个都答不上的,就补上。这就是「翻页核实」时代最划算的一步改造。
模型升级的速度,往往快过大多数企业的内容迭代速度。与其追每一次版本号,不如回到那个一直没变的要求:把事实写清楚,让机器抄得走,让第三方替你说话。版本会一直变,这一条不会。