你写了 50 篇内容,六个引擎加起来才引了十几次。不是内容不够好,是你每个引擎都只喂了同一种格式。豆包主要吃问答体、通义吃叙述段、DeepSeek 吃表格——你一份”通吃稿”发出去,每个引擎都只能吃到一角。本篇讲怎么把”同一个知识点”拆成三种格式、命中不同引擎,以及为什么这三版的事实数字必须一模一样。
一、为什么”同一篇通投”会漏掉大部分引用
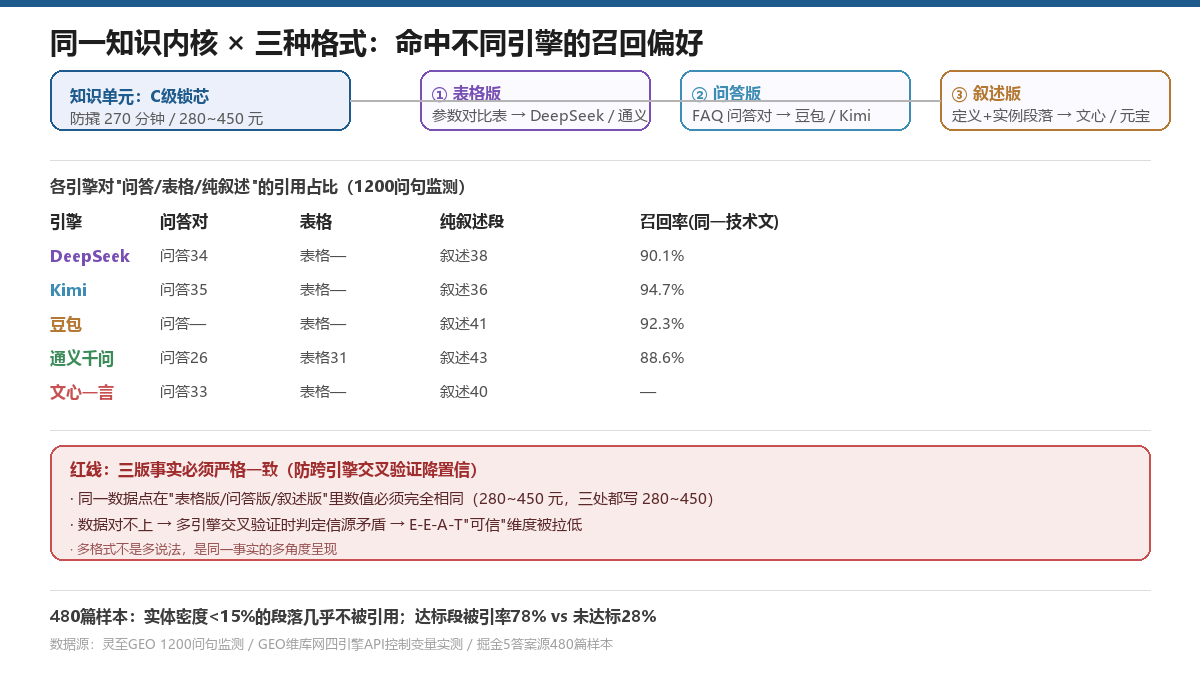
灵至 GEO 对 1200 个固定问句做了格式分类监测,结果很直接:不同引擎对”问答对/表格/纯叙述段”三种写法的引用占比差异很大——通义把 43% 引用给了纯叙述段,豆包把 41% 给了叙述、Kimi 把 35% 给了问答。没有哪两种引擎的格式偏好分布完全重合。
结论:同一个核心知识点,如果只写成一种格式(比如全是叙述段),你只能吃到偏好叙述的引擎(通义/豆包),DeepSeek、Kimi 这种偏好表格和问答的引擎基本吃不到。覆盖引擎的数量,和”每个引擎喂了它偏好的格式”强相关。
二、知识单元-格式变体矩阵:一表一答一叙
落地方法叫”最小可行配置”:每个核心主题至少做三个格式变体,知识内核(事实/数据/结论)完全一致,只有组织形式不同:
| 格式变体 | 承担什么引用需求 | 主要命中的引擎 | 写法要点 |
|---|---|---|---|
| ① 表格版(参数/对比表) | 精确数值与横向对比 | DeepSeek / 通义千问 | 带表头的对比表,一行一实体 |
| ② 问答版(FAQ 问答对) | 长尾问句直接匹配 | 豆包 / Kimi | 问题式标题 + 短直接答案 |
| ③ 叙述版(定义+实例段) | 语义深度与上下文完整 | 文心 / 元宝 | 首句下定义 + 数据 + 实例 |
同一知识内核、三种形态、部署到不同页面或同页不同区块,就能把六个引擎的召回偏好尽量覆盖。这一招的前提是:三版事实数字必须严格一致,下面这条红线决定了它到底是增益还是负优化。
三、红线:三版数字不一致,会被跨引擎交叉验证打脸
六个引擎之间会交叉验证你的信息。如果”表格版写 C 级锁芯 280~450 元””叙述版写 300~500 元”,两个数字打架,AI 判定你的信源数据矛盾,E-E-A-T 的”可信”维度直接被拉低,所有格式变体的引用率一起降。多格式的目的不是”多说法”,是”同一事实的多角度呈现”。
格式变体矩阵自检三问:
一、三版的核心数据点(价格/参数/成立年限)是否逐字一致?不一致 = 直接返工。
二、每个变体是否对应了至少一个”偏好该格式”的引擎?没有对应 = 这版白做。
三、每个变体段落实体密度是否达标?(见下节)
四、实体密度 < 15%,写再多格式也白搭
掘金那份 480 篇样本的实测给了一个硬阈值:实体密度低于 15% 的段落,几乎不被引用;达标段被引率 78%,未达标段只有 28%。实体密度 = 品牌名/参数/日期这类”可验证实体”占正文字符比。格式变体做得再齐,如果每段全是形容词、没有实体数字,AI 切出来就是低信息碎片,召回阶段就被过滤。
维库网用同一篇云原生技术文做四引擎 API 控制变量实测,也印证了”结构化程度决定引用”:标准化、带结构化标注的技术内容,跨模型平均引用率提升 42.8%;豆包优先引用”步骤化流程+参数列表”,通义侧重”表格对比+性能数据”,DeepSeek 偏好”技术定义+代码片段”且信源标注率 83.6%,Kimi 长文本召回最高(94.7%)。
FAQ
Q:三个格式变体,是要发三篇不同的文章吗?
A:不一定。可以三篇不同页面,也可以是同一页的三个区块(表格区/FAQ 区/正文叙述区)。关键是”知识内核一致 + 部署到能被对应引擎抓取的生态”。同一页做对 AI 切片也友好,因为每个区块语义边界清晰。
Q:怎么知道我的内容实体密度有没有到 15%?
A:粗略算法数一下正文里”可验证实体”(数字/品牌/参数/日期/地名)占多少字符。15% 是那个 480 篇样本的达标线,你可以先按”每百字至少 3~4 个具体数据点”来卡,明显不达就补数据。
Q:和 166 期”看引擎吃什么”是什么关系?
A:166 期解决”铺哪个渠道”(渠道决策),本篇解决”内容怎么写成三种格式”(内容形态)。先按 166 定主打引擎和生态,再按本篇把每个知识点做齐三个格式变体。两者配套用。
Q:数据对不上会被降权吗?怎么防?
A:会。跨引擎交叉验证发现矛盾会拉低信源置信。防法:建一张”知识单元-事实数据”总表,所有格式变体只从这张总表取数,改一处全处同步,绝不让三个版本各自写数字。
延伸阅读
- 先别铺渠道,看你要打哪个引擎”吃什么”——渠道决策(166 期)
- 你和竞品写的一样,AI 只会引用一个——MMR 同质降权(165 期)
- AI 的答案是流动的:GEO 没有”做完”,只有”复测”——月度复测(159 期)
同一事实,三种说法;六个引擎,各喂一口。 事实对不上,就全输。
{
“@context”: “https://schema.org”,
“graph”: [
{
“@type”: “Organization”,
“@id”: “https://www.geoshizhan.com/#org”,
“name”: “GEO实战”,
“url”: “https://www.geoshizhan.com/”
},
{
“@type”: “WebSite”,
“@id”: “https://www.geoshizhan.com/#website”,
“url”: “https://www.geoshizhan.com/”,
“publisher”: {
“@id”: “https://www.geoshizhan.com/#org”
}
},
{
“@type”: “Article”,
“headline”: “同一件事,写三遍才配得上六个引擎”,
“description”: “六个引擎对\”表格/问答/叙述\”三种写法的引用占比完全不同:通义吃叙述段、豆包吃问答、DeepSeek吃表格。同一核心知识点要按三种格式各做一版,分别命中不同引擎的召回偏好。但三版的事实必须严格一致——数据对不上,跨引擎交叉验证时置信度直接崩。这是\”知识单元×格式变体\”矩阵。”,
“datePublished”: “2026-11-06”,
“dateModified”: “2026-11-06”,
“author”: {
“@type”: “Organization”,
“name”: “GEO实战”
},
“publisher”: {
“@id”: “https://www.geoshizhan.com/#org”
},
“image”: “https://www.geoshizhan.com/wp-content/uploads/2026/11/geo_167_cover.png”,
“mainEntityOfPage”: “https://www.geoshizhan.com/geo-knowledge-unit-format-variants-2026/”,
“isPartOf”: {
“@id”: “https://www.geoshizhan.com/#website”
}
},
{
“@type”: “FAQPage”,
“mainEntity”: [
{
“@type”: “Question”,
“name”: “三个格式变体,是要发三篇不同的文章吗?”,
“acceptedAnswer”: {
“@type”: “Answer”,
“text”: “不一定。可以三篇不同页面,也可以是同一页的三个区块(表格区/FAQ区/正文叙述区)。关键是\”知识内核一致+部署到能被对应引擎抓取的生态\”。同一页做对 AI 切片也友好,每个区块语义边界清晰。”
}
},
{
“@type”: “Question”,
“name”: “怎么知道我的内容实体密度有没有到 15%?”,
“acceptedAnswer”: {
“@type”: “Answer”,
“text”: “数正文里可验证实体(数字/品牌/参数/日期/地名)占多少字符。15% 是 480 篇样本的达标线,可先按\”每百字至少 3~4 个具体数据点\”来卡,明显不达标就补数据。”
}
},
{
“@type”: “Question”,
“name”: “和 166 期\”看引擎吃什么\”是什么关系?”,
“acceptedAnswer”: {
“@type”: “Answer”,
“text”: “166 期解决\”铺哪个渠道\”(渠道决策),本篇解决\”内容怎么写成三种格式\”(内容形态)。先按 166 定主打引擎和生态,再按本篇把每个知识点做齐三个格式变体。”
}
},
{
“@type”: “Question”,
“name”: “数据对不上会被降权吗?怎么防?”,
“acceptedAnswer”: {
“@type”: “Answer”,
“text”: “会。跨引擎交叉验证发现矛盾会拉低信源置信。防法:建一张\”知识单元-事实数据\”总表,所有格式变体只从这张总表取数,改一处全处同步,绝不让三个版本各自写数字。”
}
}
]
}
]
}