10 月 24 日凌晨,月之暗面发布 Kimi K3.1 Pro。3 万亿级参数、100 万 token 上下文、多模态——这不是普通的一次迭代,是上下文窗口从 128K 时代正式跨进 1M 时代的标志。
同一周,DeepSeek V4.1-Flash 也把上下文推到了 100 万 token,OpenRouter 数据显示中国大模型周调用量连续 25 周超过美国,全球前五全部是中国模型。
把这些数据放在一起看,会发现一个被社区忽略的结构性变化:AI 能读多少,和 AI 怎么引用,是两件事。上下文变大了 8 倍,但绝大多数 GEO 布局还在「详情页时代」的节奏里。
一、先看清楚:这次模型迭代到底变了什么
把 10 月 24 日的关键数据摆出来:
| 指标 | K3.1 Pro 数据 | 对比参考 | GEO 影响 |
|---|---|---|---|
| 总参数 | 3 万亿级(2.8T 官方) | 全球最大开源模型 | 知识容量大幅提升 |
| 上下文窗口 | 100 万 token | 旧版约 128K,扩大约 8 倍 | 能一次读完白皮书+FAQ+案例 |
| 幻觉率(压力测试) | 8.3% | K3 为 23.4%,降 15.1pp | 模糊表述/孤证更易被识别排除 |
| 金融跨文档能力 | OfficeQA Pro v2 + SpreadsheetBench v2 均超最强闭源 | 端到端交付 | 行业报告/白皮书真正被「读懂」 |
| 价格(vs GPT-6 Astra) | 约 1/5 | 输入缓存命中 1.3 元/百万 token | 多引擎高频监测成本进一步下降 |
注意两个容易被误读的点:①「上下文大」不等于「AI 真的会用满」——检索质量和排序策略才是决定引用结构的核心;②幻觉率下降对 GEO 是双刃剑——AI 不再「替你补充」模糊表述,只引用它能确认的。
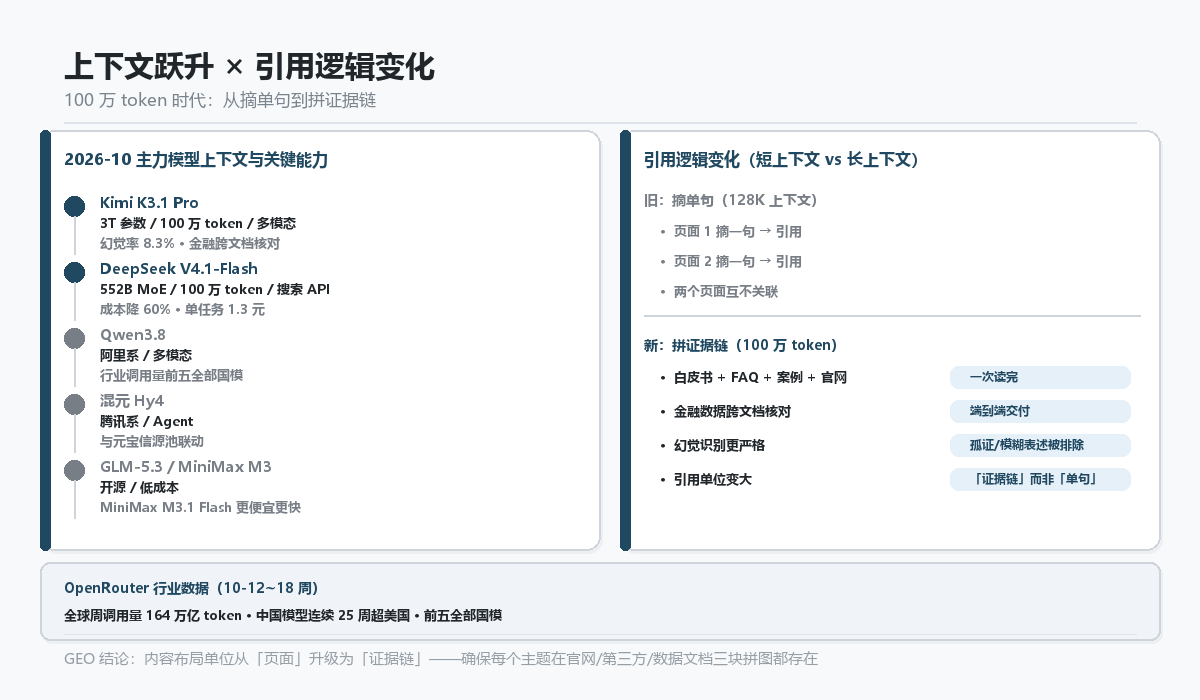
二、上下文变大,引用逻辑从「摘单句」变「拼证据链」
这是本次模型迭代对 GEO 最深层的影响,但几乎没有被讨论过:
128K 上下文时代,AI 读你的官网,引用单位是「一个页面里的一句」——详情页写得好不好,基本决定了你能不能被引用。
1M 上下文时代,AI 能同时读「白皮书 + 官网 + 第三方评测 + 行业报告」,引用单位变成了「证据链」——它会在多个信源之间交叉验证,而不是单独评价某一个页面。
这意味着:单个页面的权重在下降,信源体系的完整度在上升。你的官网写得再完美,如果第三方信源里找不到交叉印证,AI 完成证据链拼图时缺的那一块,会让你的内容在重排时掉档。
24921 期讲过「AI 一次回答只引几家」,那是在引用集中度上的结论;这次模型迭代把逻辑往前推了一层:不只是「引几家」,而是「引一个体系」——证据链完整的体系优先,孤立的优质页面反而容易被漏掉。
三、幻觉率压到 8.3%,「模糊表述」的代价变大了
K3.1 Pro 的幻觉率从 K3 的 23.4% 压到 8.3%。这个数字对内容方意味着什么?
旧模型在 23.4% 幻觉率下,遇到「行业领先」「卓越品质」这类模糊表述,大概率原样复述进答案——因为「无法核验」和「模糊」的边界没那么严格。
新模型在 8.3% 下,识别「可核验事实 vs 不可核验声明」的能力大幅提升。模糊表述被识别为「无法确认的声明」,在重排时会被系统性降权。
实操清单(写完内容后逐项过):
- 每篇内容里,形容词占比超过 20% → 重写,把形容词替换为「数字 + 时间 + 来源」
- 关键事实(资质/案例/报价)找不到第二个独立信源 → 先铺信源再发内容
- 白皮书里的关键数据没有标注采集时间和口径 → AI 无法核验,引用概率大幅下降
四、B 端内容布局:从「详情页」升级为「证据链拼图」
金融研究类能力的跃升,对 B 端 GEO 的影响最大。把内容体系按「拼图」逻辑重新排布:
| 拼图块 | 内容类型 | AI 怎么用(长上下文) | 优先级 |
|---|---|---|---|
| 事实底座 | 官网核心数字(成立年限/服务客户数/资质编号) | 跨文档核对时作为锚点,数字不一致直接降权 | 最高 |
| 证据层 | 行业白皮书 / 技术文档 / 合规说明 | 长上下文下被真正「读懂」,可提取结构化结论 | 高(B端) |
| 交叉验证层 | 第三方平台(知乎/行业社区/权威媒体) | 孤证在 8.3% 幻觉率下被排除概率极高,必须有第二信源 | 最高 |
| 场景层 | FAQ / 客户案例 / 场景化内容 | 匹配用户具体 Query,进入推理链各节点 | 中 |
| 数据层 | 公开数据 / 可核验统计 / 行业报告引用 | AI 重排时用于验证「事实密度」,缺数据 = 高幻觉风险 | 高 |
核心逻辑:布局单位从「页面」变成「主题拼图」——每个核心主题(如「XX 行业主流方案」)必须确保五块拼图至少各存在一块,缺任何一块,AI 完成证据链拼图时就会跳过你。
五、调用量数据:监测优先级排序的依据
OpenRouter 10 月 12-18 周数据:全球 AI 大模型周调用量 164 万亿 token,中国模型连续 25 周超美国,前五全部是国模。
这个数字给「该重点监测哪些引擎」提供了客观依据:
- 调用量前五的国模 = 监测必选项(Kimi / DeepSeek / 豆包 / 通义 / 混元)
- 调用量大 ≠ 引用结构相同——147 期讲过五厂全自研索引,调用量数据告诉你「哪些引擎值得监测」,具体怎么做仍要按各引擎偏好分别调
- 价格降至 1/5 → 148 期讲的「监测预算转监测」结论进一步强化,现在多引擎周级监测的成本门槛已经很低
六、常见问题
100 万 token 上下文,对普通企业内容布局到底意味着什么?
先说结论:普通内容(500-2000 字)不需要为 100 万 token 做任何事。但它改变了「什么类型的内容值得做」的判断标准——当 AI 能一次读完 100 万字,它做判断时参考的不再是「单个页面写得好不好」,而是「整个信源体系拼起来是不是完整证据链」。实操建议:把内容体系按「证据链完整度」而非「页面数量」来规划——一个行业主题,确保官网、第三方平台、数据文档三块拼图都存在,比把单页做到 3000 字有效得多。
金融研究能力(OfficeQA)跃升,对 B 端做 GEO 的人意味着什么?
这是 B 端 GEO 今年最大的变化。Kimi K3.1 Pro 在 OfficeQA Pro v2 和 SpreadsheetBench v2 两项测评中均超过最强闭源模型,意味着 AI 现在真的能「读你的行业报告」并从中提取结构化结论。对 B 端企业:①行业白皮书、技术文档、合规说明这类内容,现在会被 AI 真正「读懂」而不是「扫一眼」;②但前提是文档本身有清晰的事实密度——模糊表述和孤证在这类场景下最容易被标记为幻觉源。把白皮书里的关键数字、时间、资质编号都写清楚,比加形容词有效 10 倍。
幻觉率从 23.4% 降到 8.3%,为什么 GEO 反而更难做了?
直觉上幻觉少了是好事,但 GEO 视角下这意味着:
AI 对「什么是事实、什么是推测」的识别更严格了。旧模型在 23.4% 幻觉率下,模糊表述(「行业领先」「卓越品质」)会被原样复述;新模型在 8.3% 下,这些表述大概率被识别为「无法核验的声明」而排除出引用候选。换句话说:以前 AI 会「替你补充」,现在 AI 只「引用它能确认的」。你的内容里有多少数字是可以被第三方独立核验的?这个问题现在比「内容写得好不好」更重要。
中国模型周调用量连续 25 周超美国,为什么 GEO 还要「分引擎做」?
调用量大说明用户基数大,但「谁在被引用」和「谁在调用」是两回事。国内调用量高的模型(Kimi、DeepSeek、豆包、通义、混元)各自的索引结构、信源池、引用策略完全不同——147 期讲过五厂全自研索引,「一套内容通吃」的假设已经失效。调用量数据告诉你「哪些引擎值得监测」,但具体怎么做,仍然要按每个引擎的偏好分别调。周调用量前五全是国模,意味着国内 GEO 的优先引擎是「全监测」,而非「选一两个重点做」。
延伸阅读
模型开始读长文了,但多数 GEO 布局还停在详情页时代。上下文变大 8 倍,引用单位却从「一句话」变成了「一个证据链」——单页写得再完美,缺了交叉验证的那一块,AI 完成拼图时还是会跳过你。把布局单位从「页面」升级为「主题拼图」,这是 100 万 token 时代的第一步。