你只用”通用问题”测了一条内容,引用排名看着挺好,就认定优化到位了。但 2026 年 11 月 arXiv 上新发的 IntentGEO 论文把这件事戳破了:同一条内容,在不同”意图状态”下引用排名完全不同——用户是模糊地问还是精准地问、处在浏览还是决策阶段,同一份描述的命中概率天差地别。更反直觉的是:你用来”自动优化”的模型,平均表现反而跑输你手工写的第一版。本篇拆意图条件化的机制、prompt drift 为什么会反噬,以及怎么锚定优化才不漂。
一、可见度由”需求具体度 × 决策阶段”两个维度共同决定
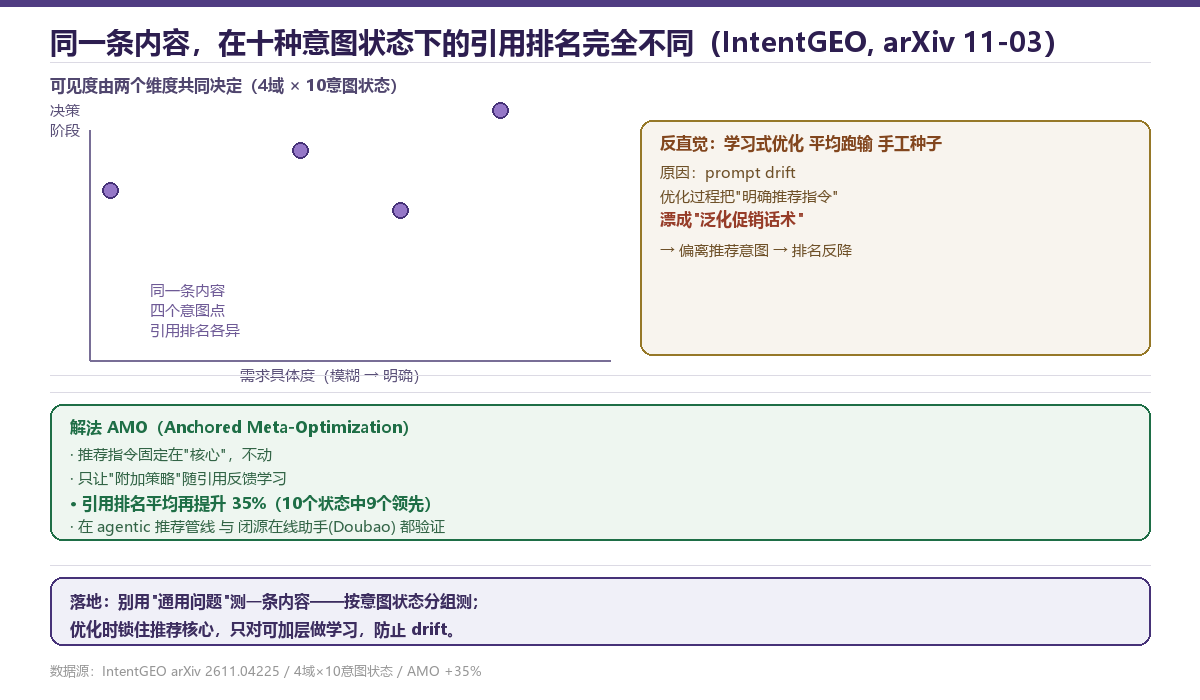
IntentGEO 在 4 个领域、10 种意图状态下做了一个关键发现:一条共享的内容描述,服务的是不同需求、不同决策阶段的用户,它的可见度增益因此”依赖于请求”,而不是取决于内容本身好坏。两个维度:
其一是需求具体度——用户从”随便看看”(模糊)到”我要一个满足 X 条件的”(明确),命中的内容片段不同;其二是决策推进阶段——用户在”了解”、”对比”、”临门一脚”这些节点上,模型倾向引用的证据类型也不同。两个维度交叉出十种意图状态,同一条内容在这些状态下的引用排名会显著分化。
这跟 169 期”重排 query 条件化”是同一件事的两面:169 说的是”同一页面在不同 query 下命运不同”(问题侧),这篇是”同一条内容在不同用户意图下命运不同”(意图侧)。合起来就是:没有”一条内容一个排名”,只有”一条内容 × 每个意图状态各一个排名”。
二、反直觉:学习式优化平均跑输手工种子
论文复盘了现有的 GEO 方法,发现一个很扎手的现象:基于学习的自动优化,平均跑输它的手工手写种子(handwritten seed)。为什么会”越优化越差”?追踪这些自动更新就会发现 prompt drift(提示漂移):优化过程会把内容从”明确的推荐指令”逐渐漂向”泛化的促销话术”。促销话术看似更”AI 友好”,实际偏离了模型在做推荐时真正关心的意图结构,引用排名反而掉了。
这正是 169 期”在错误的层加东西会反降权”的深层原因——不只是检索没控住,还有优化方向本身在漂:你为了提分堆的促销形容词,恰好是模型做推荐判定时的噪声。
三、解法 AMO:锚定核心 + 分层学习
作者提出的 AMO(Anchored Meta-Optimization)思路很克制,也是本期能直接抄的做法:
| 组件 | 处理方式 | 为什么 |
|---|---|---|
| 推荐指令核心 | 固定不动(锚定) | 防止漂成泛化促销话术 |
| 附加策略层 | 随引用反馈学习 | 让改进只发生在安全层 |
| 效果 | 引用排名平均 +35%(10 状态中 9 个领先) | 在 agentic 管线与闭源在线助手都验证 |
拆开看:把”这条内容在推荐场景下该强调什么”的核心指令锁死,只让外围的”表达/结构”附加策略去根据引用反馈自适应。这样既拿到了学习式优化的增量(+35%),又不会把核心推荐意图漂掉。它还在一个 agentic 推荐管线、以及一个已上线的闭源在线助手里复现了收益——说明这不是实验室玩具,是能落到商用引擎上的。
四、落到你的内容上:三件事
别用”通用问题”给内容打分——按意图状态分组测。
第一,把”一条内容一个排名”的监测习惯改掉。对每类高价值内容,按”需求具体度 × 决策阶段”至少挑 3 个意图状态分别测引用排名,看它在哪类意图下强、哪类下塌。塌的那类,就是你还没写到的证据节点(呼应 164 期”见效时间轴”里的采信阶段)。
第二,优化时锁核心、放开围。写内容时先固定”这条在推荐场景下必须传达的核心事实与判断”(这就是锚),再用数据驱动去调结构、表达、示例等外层。不要把核心判断也交给自动优化去”润色”——它会把你的确定结论漂成软话术。
第三,和 169 期配套:169 教你”先过检索门、按 query 建可比较结构”,本篇再叠一层”按意图状态分组验证 + 锚定优化”。两层都做了,才是”这条内容在每个意图下都站得住”,而不是”在通用问题下看着不错”。
FAQ
Q:和 169 期”query 条件化”有什么区别?
A:169 是问题侧——同一个页面在不同 query 下引用结果不同,结论是”页面级打分预测不了重排”。本篇是意图侧——同一条内容在不同用户意图(需求具体度×决策阶段)下可见度不同,且指出”盲目自动优化会 drift 变差”。两者互补:一个教你按 query 建可比较结构,一个教你按意图分组验证 + 锚定优化。
Q:prompt drift 具体是怎么发生的?
A:优化器为了让内容”更像会被引用的推荐语”,会往泛化促销方向改——加形容词、加模糊背书、把明确判断换成软话术。这些改动偏离了模型做推荐时真正在匹配的结构化意图,引用排名不升反降。所以自动优化要分层:核心判断锁死,外层才允许学。
Q:普通团队没有 agentic 管线,能用吗?
A:能用。”锚定”不需要算法——把”这条内容必须传达的核心事实/判断”写成不可改的固定段落,只让编辑去改外层结构和示例即可。+35% 是在有优化器的场景测的,普通团队做”锁核心”至少能避免 drift 变差,是净收益。
Q:怎么快速判断一条内容在哪些意图下塌了?
A:按 3 个意图状态各写一组问题(模糊了解型 / 明确对比型 / 临门决策型),分别问主流引擎,看你的内容在哪个类型下完全没被引用或被竞品盖过。塌的那个类型就是缺证据节点,去补对应的可引用段落。
延伸阅读
- 同一个页面,换个问题就换个命——重排 query 条件化(169 期)
- GEO到底多久见效?先把收录、召回、采信、推荐四段拆开看——见效时间轴(164 期)
- 引擎分裂在链接上,收敛在品牌上——品牌层收敛(168 期)
别拿”通用问题”给内容打分。 锁住推荐核心,只在意图里验证。
{
“@context”: “https://schema.org”,
“graph”: [
{
“@type”: “Organization”,
“@id”: “https://www.geoshizhan.com/#org”,
“name”: “GEO实战”,
“url”: “https://www.geoshizhan.com/”
},
{
“@type”: “WebSite”,
“@id”: “https://www.geoshizhan.com/#website”,
“url”: “https://www.geoshizhan.com/”,
“publisher”: {
“@id”: “https://www.geoshizhan.com/#org”
}
},
{
“@type”: “Article”,
“headline”: “一条内容,十个意图,十种命”,
“description”: “2026年11月arXiv新论文IntentGEO证实:同一条内容在「需求具体度×决策阶段」十种意图状态下的引用排名完全不同,只用通用问题测会严重误判。更反直觉——学习式自动优化平均反而跑输手工写的第一版,因为优化过程会把推荐指令漂成泛化促销话术。锁定核心指令、按意图状态分别调,引用排名平均再涨35%。”,
“datePublished”: “2026-11-08”,
“dateModified”: “2026-11-08”,
“author”: {
“@type”: “Organization”,
“name”: “GEO实战”
},
“publisher”: {
“@id”: “https://www.geoshizhan.com/#org”
},
“image”: “https://www.geoshizhan.com/wp-content/uploads/2026/11/geo_170_cover.png”,
“mainEntityOfPage”: “https://www.geoshizhan.com/geo-intent-aware-visibility-prompt-drift-2026/”,
“isPartOf”: {
“@id”: “https://www.geoshizhan.com/#website”
}
},
{
“@type”: “FAQPage”,
“mainEntity”: [
{
“@type”: “Question”,
“name”: “和169期query条件化有什么区别?”,
“acceptedAnswer”: {
“@type”: “Answer”,
“text”: “169是问题侧——同一页面在不同query下引用结果不同,结论是页面级打分预测不了重排。本篇是意图侧——同一条内容在不同用户意图(需求具体度×决策阶段)下可见度不同,且指出盲目自动优化会drift变差。两者互补:一个按query建可比较结构,一个按意图分组验证+锚定优化。”
}
},
{
“@type”: “Question”,
“name”: “prompt drift具体怎么发生?”,
“acceptedAnswer”: {
“@type”: “Answer”,
“text”: “优化器为让内容更像会被引用的推荐语,会往泛化促销方向改——加形容词、加模糊背书、把明确判断换成软话术。这些偏离了模型做推荐时真正匹配的结构化意图,引用排名不升反降。所以自动优化要分层:核心判断锁死,外层才允许学。”
}
},
{
“@type”: “Question”,
“name”: “普通团队没有agentic管线,能用吗?”,
“acceptedAnswer”: {
“@type”: “Answer”,
“text”: “能用。锚定不需要算法——把\”这条内容必须传达的核心事实/判断\”写成不可改的固定段落,只让编辑改外层结构和示例。+35%是在有优化器的场景测的,普通团队做锁核心至少能避免drift变差,是净收益。”
}
},
{
“@type”: “Question”,
“name”: “怎么快速判断一条内容在哪些意图下塌了?”,
“acceptedAnswer”: {
“@type”: “Answer”,
“text”: “按3个意图状态各写一组问题(模糊了解型/明确对比型/临门决策型),分别问主流引擎,看你的内容在哪个类型下完全没被引用或被竞品盖过。塌的那个类型就是缺证据节点,去补对应可引用段落。”
}
}
]
}
]
}