你花了三个月把首页的”AI 友好度”刷到满分:加了数据、加了引用、加了结构化。结果投给模型,引用率不升反降。问题不在页面——在重排层。2026 年 9 月那次 Princeton GEO 战术的复现把这件事钉死了:重排阶段是”按 query 条件化”的,你页面做得再好,预测不了它在这个问题下该不该赢。本篇讲重排层的 query 条件化机制、为什么”加数据加引用”会反降权,以及正确的”可比较性结构”该怎么搭。
一、页面级打分预测不了重排,只有 0.114 的相关性
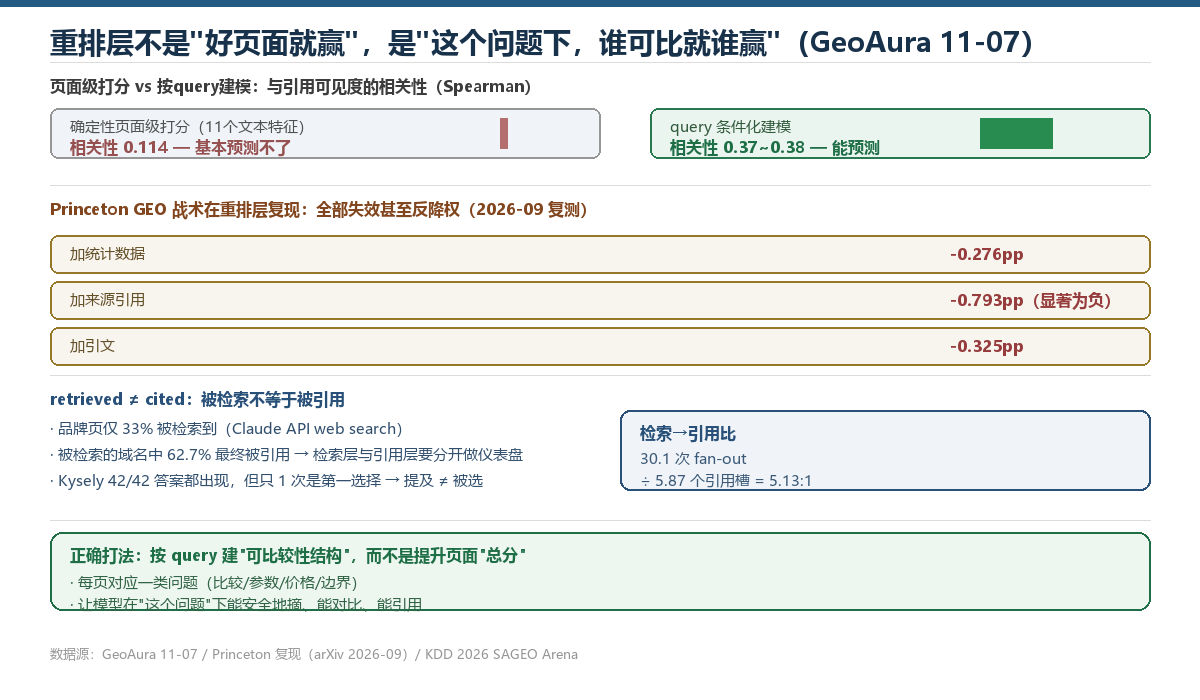
GeoAura 在 11-07 那篇 RAG 架构拆解里给了一组很扎眼的相关性数字:用 11 个文本特征(字数、标题、首段等)构造成一个确定性的”页面质量分”,去预测这个页面在各引擎里的引用可见度,pooled within-query 的 Spearman 相关性只有 0.114;而换成按 query 建模,相关性直接跳到 0.37~0.38,是页面级打分的三倍多。
这两个数字合起来的意思很清楚:引用结果主要由”这个问题”决定,不是由”这个页面有多好”决定。同一个页面,在”什么是 X”这类解释型问题下可能没机会,在”X 和 Y 选哪个”的比较型问题下却可能是首选——模型在重排层比较的是”谁在这个问题下可比、可摘、可引用”,不是”谁的页面总分高”。
二、为什么”加数据加引用”在重排层会反降权
Princeton 2024 年那篇开山文献给出”加统计数据 / 加引文 / 加来源引用能提升 30%~40% 可见度”的结论。但 2026-09 的复测(Bajemon & Rochet,配对、体量对照)三项全崩:
| 战术 | 重排层效应(95% CI) | 解读 |
|---|---|---|
| 加引文 | -0.325 pp | 不显著 |
| 加统计数据 | -0.276 pp | 不显著 |
| 加来源引用 | -0.793 pp(唯一排除 0) | 显著为负——加了反而更差 |
原因不是”数据没用”,而是复现时没有控制住检索层:这些编辑是在检索召回结果之上做的,而检索召回本身才是决定生死的第一道门(#25047「先过检索门再谈内容优化」讲的同一件事的重排版)。在召回没变的前提下,往页面里塞更多引用和数据,只是让模型的重排更难聚焦于”当前这个问题该摘哪一段”,反而被拉低。
这解释了为什么很多团队”优化完却更差”——你在重排层做的编辑,落在了它根本不管的那一层上。
三、retrieved ≠ cited:检索层和引用层要分开看
同一篇 RAG 架构拆解里还有两组把”检索”和”引用”彻底拆开的实测:
第一组(Claude API web search):品牌页只有 33% 被检索到,但被检索到的域名里 62.7% 最终被引用。这说明”进没进检索池”和”进了池有没有被引”是两个独立事件,要分开建仪表盘——前者靠渠道布局(166 期”看引擎吃什么”定渠道),后者靠”可引用性”(本期的可比较结构)。
第二组(Frontier AI 可见度追踪):某个品牌 42 次答案全部被提及,但只 1 次是第一选择。”被提及”和”被选”是两回事——模型可以在一段里带一句你的名字,但不把它放进”推荐”位置。这也呼应了 168 期说的”品牌层收敛、URL 层分裂”:品牌名在答案里出现≠它的页面被引用。
四、正确打法:按 query 建”可比较性结构”
别再问”这页够不够好”,要问”这个问题下,它可不可比”。
重排层 query 条件化的直接推论:每个页面都应该对着一类明确的问题,让模型”在这个问题下”能安全地摘、能对比、能引用。具体三条:
其一,页面 ↔ 问题一一绑定。比较页回答”选哪个”、参数页回答”能得什么”、价格页回答”多少钱”、边界页回答”什么时候不行”。一个只答主问题的页面,在 5.13:1 的 fan-out 竞争里(30.1 次子检索 vs 5.87 个引用槽)只占得到”为什么”那 1/5,另 4/5 的槽位被更完整回答子问题的页面拿走。
其二,把”可引用性”做进段落,而不是页面总分。重排模型在每个 query 下看的是”这段能不能被摘走当答案”——首句直接给结论、段内自包含、数字带时间戳。这是 165 期信息增益阈值在重排层的落地:不是堆量,是”每个子问题一段干净的可摘句”。
其三,不要在检索层没解决前动重排层。先把”能进检索池”做扎实(渠道 + 覆盖 3~5 个可检索页面),再谈页面内的可比较结构。顺序反了,就像这次复现——检索没控住,重排编辑全白做甚至负分。
FAQ
Q:那”提升页面质量”是不是完全没用?
A:有用,但作用在检索层,不在重排层。让页面”够好到能进检索池”是检索层的事(#25047)。进池之后,决定引用的是”在这个 query 下是否可比、可摘”,这一层页面级打分相关性只有 0.114——所以别再指望”刷页面总分”能在重排层线性加分。
Q:为什么加来源引用反而被拉低 0.793pp?
A:那是这次复现没控制检索变量导致的——在被检索召回集不变的前提下往段落里塞引用,让模型更难聚焦”该摘哪一段”。不是”引用永远有害”,是”在错误的层加引用有害”。做引用要绑在”已经进检索池、且对着明确 query”的页面上(呼应 166 期渠道 + 167 期事实一致)。
Q:retrieved 33% 和 cited 62.7% 这两个数怎么用来排优先级?
A:如果某类问题你的 retrieved 很低(<50%),优先补渠道让页面进池(这是检索层,先做);如果 retrieved 已经很高但 cited 低,优先做可比较结构(这是重排层)。两个仪表盘分开看,别混成一个"可见度"数字。
Q:和 165 期”信息增益阈值”、168 期”品牌收敛”什么关系?
A:165 讲”一段话要带来多少新信息才值得被摘”(密度层),168 讲”品牌名在跨引擎答案里的一致提及度”(共识层),本期讲”重排层按 query 决定谁可比”(条件化层)。三层叠加:密度够 → 品牌共识 → 在这个问题下可比,三者齐了才稳定被引。
延伸阅读
- 你和竞品写的一样,AI 只会引用一个——同质降权与 MMR 多样性(165 期)
- AI 引用你的页面,先过检索门,再谈内容优化——检索层(25047)
- 引擎分裂在链接上,收敛在品牌上——品牌层收敛(168 期)
别刷页面总分了。 把它做成”这个问题下,最可比的那一段”。
{
“@context”: “https://schema.org”,
“graph”: [
{
“@type”: “Organization”,
“@id”: “https://www.geoshizhan.com/#org”,
“name”: “GEO实战”,
“url”: “https://www.geoshizhan.com/”
},
{
“@type”: “WebSite”,
“@id”: “https://www.geoshizhan.com/#website”,
“url”: “https://www.geoshizhan.com/”,
“publisher”: {
“@id”: “https://www.geoshizhan.com/#org”
}
},
{
“@type”: “Article”,
“headline”: “同一个页面,换个问题就换个命”,
“description”: “2026年重排层的实测数据推翻了一个默认假设:页面级质量打分预测不了引用结果。确定性文本特征与引用可见度的相关性只有0.114,而按query建模能到0.37——同一页面在不同问题下命运完全不同。加数据加引用在重排层非但没加分,反而被拉低0.79个百分点。所以别再问\”这页够不够好\”,要问\”这个问题下,它可不可比\”。”,
“datePublished”: “2026-11-07”,
“dateModified”: “2026-11-07”,
“author”: {
“@type”: “Organization”,
“name”: “GEO实战”
},
“publisher”: {
“@id”: “https://www.geoshizhan.com/#org”
},
“image”: “https://www.geoshizhan.com/wp-content/uploads/2026/11/geo_169_cover.png”,
“mainEntityOfPage”: “https://www.geoshizhan.com/geo-rerank-query-conditioned-page-scoring-fails-2026/”,
“isPartOf”: {
“@id”: “https://www.geoshizhan.com/#website”
}
},
{
“@type”: “FAQPage”,
“mainEntity”: [
{
“@type”: “Question”,
“name”: “那\”提升页面质量\”是不是完全没用?”,
“acceptedAnswer”: {
“@type”: “Answer”,
“text”: “有用,但作用在检索层,不在重排层。让页面\”够好到能进检索池\”是检索层的事(25047)。进池之后决定引用的是\”在这个query下是否可比可摘\”,页面级打分相关性只有0.114——别指望刷页面总分在重排层线性加分。”
}
},
{
“@type”: “Question”,
“name”: “为什么加来源引用反而被拉低0.793pp?”,
“acceptedAnswer”: {
“@type”: “Answer”,
“text”: “那是这次复现没控制检索变量——检索召回集不变时往段落塞引用,让模型更难聚焦\”该摘哪段\”。不是引用永远有害,是在错误的层加引用有害。做引用要绑在\”已进检索池且对着明确query\”的页面上(166期渠道+167期事实一致)。”
}
},
{
“@type”: “Question”,
“name”: “retrieved 33%和cited 62.7%怎么用来排优先级?”,
“acceptedAnswer”: {
“@type”: “Answer”,
“text”: “若某类问题retrieved很低(<50%),优先补渠道让页面进池(检索层先做);若retrieved已高但cited低,优先做可比较结构(重排层)。两个仪表盘分开看,别混成一个\"可见度\"数字。"
}
},
{
"@type": "Question",
"name": "和165期信息增益阈值、168期品牌收敛什么关系?",
"acceptedAnswer": {
"@type": "Answer",
"text": "165讲\"一段话要带来多少新信息才值得被摘\"(密度层),168讲\"品牌名在跨引擎答案里的一致提及度\"(共识层),本期讲\"重排层按query决定谁可比\"(条件化层)。密度够→品牌共识→在这个问题下可比,三者齐了才稳定被引。"
}
}
]
}
]
}