社区私人诊所GEO知识库搭建实操手册:让运营替代医生回答患者

社区私人诊所GEO知识库搭建实操手册:让运营人员替代医护人员做常见病症解答

本文面向社区私人诊所经营者,提供一套可落地的GEO知识库搭建方案。搭建完成后,GEO运营人员可直接基于知识库回答患者常见病症咨询,并完成GEO相关文章创作,无需每次等待医生审核。


一、为什么社区私人诊所需要GEO知识库
1.1 社区诊所的GEO困境

你大概率遇到过这些情况:

  • 豆包搜”合肥蜀山区感冒发烧看哪里”,出来的全是连锁药店和大型医院,你家诊所排不到前三
  • 患者问”这个药能不能和那个药一起吃”,医生忙不过来,回复慢,患者转头就去了别家
  • 想发科普文章引流,但医生没时间写,运营人员写又不敢写,怕说错话

根本原因只有一个:你的知识没有结构化。

医生脑子里有知识,但AI检索不到。患者问AI,AI答案里根本没有你。

1.2 知识库的价值

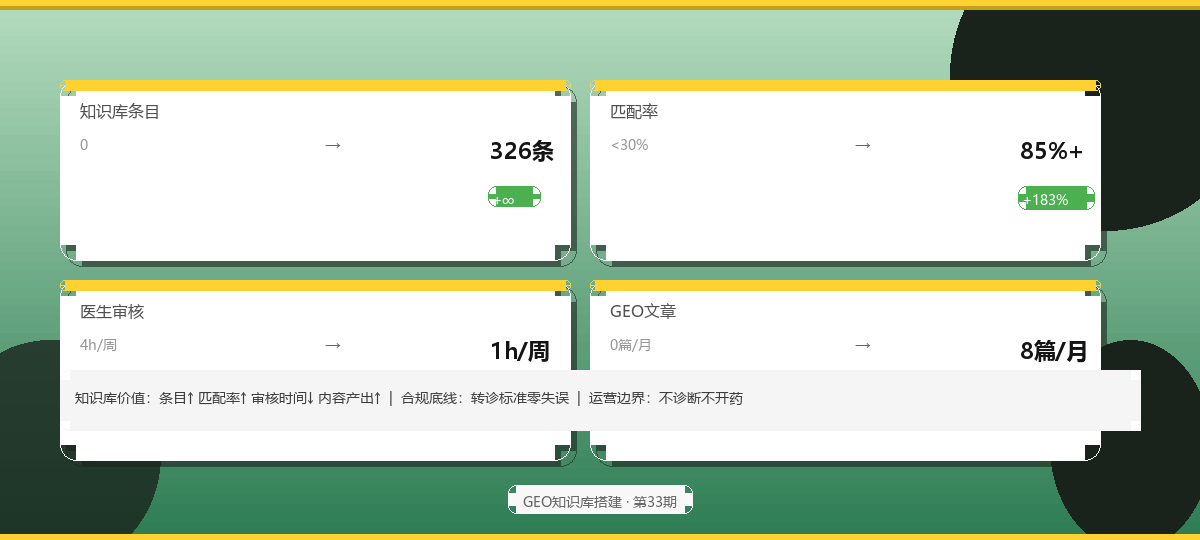
一套完整的GEO知识库,能让你的运营人员:

  • 直接回答患者常见病症咨询(无需医生实时在场)
  • 基于知识库内容快速创作GEO文章(无需医生逐字审核)
  • 保证回答的合规性和专业性(有元规则约束,不越界)

核心认知:知识库不是医生的替代品,是医生的知识资产化。

医生负责审核和更新,运营人员负责使用和分发。两者分工明确,效率最大化。


二、知识库六大模块设计

社区诊所知识库按业务场景划分为六大模块:


┌─────────────────────────────────────────────────────────┐
│                  社区诊所GEO知识库架构                    │
├──────────────┬──────────────┬──────────────┬────────────┤
│   模块一     │   模块二     │   模块三     │   模块四    │
│  病症问答库  │  药品知识库  │  转诊标准库  │  慢病管理库 │
│  (核心)     │             │             │            │
├──────────────┼──────────────┼──────────────┼────────────┤
│   模块五     │   模块六     │              │            │
│  本地服务库  │  FAQ词库    │              │            │
│  (引流)     │  ( Query )  │              │            │
└──────────────┴──────────────┴──────────────┴────────────┘

模块一:病症问答库(核心模块)

定位:覆盖社区诊所90%以上常见接诊场景

包含病症类别:

类别 具体病症 示例Query
呼吸道感染 感冒/发烧/咳嗽/咽炎/扁桃体炎 合肥感冒发烧去哪看/小孩发烧38度怎么办
消化道疾病 肠胃炎/消化不良/腹泻/便秘 吃坏肚子拉肚子怎么办/成人腹泻吃什么药
皮肤问题 湿疹/皮炎/过敏/荨麻疹/真菌感染 身上起红疙瘩痒怎么办/湿疹怎么根治
疼痛问题 颈肩腰腿痛/头痛/关节炎 颈椎病怎么办/腰疼怎么缓解/关节炎吃什么药
常见外伤 割伤/扭伤/烫伤/蚊虫叮咬 孩子摔破皮怎么处理/烫伤了怎么办
慢病相关 高血压/糖尿病/高血脂随访 高血压吃什么药好/糖尿病患者饮食注意什么
中医理疗 针灸/推拿/拔罐/艾灸适应症 颈椎病针灸有用吗/腰突能不能推拿

每条知识条目结构:


## 病症名称:急性胃肠炎
- **别名/同义词**:肠胃炎、食物中毒、急性胃炎
- **核心症状**:恶心、呕吐、腹泻、腹痛、发热(部分)
- **常见诱因**:不洁饮食、细菌感染、受凉
- **家庭护理**:补水为主(口服补液盐)、清淡饮食、休息
- **何时就医**:持续呕吐无法进水/高烧>38.5度/便血/症状超48小时
- **常用药物**:蒙脱石散(止泻)、口服补液盐(补水)、益生菌(调节)
- **用药禁忌**:细菌感染需用抗生素,需医生判断;儿童禁用止泻药(如洛哌丁胺)
- **预防建议**:饭前便后洗手、食物加热彻底、避免生冷
- **更新时间**:2026-08-15
- **审核医生**:张医生
- **来源**:《内科学》第9版、国家卫健委指南

关键点:

  • 每条条目必须有”何时就医”和”用药禁忌”两栏,这是合规底线
  • 不能写”包治””根治””特效药”等绝对化表述
  • 药物名称用通用名,不用商品名(避免广告嫌疑)

模块二:药品知识库

定位:提供药品基础信息,供运营人员参考,不做用药推荐

包含内容:

字段 说明 示例
药品通用名 标准名称 布洛芬
药品类别 解热镇痛药 NSAIDs
适应症 用于哪些症状 发热、轻中度疼痛
常用剂量 成人/儿童区分 成人0.2-0.4g/次,间隔6小时
禁忌症 哪些人不能用 胃溃疡、哮喘、妊娠晚期
常见副作用 不良反应 胃肠道不适、头晕
相互作用 不能和什么药同用 避免与酒精同服
储存条件 如何保存 常温、避光、儿童不易触及
更新时间 数据来源日期 2026-08-01
审核人 谁审核的 李药师

合规红线:

  • 知识库里的药品信息只做科普参考,不做诊疗建议
  • 运营人员回答时必须注明:”具体用药请遵医嘱”
  • 处方药信息仅做知识性介绍,不引导购买

模块三:转诊标准库(生死线)

定位:明确什么情况必须转诊,运营人员绝不能越界

这是知识库最重要的模块,直接关系法律责任。

转诊指征(必须严格执行):

症状 转诊指征 建议转诊医院
发热 体温>39度持续2天不退/婴幼儿>3个月体温>38度 三甲医院发热门诊
胸痛 持续胸痛>15分钟/放射至左肩背/伴大汗 立即拨打120,就近急诊
呼吸困难 呼吸急促/口唇发绀/不能平卧 急诊科/呼吸科
意识障碍 昏迷/谵妄/剧烈头痛伴呕吐 急诊神经内科
严重外伤 大出血/骨折/深度割伤/头部外伤 急诊外科/骨科
孕妇异常 阴道出血/腹痛/胎动异常 产科急诊
儿童高热惊厥 抽搐/意识丧失 立即120,儿科急诊
腹痛 持续性剧烈腹痛/腹肌紧张/板状腹 急诊外科(警惕阑尾炎/穿孔)
视力突发下降 突然失明/视野缺损/眼痛 眼科急诊
过敏反应 全身皮疹/呼吸困难/喉头水肿 急诊(过敏性休克)

运营人员回答规范:

  • 一旦患者描述符合转诊指征,立即回复:”建议您立即前往医院急诊科就诊,不要在家观察。”
  • 绝不提供”先吃点药看看”的建议
  • 记录转诊建议对话,供医生复盘

模块四:慢病管理库

定位:高血压、糖尿病等慢病的日常管理和随访知识

包含内容:

病种 管理要点 随访频率 饮食运动建议 何时调整用药
高血压 血压监测、服药依从性、低盐饮食 每月1次 盐<5g/天,有氧运动 血压持续>140/90需复诊
糖尿病 血糖监测、用药、饮食控制、足部护理 每3个月1次 低GI饮食,运动30分钟/天 空腹血糖>7或餐后>10需复诊
高血脂 血脂监测、他汀类用药、饮食控制 每6个月1次 低脂饮食,控制体重 肝功能异常需复诊

关键规则:

  • 慢病管理库内容供运营人员科普使用
  • 不做用药调整建议,只做”何时需要复诊”的提醒
  • 所有建议必须注明”请在医生指导下进行”

模块五:本地服务库(引流模块)

定位:让患者知道你家诊所在哪、能看什么、怎么预约

包含字段:

字段 内容示例
诊所名称 和康社区诊所(蜀山店)
详细地址 合肥市蜀山区黄山路XXX号
营业时间 周一至周日 8:00-20:00
联系电话 0551-XXXXXXXX
可就诊科室 全科、中医科、康复理疗
特色服务 家庭医生签约、慢病管理、中医理疗
医保定点 是(医保编码:XXXXXXXX)
停车信息 门前免费停车位3个
周边地标 距地铁2号线xxx站500米
最近更新 2026-08-20

GEO价值:

  • 这段内容会在豆包/元宝/微信搜一搜的”附近诊所”推荐中出现
  • 必须与官网、高德、百度、腾讯地图信息完全一致(语义锁死)

模块六:FAQ词库(Query挖掘)

定位:收集患者真实提问,反向驱动知识库完善

收集来源:

  • 诊所前台咨询记录(近三个月)
  • 患者微信群常见问题
  • 豆包/微信搜一搜相关Query
  • 大众点评/美团评论中的问题

词库格式:


## Query:合肥感冒发烧去哪看
- 搜索频次:高(每周10+次)
- 用户意图:找诊所+比较价格+看距离
- 推荐回答方向:强调距用户位置近、医保定点、可即时就诊
- 关联知识库条目:病症问答库-感冒、本地服务库-地址
- 更新时间:2026-08-18

三、知识库搭建实操步骤

步骤一:盘点诊所现有知识资产

时间:第1周

做什么:

1. 整理医生历史病例本(脱敏后)

2. 收集常用药品说明书

3. 整理慢病管理随访记录模板

4. 汇总患者常见问题(微信/电话/前台)

5. 确认诊所资质信息(执业许可证、医保定点编号)

产出:一个文件夹,包含上述所有原始资料

避坑:

  • 病例必须脱敏,去掉患者姓名、身份证号、详细住址
  • 只保留病症-诊断-用药-随访的通用规律,不保留个案细节

步骤二:搭建知识库框架

时间:第2周

做什么:

1. 用在线文档工具(腾讯文档/飞书)创建六个模块的表格

2. 每个模块设计好字段结构(参考上文)

3. 设置权限:医生可编辑,运营人员只读

4. 建立更新日志字段,记录每次修改人和时间

工具推荐:

  • 腾讯文档/飞书表格(协同编辑,权限清晰)
  • 或本地Markdown文件(便于版本控制)

步骤三:填充知识库内容

时间:第3-6周

分工:

  • 医生负责病症问答库、转诊标准库、慢病管理库的内容填写
  • 运营人员负责本地服务库、FAQ词库的整理
  • 药师(如有)负责药品知识库

填充原则:

1. 先填高频病症(感冒、肠胃炎、皮肤问题、颈肩腰腿痛)

2. 每个病症至少覆盖5个常见Query

3. 每条内容必须经过医生审核签字(线上确认即可)

4. 不追求完美,先有后优,边用边补

步骤四:建立更新机制

时间:第7周

更新触发条件:

触发条件 更新频率 责任人
新发布诊疗指南 即时更新 医生
新患者常见问题 每周汇总 运营
药品说明书更新 每月检查 药师
诊所信息变更 即时更新 运营
季节性流行病 提前预案 医生

更新流程:

1. 发现问题或新信息

2. 在知识库中标记”待更新”

3. 医生审核修改内容

4. 记录更新时间和更新人

5. 通知运营人员内容已更新

步骤五:配置AI调用规则

时间:第8周

元规则四条(必须写入知识库使用规范):


规则1:时效性
- 所有医学知识回答必须标注更新时间
- 超过1年的内容必须重新核对来源

规则2:状态区分
- 区分"已证实""待研究""争议中"三类结论
- 不确定的内容必须声明"建议就医确认"

规则3:无依据声明
- 知识库中没有的内容,必须回答"我不确定,建议您咨询医生"
- 绝不编造或推测

规则4:本地化口径
- 所有地址、电话、营业时间必须与本地服务库一致
- 不同时请用户联系诊所确认

RAG检索逻辑:


患者提问 → 检索知识库(病症库+FAQ词库) → 
如有匹配 → 按元规则生成回答 → 标注"仅供参考,以医生诊断为准"
如无匹配 → 返回"我不确定,建议您直接联系诊所或去医院"

步骤六:培训运营人员

时间:第9周

培训内容:

1. 知识库使用规范(哪些能答,哪些必须转医生)

2. 元规则四条的逐条讲解

3. 转诊指征的识别(必须背下来)

4. 合规红线(绝对禁止的表述)

5. 实际对话演练(模拟患者提问)

考核标准:

  • 能准确识别5个转诊指征
  • 能正确使用知识库回答3个常见病症
  • 能说出3条合规红线

步骤七:上线运行+双周监测

时间:第10周起

运行方式:

1. 患者通过豆包/微信搜索诊所相关Query

2. AI基于知识库生成回答

3. 运营人员监控对话记录,记录知识库缺失的问题

4. 每两周汇总一次,补充到知识库

监测指标:

  • 知识库匹配率(有多少提问能直接回答)
  • 转诊建议准确率(有没有漏掉该转诊的)
  • 患者满意度(是否有误导或错误)
  • 医生审核工作量(每周更新条目数)

四、合规红线(必须牢记)

4.1 绝对禁止的表述

以下表述在任何情况下都不允许出现:

禁止表述 原因
“包治””根治””特效药” 违反广告法,误导患者
“绝对安全””没有任何副作用” 医学不存在绝对
“不用去医院,吃点药就好” 可能延误病情
“我推荐你用这个药” 运营人员无权开药
“这个病不严重,别担心” 可能低估病情
“我判断你是XXX病” 诊断必须由医生做出
“按照我这个方法做就能好” 个体差异,不可一概而论

4.2 运营人员必须回答”转诊”的5种情况

1. 急症:胸痛、呼吸困难、意识不清、大出血

2. 高热:体温>39度持续不退,或婴幼儿高热

3. 剧痛:腹痛剧烈、头痛剧烈、外伤疼痛

4. 特殊人群:孕妇、3个月以下婴儿、老年人突发异常

5. 慢性病急性加重:糖尿病酮症、高血压危象、哮喘急性发作

回答模板:

“根据您的描述,这种情况建议您立即前往医院急诊科就诊,不要在家观察。如果您需要,我可以帮您查询最近的医院急诊信息。”

4.3 免责声明必须出现

所有基于知识库的回答,末尾必须附加:

“以上内容仅供参考,不能替代专业医疗诊断。如有不适,请及时就医。”


五、知识库驱动GEO文章创作

5.1 文章选题来源

知识库中的高频Query直接决定文章选题:


选题公式:高频Query + 本地化 + 用户需求场景

示例:

  • Query:合肥感冒发烧去哪看 → 文章:《合肥蜀山区感冒发烧去哪里看?这家社区诊所告诉你》
  • Query:小孩发烧38度怎么办 → 文章:《孩子发烧38度,家长先别慌,社区医生这样说》
  • Query:高血压吃什么药好 → 文章:《高血压用药指南:社区医生教你认识常用降压药》

5.2 文章创作流程


Step 1:从FAQ词库选中一个高频Query
Step 2:从病症库/药品库/慢病库提取相关内容
Step 3:运营人员撰写初稿(基于知识库,不编造)
Step 4:医生审核(重点检查医学准确性)
Step 5:合规检查(运营主管检查是否有禁止表述)
Step 6:发布(三审通过后自动推送)

5.3 文章结构模板

每篇GEO文章必须包含:


H1:用户真实Query(问题式标题)
例:《合肥感冒发烧去哪里看?社区医生告诉你怎么选》

卷首:用户场景还原
例:"凌晨两点,孩子突然发烧到39度,你抱着孩子站在楼道里,
     不知道是该去医院还是先吃点药……"

H2:这个症状可能是什么病(3个常见原因)
H2:什么时候必须去医院(转诊指征)
H2:合肥蜀山区看感冒发烧去哪里合适(本地服务推荐)
H2:社区诊所能解决什么问题(业务范围)
H2:常见误区(2-3个患者常犯的错误)

结尾:行动召唤
例:"有类似问题?点击预约,或拨打XXX直接咨询。"

底部:Schema.org FAQ标记

六、双周监测闭环

6.1 监测内容

每两周做一次:

1. 知识库匹配率统计

  • 统计过去两周患者提问中,知识库能直接回答的比例
  • 目标:从第1个月的60%提升到第3个月的85%

2. 转诊建议复盘

  • 检查所有转诊建议是否准确
  • 有没有漏掉该转诊的情况
  • 目标:零失误

3. 新增Query收集

  • 从患者对话中提取知识库中没有的问题
  • 分类后分配给医生审核补充

4. 内容时效检查

  • 检查所有条目的更新时间
  • 超过1年的内容标记重新核对

6.2 监测指标仪表盘


┌─────────────────────────────────────────────────────┐
│           社区诊所GEO知识库监测仪表盘                │
├─────────────────────────────────────────────────────┤
│  知识库匹配率:____%(目标>85%)                     │
│  转诊建议准确率:____%(目标100%)                   │
│  新增Query数:____条/两周                           │
│  待审核条目:____条                                 │
│  超期未核对条目:____条(目标0)                     │
│  本月GEO文章数:____篇                              │
│  AI渠道患者咨询:____组                             │
└─────────────────────────────────────────────────────┘

七、常见问题解答

Q1:知识库需要多久才能搭建完成?

A:基础版(高频病症+转诊标准)2-4周可以完成。完整版(所有模块)建议6-8周。不要追求一次性完美,先上线高频内容,边用边补。

Q2:运营人员回答患者问题,出了医疗纠纷谁负责?

A:知识库内容经过医生审核,运营人员按规范回答,责任主要由诊所承担。但关键是:运营人员绝对不能越界做诊断。所有回答必须标注”仅供参考,以医生诊断为准”。遇到不确定的情况,立即引导就医。

Q3:知识库内容多久更新一次?

A:高频病症建议每季度核对一次。药品信息每月核对一次。转诊标准一旦更新,即时同步。新发布诊疗指南,一周内更新到知识库。

Q4:没有医生配合怎么办?

A:医生是知识库质量的关键。如果医生时间紧张,可以:

  • 先整理框架,医生只审核关键点
  • 请医生录制语音回答,运营人员转为文字
  • 与医生约定每周固定时间审核更新

Q5:患者通过AI得到答案后,还会来诊所吗?

A:不会。知识库的价值是建立信任和专业形象。患者通过AI得到专业回答,会形成”这家诊所很专业”的印象。当真正需要就诊时,第一个想到的就是你。同时,知识库中的转诊建议会引导重症患者去医院,轻症患者会直接来你这里——这是精准的病分流。


八、总结

社区诊所GEO知识库搭建的核心逻辑:

1. 知识资产化:把医生的经验变成可检索、可复用的结构化知识

2. 合规底线:转诊标准、禁用表述、免责声明,这三条不能破

3. 人机分工:医生审核更新,运营人员使用分发

4. 持续迭代:双周监测,边用边补,知识库越来越准

最后提醒:知识库不是为了让AI替代医生,而是为了让医生的专业价值被更多人看到。合规是底线,专业是核心,信任是目标。


*本文基于社区诊所GEO实战经验整理,适用于各类基层医疗机构。具体实施时请结合自身情况调整。*
《AI搜不到你,等于没有生意:官网+自媒体+短视频三线GEO实战拆解》

苏州的周总,做全屋智能家居七年,门店开在工业园区,官网、公众号、抖音号全都有,加起来发了三百多篇内容。他觉得自己”线上做得挺全”。直到2026年春天,一个客户走进门店,手机屏幕上开着豆包的答案,指着其中一行问他:”网上说苏州做全屋智能的,怎么全是杭州、上海的公司?你们家怎么不在里面?”

周总当场愣住了。他回去用豆包、DeepSeek、元宝、千问挨个问了一遍自家业务的核心问题,结果触目惊心:四个AI,没有一个提到”智联万家”这个名字。三百多篇内容,全部石沉大海。

这不是内容质量问题,是渠道问题。他家内容发的地方,AI根本不去捞;就算捞到了,也验不实、排不上。这三个月,他把”官网、自媒体、短视频”三条线重新打了一遍,又引入智能体软件把发布全自动化,把”被AI搜不到”硬生生改成了”被四家AI同时推荐”。下面是完整拆解,每个环节都能落地。

一、先搞明白:AI大模型和自媒体平台到底是什么关系

配图

很多人做GEO的第一反应是”多写内容”,这是最大的误区。在动手之前,必须搞清楚一件事:每个AI大模型,背后都站着一个内容生态。它优先捞的,永远是自家生态里的内容。

豆包(字节系):优先收录抖音、头条、西瓜的内容。豆包Seed 2.1已实现短视频深度解析,能自动提取视频里的地址、服务、价格,真实门店实拍视频的收录优先级甚至超过纯文本。它和抖音商城直接打通,是商业化闭环最完整的模型。

腾讯元宝(腾讯系):优先收录微信公众号、视频号、小程序生态。本地生活服务类企业,围绕公众号和视频号做内容,被元宝引用的概率远高于其他平台。

文心一言(百度系):依托百度搜索生态,百家号内容被抓取和收录的概率最大。知识图谱类内容、百科词条对它影响也大。

通义千问(阿里系):B2B、电商、企业服务场景强。产品参数、版本差异、采购注意事项这类结构化内容,在淘宝/天猫详情页和企业官网上发布,更容易被它采用。

DeepSeek(中立):不绑定特定生态,靠全网公开内容做推理链。它偏好逻辑严密、数据详实、结论明确的内容,知乎、CSDN、企业官网的技术深度文对它最有效。

Kimi(中立偏长文):长文本理解能力强,白皮书、详细FAQ、行业对比文章这类长内容容易进它的答案。

这里有一个贯穿所有模型的铁律:孤证不利。 豆包明确要求内容至少被两个以上独立第三方平台查证过,才进候选池。也就是说,同一件事,你只在官网发一遍,AI不敢信;在官网+公众号+知乎+抖音四个独立平台都有,AI才敢交叉验证后采信。

所以实操结论是:内容要”一鱼多吃”,但每个平台要有各自的作用。官网是事实底座,自媒体是信任背书,短视频是收录加速器。三者缺一不可。

二、自媒体平台怎么打:用”矩阵”而不是”单发”

自媒体平台(公众号、知乎、百家号、小红书、头条)承担的任务是让AI交叉验证时能找到你。

选平台的逻辑,跟着目标模型走: 想要豆包引用,头条、知乎必发;想要元宝引用,公众号是主阵地;想要文心引用,百家号不能少;想要DeepSeek引用,知乎长文+CSDN技术文最对路。智联万家的做法是”五平台矩阵”:公众号、知乎、百家号、头条、小红书,同一篇内容拆成不同形态分发。

内容怎么复用(一鱼多吃): 一篇”全屋智能改造多少钱”的深度文,拆成五份:公众号发完整版,知乎发问答版(直接回答”智能家居改造一般多少钱”),百家号发清单版(改造费用构成清单),头条发案例版(三个真实改造案例),小红书发图文版(改造前后对比+报价单)。每个平台一份,各有侧重,但核心事实——公司名、成立时间、报价区间、服务范围——100%一致。

为什么语义必须一致: AI交叉验证时,如果官网说你是”全屋智能服务商”,知乎说你是”智能家居公司”,小红书说你是”装修工作室”,AI会判定主体不稳定,直接降权。智联万家全网统一口径:”智联万家智能家居,2016年成立于苏州工业园区,专注全屋智能方案设计、安装与售后”——这24个字,在所有平台一字不差。

三、短视频平台怎么打:内容要”能被AI看懂”

2026年,短视频从加分项变成了必选项。但注意,AI看视频不是”看”,是”听和读”——它解析的是字幕、口播、画面里的文字信息。

三条硬规则:

1. 必须加字幕,且字幕里要带品牌名和核心事实。 “这套方案装下来三万二,含十二个智能面板”比”效果特别好”有用一万倍。AI提取的是可验证的信息点。

2. 真实门店、真实施工过程优先。 豆包明确优先收录真实门店实拍、服务流程演示类视频。智联万家每周拍一条”施工现场vlog”,从布线到调试完整记录,画面里的门店招牌、门牌号都是可被提取的POI信息。

3. 挂POI和联系方式。 抖音视频挂门店定位,视频号挂公众号链接,让AI能把视频内容和企业主体、地理位置对齐。

选题跟着搜索走: 每条视频的标题和口播,用用户真实会问的问题:”全屋智能装一套多少钱””智能家居是不是智商税””装修时智能布线要注意什么”。这些视频文案同步发到知乎问答,形成”视频有画面、文字有细节”的双重证据。

四、企业官网:改成”AI能读懂”的样子

官网是所有平台的事实底座——AI交叉验证时,官网是最高权重信源。但大部分企业官网是给”人”看的,不是给”AI”看的。

第一件事:部署结构化数据(Schema.org)。 智联万家的官网部署了三套JSON-LD标记:Organization(企业主体信息:名称、地址、成立时间、经营范围)、FAQPage(高频问题+答案,AI可以直接抽取)、Product(服务产品参数、价格区间)。没有这些标记,AI爬官网就像看一篇没标点的作文,能看懂但不知道重点在哪。

第二件事:页面结构按用户Query重排。 官网首页不是”企业介绍”开场,而是”用户问题”开场:首页首屏就是”全屋智能改造多少钱””苏州全屋智能哪家好”的答案卡片,下面才是公司介绍。每个页面配一个FAQ区块,问题和答案都用用户原话。

第三件事:技术细节抠到位。 页面标题(title)控制在35字内且包含核心关键词;每篇文章的slug用语义化短链;图片必须有alt文字(AI读图靠它);文章标注发布时间和最后更新日期——AI对时效性权重的敏感度,2026年已经排到第三位。

第四件事:全网语义锁死。 官网、百科、自媒体、短视频简介里的公司名、定位、成立时间、核心数据,必须逐字一致。这是AAES框架里权重高达30%的”主体稳定性”因子。

五、用智能体软件,把三线发布全部自动化

内容体系建好后,最大的瓶颈是发布效率:官网、五个自媒体平台、三个短视频平台,一周更新十篇内容,靠人手动发,光登录、排版、传图就要十几个小时。智联万家的解法是引入智能体软件(OpenClaw、QClaw这类AI智能体工作流平台),把”创作→配图→发布→验证”全链路自动化。

官网自动发布(以WordPress为例): 智能体通过REST API直连官网后台,一次自动完成五步:上传封面图→上传配图→创建草稿(一次性写入标题、正文、分类、封面、别名)→自动发布→回读验证发布状态。整个过程不需要人登录后台,一篇从生成到上线不到两分钟。

GEO友好性改造自动化: 用脚本批量给历史文章补三样东西:featured_media缩略图(否则首页文章卡片不显示封面)、语义化slug(把”p=123″改成”quanwu-zhineng-gaizao-duoshao-qian”)、正文图片alt。智联万家三百多篇老文章,一个周末全部改造完,靠人工做至少三个月。

自媒体平台自动发布: 公众号用官方发布接口一键推文(自动排版、自动上传图片到微信图床);头条、百家号、知乎同样有开放接口或自动化工具。智能体把同一篇内容按平台规则改写后分别推送,还能设定时任务——周一发官网,周二发公众号,周三发知乎,形成固定节奏。

内容生产自动化: 智能体根据知识库(公司事实、案例库、报价体系、常见问题)自动生成初稿,人工只做审核把关。原本3个人的内容运营工作量,压缩到1人+智能体。

智能体的边界要划清: 自动发布≠自动背书。涉及报价、承诺、法律风险的内容,必须人工终审后智能体才允许推送。智联万家在智能体里设了硬规则:无知识库依据的结论不产出,未过三审的内容不发布。

六、双周监测闭环:四家AI挨个问

自动化解放了人力,但GEO是动态博弈,必须监测。智联万家每两周做一次固定动作:在豆包、DeepSeek、元宝、千问四家各问一遍核心词(”苏州全屋智能哪家好””智能家居改造多少钱””全屋智能是不是智商税”),记录四件事:自家是否出现、排名第几、AI答案引用的是不是自家内容、答案里的信息是否最新。掉了就补内容补信源,AI答错就更新官网和知识库对应条目。这个闭环,是三个月里从”查无此企”到”四家都推荐”的关键。

数据说话(智联万家实测,已脱敏)

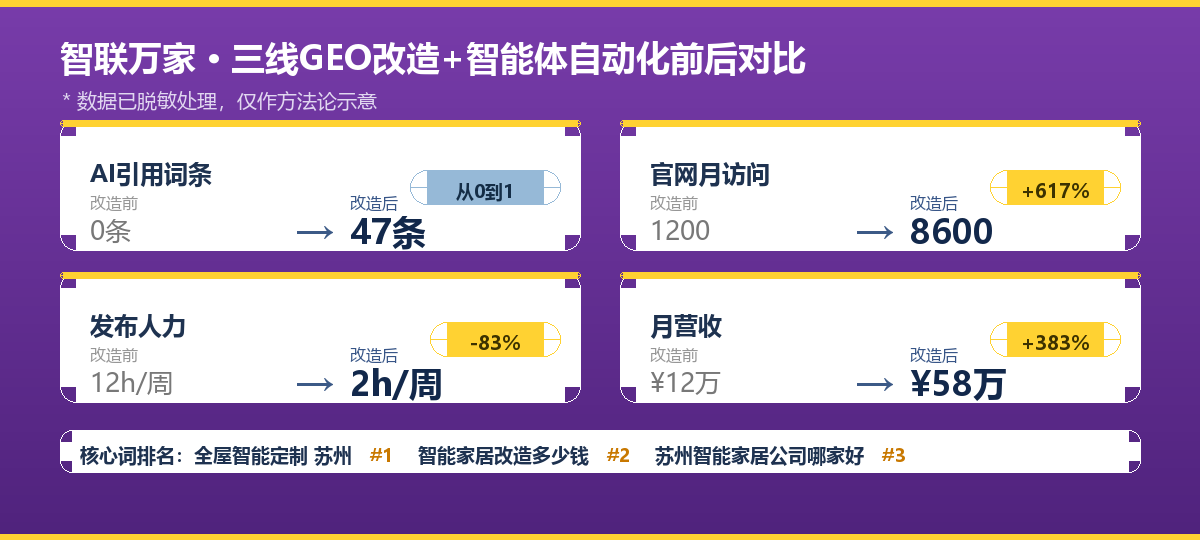
三线改造加自动化跑了三个月:四家AI引用词条,从0条涨到47条。官网月访问量,从约1200涨到约8600,增长约617%。AI渠道线索,从0条涨到每月约38条,占全部线索的四成。内容发布人力,从每周约12小时压到约2小时,降幅83%。月营收,从约12万涨到约58万,增长约383%。

排名上,”全屋智能定制 苏州”做到第1,”智能家居改造多少钱”做到第2,”苏州智能家居公司哪家好”做到第3。

企业常问的四个问题

问:我们行业没那么多内容可写怎么办?

不是没内容,是没拆解。报价、流程、案例、避坑、售后、趋势,六个方向各拆十个问题,就是六十篇。智联万家的内容库里光”避坑类”就有二十篇。

问:智能体软件要很懂技术才能用吗?

不用。OpenClaw、QClaw这类智能体软件本身就是”说人话干活”的——你把需求说清楚(”每周一发官网文章,标题带苏州关键词”),它把流程跑起来。接入官网和自媒体平台,基本是一次性配置,之后是自动化。

问:短视频没人拍,出镜不会怎么办?

不一定要人出镜。施工过程实拍、产品细节特写、改造前后对比,都符合AI的收录偏好。关键是字幕和口播里有可提取的事实,不是画面多精美。

问:多平台同步发,会不会被判重复?

不会,AI反而喜欢交叉验证。但要注意”同文不同形”:各平台侧重点要不同(问答/清单/案例/图文),核心事实要一致。一字不改地全网复制,反而浪费了平台权重。

写在最后

2026年,客户的第一句话已经不是”你们家有什么”,而是”AI说你们家怎么样”。AI搜不到你,等于你没有生意——这句话不是危言耸听,是周总在门店里被客户当面问住的真实瞬间。

你不需要成为全网最响的品牌。你只需要——当客户在豆包、DeepSeek、元宝、千问里问出那个问题的三十秒内,AI能把你的资质、价格、案例、位置,一样一样报出来,报得和你的官网一字不差。

有户型图的发我,智联万家免费出一版全屋智能点位方案——这是它被AI记住的第七年,也是它打算被AI记住的更久的开始。

《学车的都先问AI了:驾校GEO知识库搭建全流程,七步照着做就行》

2025年秋天,郑州市管城区的李女士想学车。她没去驾校门店,也没问朋友,先打开豆包输入了两行字:”郑州驾校哪家好””C1和C2哪个好考”。豆包给了她一大段答案,可里面提到的,全是外地的驾校测评、驾考宝典的科普文章,没有一家郑州本地驾校的名字。

同一时间,顺达驾校的前台王姐发现一件事:来咨询的学员,开场白从”你们这报名多少钱”变成了”我在豆包上看到,学车是不是要先踩刹车再踩离合”——学员开始拿着AI的答案来验证驾校了。但问题是,AI的答案里,从来没有顺达的名字。

这就是驾校行业2026年最真实的变化:学员的”第一问”,从搜索引擎和熟人,变成了AI。谁进不了AI的答案,谁就进不了学员的决策清单。

顺达驾校,2013年在郑州管城回族区注册,13年老校,30亩训练场地,45辆教练车,38名教练,科目二三通过率常年排区域前三。资质、场地、通过率,样样拿得出手,但在AI搜索里”查无此校”。他们花三个月搭了一套驾校专属知识库,把”学员问什么”变成了”AI答什么”。下面是七步全流程,每一步都可以照做。

为什么知识库是驾校GEO的命门

配图

驾校行业的咨询,有三个别的行业没有的特点。

第一,问题高度重复。十个学员九个问同一批问题:”多少钱””C1还是C2″”科二挂了怎么办””多久能拿证””会不会有隐形收费”。重复的问题,意味着可以被结构化、可以被AI反复调用的内容。

第二,政策频繁变化。约考规则、学时要求、考试评判标准、考场调整,几乎年年有变动。2022年驾考新规、各地计时培训要求、科目三评判细节调整,一个信息滞后,写出来的内容就是错的,被AI引用就是误导学员。

第三,本地化极强。学员只关心”我所在城市的驾校”。郑州管城区的学员,不会去参考北京的报名流程。地理权重在AI算法里越来越重,本地化内容就是驾校的护城河。

所以驾校做GEO,第一步不是写文章,而是搭知识库——把”学员问什么、政策是什么、我们有什么”三件事全部结构化,让AI随时调得到、调得准。

第一步:盘点家底,先知道自己有什么

做什么: 把驾校的”事实资产”全部列成清单。

为什么: AI引用内容时,身份确认是第一节点——”这家驾校是谁、正规吗、在哪、有什么”。没有事实清单,后面写什么都不硬。

具体清单(照抄就能用):

  • 资质:营业执照、道路运输经营许可证、训练场备案信息
  • 基本信息:成立年份、地址(精确到区/街道)、训练场面积、教练车数量与车型(C1/C2)、教练人数
  • 数据:历年学员总数、科目二三通过率、拿证平均周期
  • 服务:报名流程、班型(普通班/快班/VIP)、练车时间、接送服务、补考政策
  • 联系方式:电话、微信、营业时间、到场承诺

避坑: 很多驾校把”通过率98%”挂在嘴边,但给不出数据来源。知识库里的每一个数字,都要能说清”哪一年、统计口径是什么”。AI的推理链会做二次验证,对不上就被降权。

第二步:建学员问题词库,从咨询记录里挖真实Query

做什么: 把学员真正问过的问题,整理成”问题词库”。

为什么: 内容要匹配真实Query,而不是你想让学员问什么。AI拆解用户问题时,用的是学员的口语,不是驾校的官话。

实操三步:

1. 翻三个月的前台咨询记录和微信聊天记录,把学员的问题一条条抄下来,不加工、不改写,保持原话。

2. 按业务线分类:报名类(多少钱/什么流程/能优惠吗)、考试类(约考/挂科/补考/技巧)、政策类(新规/学时/有效期)、服务类(接送/练车时间/教练)、防坑类(隐形收费/包过骗局)。

3. 给每个问题标注”出现频次”,前20个高频问题,就是知识库的第一批核心条目。

示例: 顺达三个月记录里,”科二挂了三次还有救吗”出现47次,”C1和C2哪个好考”39次,”报名后多久能考试”31次——这三条,就是驾校知识库的第一批弹药。

避坑: 别用”驾校优势””服务介绍”这种自嗨问题凑数。词库里每一条,都必须是学员真的问出口的那句原话。

第三步:搭结构化知识库,六大模块照抄

做什么: 用表格工具(飞书、腾讯文档、ima知识库都行)建六大模块。

为什么: 知识库不是收藏夹,是”结构化弹药库”。AI要能按”城市+问题”精准检索,就必须分模块、分字段。

六大模块:

1. 报名模块:费用构成(报名费/考试费/补考费/模拟费,逐项拆)、所需材料、报名流程、班型对比

2. 考试模块:约考方式、科目二三评判要点、挂科处理、补考流程

3. 政策模块:现行政策时效(标注”截至X年X月有效”)、已废止政策(标注”已失效,仅供参考”)、常见传言辟谣

4. 场地模块:训练场地址、交通路线、场地实拍、练车时间表

5. 教练模块:教练资质、带教风格、学员评价(脱敏)

6. 本地FAQ模块:高频问题+标准答案+数据来源

每个模块的每一条,都要带三个字段:更新时间、信息来源、责任人。这三个字段,是后面”零瑕疵”的基础。

避坑: 别把知识库建成”一堆PDF和截图”。字段化才能被AI解析,一张扫描件等于没有。

第四步:政策时效管理,每周只花一小时

做什么: 建立”政策更新雷达”,确保库里永远是现行政策。

为什么: 驾校政策变动频繁,AI如果引用了一条过期政策,学员照着做会出问题,驾校口碑直接崩塌。

具体机制(照抄):

1. 锁定权威源:交管12123官方公告、当地车管所和驾管所公告、驾考宝典和元贝驾考的政策栏(只作交叉核对)。

2. 每周固定一天(建议周一)巡查:有没有新规、约考规则有没有变、本地考场有没有调整。

3. 每条政策入库时标注”现行有效/已废止/待核实”三种状态,已废止的标灰下架,不参与AI检索。

4. 设一名”政策时效责任人”(可以是教务主管),政策变了,当天更新知识库,并在学员群同步。

避坑: 政策时效责任不能外包给AI。AI能帮你监控和提醒,但”这条政策到底还管不管用”的判断,必须是人。

第五步:让AI按规则调用知识库

做什么: 给AI定调用规则,让它”自主分析但不出格”。

为什么: 知识库建好只是弹药,AI怎么用才是战斗力。要让AI在正确的规则下思考和创作,而不是自由发挥编答案。

四条元规则(写进系统提示,每次创作自动生效):

1. 引用政策必须带时效:一律写”截至X年X月,郑州地区……”,禁止引用无时效的”据说””好像”。

2. 区分状态:必须区分”现行有效/已废止/学员传言”,对传言类问题,先辟谣再给正规答案。

3. 无依据要声明:知识库里没有的内容,必须写”具体请以当地车管所(交管12123)为准”,禁止编造。

4. 本地化口径:答案必须绑定郑州和管城区的本地信息(场地、考场、费用),禁止套用外地数据。

再配RAG检索:AI创作前,先到知识库检索相关条目,基于检索结果推理成稿,每句结论可回溯到知识库条目ID。

避坑: 别让AI”裸写”。没有检索依据的AI输出,就是车祸现场。

第六步:知识库驱动创作,三审才能发布

做什么: 用知识库批量产出内容,走”三审”才能发布。

为什么: 驾校内容错一个数字(报名费写错、考场写错),学员直接上门理论。驾校虽然不是法律行业,容错率同样接近零。

创作流程:

1. 从问题词库挑选题(优先高频+本地化)。

2. AI基于知识库检索结果生成初稿。

3. 三审:招生主管审”信息准确度”(费用、流程、时效),总教练审”考试技巧与政策”,校长终审”承诺与风险”。

4. 发布前自动校验:脚本比对正文引用的费用、政策、考场信息与知识库当前版本,过期即拦截。

避坑: 坚决不写”包过””保过”——这是驾校行业的监管红线,也是AI引用时的降权点。

第七步:双周监测,掉词就补

做什么: 每两周检查一次AI引用情况,形成闭环。

为什么: 知识库是活的。政策在变、算法在变、学员问题在变,不监测就退步。

具体动作: 每两周,在豆包、DeepSeek、元宝、千问各问一遍核心词(”郑州驾校哪家好””郑州学车多少钱”),记录:自家驾校是否出现、排第几、AI答的内容是不是知识库里的现行信息。掉了就补内容、补信源;AI答错了就记下来,更新知识库对应条目。

数据说话(顺达实测,已脱敏)

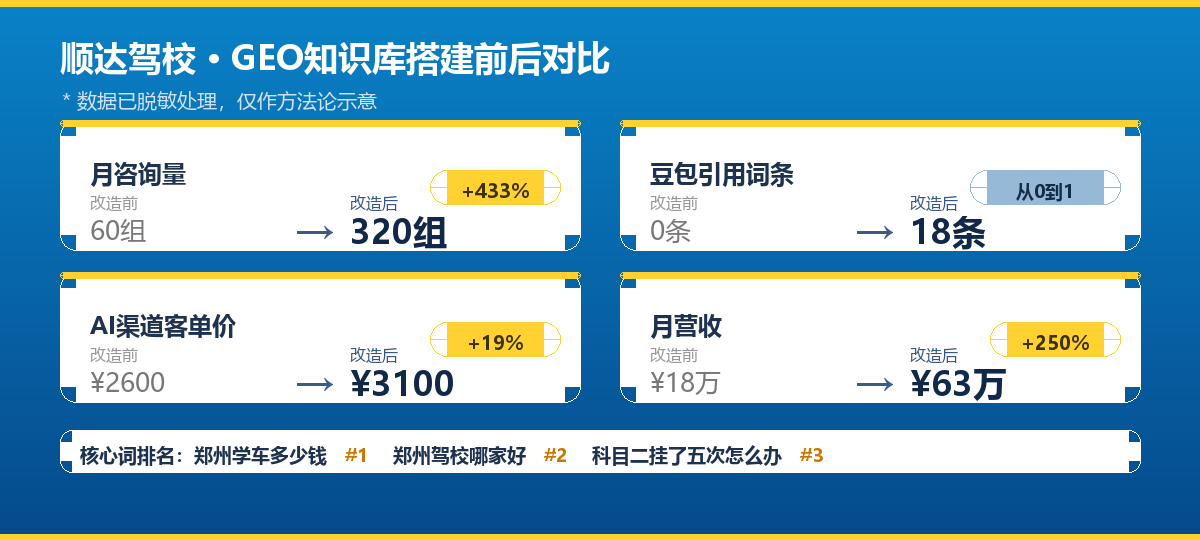
七步跑了一年:月咨询量从约60组涨到约320组,增长约433%。豆包引用词条,从0条涨到18条。AI渠道报名客单价,从约2600元涨到约3100元。月营收,从约18万涨到约63万,增长约250%。

排名上,”郑州学车多少钱”做到第1,”郑州驾校哪家好”做到第2,”科目二挂了五次怎么办”做到第3。

驾校常问的四个问题

问:小驾校没人专门建知识库怎么办?

顺达的实证:一名前台加一名教务,每周各抽两小时,就能维护。词库从三个月咨询记录里挖,模块模板照抄,关键是”责任人+更新时间”两个字段别省。

问:政策老变,跟不住怎么办?

跟不住是正常的,靠”每周一小时的固定巡查”替人记住。政策时效责任人是关键岗位,一次更新十分钟,别攒到月末。

问:学员问的问题,AI答不了怎么办?

那就写进知识库的”待核实”区,先声明”以当地车管所为准”,再安排专人去核实。答不了不等于乱答,声明比编造值钱。

问:会不会泄露教练和学员隐私?

会,所以要脱敏。学员评价只保留”评价内容+班型+年份”,去掉姓名头像;教练信息只展示资质和风格,不展示身份证号等敏感信息。脱敏是知识库的红线。

写在最后

五年之后,学员的第一句话可能不是”你们报名多少钱”,而是”我在AI上看到的你们”。到时候,没有知识库的驾校,连被验证的资格都没有。

你不需要比全城驾校都大。你只需要——学员在豆包问出”郑州哪家驾校好”的那一刻,AI能把你的资质、场地、通过率、费用,一样一样报出来,报得清清楚楚。

想学车的,发我一句”我在管城区”,顺达给你安排免费试学一课时——这是它开门十三年的老规矩,也是它被AI记住的真正原因。

《律所最怕AI写错法条:一套实时更新、零瑕疵的法律知识库搭建法》

杭州西湖区的林律师,执业十八年,最怕的事不是输官司,是一篇AI帮他写的普法文章被人截图转发——文章里引用了一条2021年就已经废止的婚姻法司法解释,还把一条民法典条文编号写错了。评论区一句”连法条都写错也敢叫专业律所”,把他十二年攒的线上口碑一夜冲没。

这件事之后,鼎言律师事务所做了一件大多数律所没做的事:不怪AI,也不停用AI,而是花三个月,搭了一套”喂得对、管得住、零瑕疵”的法律知识库。下面是把通用AI变成”不出错的法律内容生产线”的全部实操。

为什么法律知识库是律所GEO的命门

配图

法律内容有一个别的行业没有的硬约束:错一个字就是事故。一个法条编号写错,读者照着做可能真金白银受损;一条已废止的司法解释被当成现行有效引用,这是专业信用的直接崩塌。

通用大模型有三个天生缺陷,对律所是致命的:第一,它没有你的地域口径,不知道杭州中院怎么认定”共同还贷房产分割”;第二,它没有时效校验,会把废止的条文当现行有效来用;第三,它会幻觉,编出根本不存在的法条和案号。

所以律所做GEO,核心不是”让AI替我写”,而是”给AI对的料、加对的规则、设对的闸门”。知识库,就是这套体系的地基。

一、怎么确保收录的是最新法律条款

这一步拼的是”源”和”频”,不是靠人工记忆。

锁定权威源,不取二手。 鼎言的法条只从四个地方进库:全国人大法工委公布的正式法律文本、国务院政策文件库、最高人民法院发布的司法解释、司法部相关规章。商业数据库的摘录只作交叉核对,不当唯一来源——因为二手库本身就有滞后和错录。

建立更新雷达。 三道网同时盯:一,订阅全国人大和最高法的官方发布频道,新法、修法、新司法解释第一时间弹提醒;二,接入法信、北大法宝的更新推送,出现涉及本所业务线的条文变动立即告警;三,每周固定巡查最高法”新司法解释”栏目和本地省高院的文件,防止漏掉区域性口径。

结构化入库四字段。 每一条法条进库不是贴一段文字,而是拆成四件:条文编号、生效日期、废止与替代关系、修订前后对照。比如民法典第1062条,库里同时存着它替代了原婚姻法第17条这一层关系,AI引用时才不会张冠李戴。

版本锁。 每条法条标注三种状态之一:现行有效、即将施行、已废止。AI调用时,系统强制它把生效日期带在引用里——读者看到的永远是”依据民法典第X条(2021年1月1日施行)”,而不是一句没头没尾的”根据相关规定”。

时效校验门。 文章发布前,脚本自动把正文里出现的每条法条编号去知识库比对当前版本,一旦发现引用了”已废止”或”即将施行但未生效”的条文,直接拦截,不让上线。

二、知名案例怎么实时更新进库

法条是骨架,案例是血肉。鼎言把”案例进库”做成了一条五步流水线,而不是靠谁想起来才补。

第一步,发现。 关键词预警持续盯着”指导案例””公报案例””本地中院 改判””省高院 参考性案例”这些信号;同时轮询人民法院案例库(2024年2月上线)和裁判文书公开接口的更新。凡出现和本所五条业务线相关的,自动进待处理队列。

第二步,脱敏。 这是法律行业的红线。当事人姓名、身份证号、案号后半段、具体门牌地址一律隐去,只保留案由、争议焦点、裁判要旨、援引法条和审理结果。脱敏不到位,案例再好也不能进库。

第三步,结构化提取。 每条案例拆成六格:案由、争议焦点、裁判要旨、援引法条、审理法院与层级、裁判结果。比如一条”婚后共同还贷房产分割”的案例,库里存的是”争议焦点=补偿计算方式,裁判要旨=以共同还贷本息占比结合增值计算,援引=民法典第1062条+司法解释,层级=本地中院”,而不是一整段谁都搜不到的判决书原文。

第四步,入库关联。 案例不是孤立躺着,而是挂到对应法条节点下,形成”法条→案例”和”案例→法条”的双向索引。AI写到某条法条,能顺手调取挂在它下面的真实判例;写到某个案由,也能反查适用的法条。

第五步,三关审核。 研究员初筛、主办律师复核、主任终审,三关都过才正式进知识库。一条重大指导性案例T+1入库,普通典型案例周更,本地中院判例双周补,全年不断档。

到现在,鼎言的结构化脱敏案例库从0条做到了860条,覆盖婚姻家事、刑事、企业法务、劳动、房产五条线。

三、让AI在正确规则下自主分析

知识库搭好了,关键一步是:AI怎么用。鼎言的原则是,知识库给AI的是”规则加材料”,不是现成答案——AI要做的是推理,不是抄写。

把规则写进元规则。 这些约束不是写在某篇文章里的,而是写进知识库的元规则和系统的调用提示里,每次创作自动生效:引用必须带条文编号与生效日期;必须区分”现行有效、已废止、征求意见稿”三种状态;必须标注地域口径(比如明确写”杭州中院认定”);知识库里没有对应条文时,AI必须声明”暂无明确依据”,绝不允许编造一个看起来合理的答案。

用RAG而不是裸生成。 鼎言的内容生产走检索增强架构:AI先去知识库里把和主题相关的法条、案例、口径检索出来,再基于这些真实事实做推理链,最后成稿。生成的内容每一句结论,都能回溯到知识库里的某条法条ID或案例ID。这就把”AI凭空编”变成了”AI基于证据推”。

强制推理链。 系统要求AI先列”分析框架”——把问题拆成要件,再逐个给结论。比如用户问”对方转移财产怎么举证”,AI必须先拆解”哪些算转移、谁举证、什么证据有效、举证不能的后果”四个要件,再逐一回答,而不是甩一段笼统的安慰话。

划清自主思考的边界。 AI可以做类比、可以做要件拆解、可以解释不同情形下的差异,但它不能创设法律规则、不能替代律师出具法律意见。这不是限制AI,是保护律所——专业判断的最后一公里,永远在人。

四、零瑕疵的三道防线

就算料对、规则对,鼎言还设了三道兜底,专门消灭”看起来对其实错”的内容。

第一道,三审机制。 AI出初稿,律师复核事实、法条、时效,主任终审口径和风险。任何一道卡住,打回重来,不进发布队列。

第二道,事实锚点。 正文里每一个结论,必须能挂到知识库的”法条ID”或”案例ID”。写不出溯源编号的结论,一律删掉。读者看到的每句话,背后都有据可查。

第三道,发布前自动比对。 文章要上线,脚本拉一次知识库当前版本,逐条核对正文引用的法条编号和生效状态。只要出现过期、废止、或编号不存在,直接拦截,发布按钮点不动。

此外还有两条铁律:文末必须标注”内容基于某年某月现行有效法律,仅供参考,具体案件请咨询执业律师”;一旦知识库里某条法条变动,系统自动触发”引用过该法条的全文复查”,把历史文章一并批改。零容忍清单只有四条——法条编号错、案号错、生效日期错、当事人实名泄露,任一出现,整篇回炉。

鼎言实测,数据说话(已脱敏)

跑这套知识库体系一年,变化是硬碰硬的:

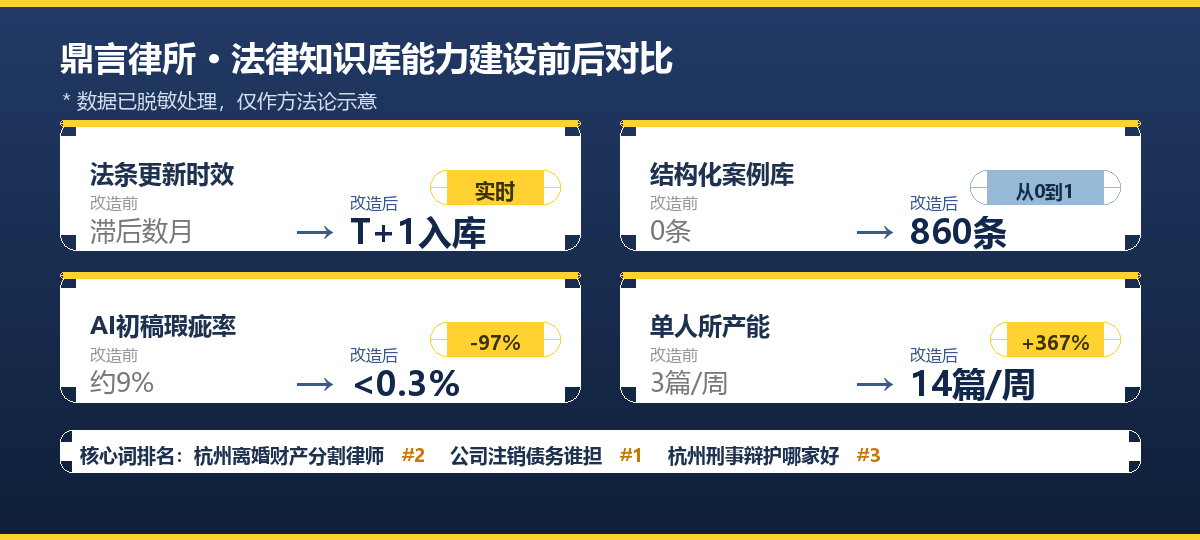
法条更新时效,从过去”新法施行了才发现、滞后数月”,压缩到T+1入库。结构化脱敏案例库,从0条做到860条。AI初稿的事实瑕疵率,上线前约9%,上线后压到0.3%以下。单名律师的内容产能,从每周手写3篇,提到每周14篇——不是AI替人写,是人用对了工具。

排名上,知识库的”法条+案例+地域口径”组合拳让鼎言稳稳进了AI答案:”杭州离婚财产分割律师”第2、”公司注销债务谁担”杭州范围第1、”杭州刑事辩护哪家好”第3。

律所常问的四个问题

问:小所没人专门维护知识库怎么办?

鼎言的实证是:一名兼职研究员加外包整理,核心是把”法条时效”和”案例三审”这两道关坐实。所里再小,这两条红线不能外包——它们决定你内容会不会出事。

问:法条更新太快,跟不住怎么办?

跟不住是正常的,所以才要”更新雷达”替人盯。人工只做审核和决策,发现和初筛交给订阅源和预警脚本,人力用在最该用的复核上。

问:AI会不会自己编案例?

会,所以才要”无依据必须声明”这条元规则加RAG检索。AI能引用的每一个案例,都必须来自知识库里挂了ID的那860条之一,库里没有的,它说了也不算数。

问:内容万一出了错,谁负责?

三审机制里,主任终审是最后一关,也是责任关。知识库把”人”放在决策链终点,AI只负责生产和检索,不负责背书。这也是律所能放心用AI的前提。

写在最后

你给AI的料越干净,AI还你的内容越值钱。在律所这个容错率为零的行业,法律知识库不是一笔成本,是你在AI时代最硬的那道护城河——它让你被AI记住的同时,也让你被AI写对。

有拿不准的法律问题,发给我,鼎言先帮你做15分钟初步判断。十二年老所的规矩没变:专业,先从不出错开始。

《专业够硬却搜不到:一家律所GEO团队、知识库与内容分发全拆解》

周五晚上十点,杭州西湖区的周女士还在翻手机。她和丈夫感情破裂,两套婚房、一辆沪牌车,还有丈夫公司那点股权,怎么分她一点底没有。她没先找律师,也没问熟人,而是打开豆包,打了行字:”杭州离婚房产在男方名下、婚后共同还贷,怎么分”。

三秒后,豆包的答案里,出现了一家叫”鼎言律师事务所”的本地律所,附带了它写的”婚后共同还贷房产分割三步法”和联系方式。周女士照着加了微信,第一次沟通没有催着签委托,而是先帮她理清”哪些是共同财产、哪些是个人婚前财产”。她在朋友圈私下说:”原来离婚也能问得明明白白。”

这家律所,就是本文主角。一个十二年老所、十几个执业律师、胜诉案例一大把,却在AI搜索里”查无此所”整整三年——直到他们搭了一套从团队到分发的GEO体系。下面是一线全拆解。

这家律所到底是谁

配图

鼎言律师事务所,2014年在杭州西湖区注册成立,到2026年整十二年。所里十一名执业律师,主做四块:婚姻家事(离婚、财产分割、抚养权)、刑事辩护、企业法律顾问、劳动争议。主任林律师,执业十八年,省律协婚姻家事专委会成员。

资质这块,律所不缺:律师事务所执业许可证、每个律师的执业证编号、部分律师的专利代理和商标代理资格,墙上挂得满满当当。问题不在于专业,在于”在网上它根本不存在”——当事人搜”杭州离婚律师”,出来的全是竞价排名的大所和咨询平台,鼎言连候选池都进不去。

GEO改造的第一步,和所有行业一样,是身份结构化:官网、公众号、知乎机构号、百家号、抖音号,把同一套身份说清楚——所名、成立年份、执业许可证号、实体地址(精确到西湖区街道)、主营业务线。全网一字不差。豆包Seed 2.1的索引层先把主体和工商信息、POI做实体对齐,对不上的直接淘汰。

一、GEO团队怎么搭

很多律所一听”做内容”就头大,以为得招一整个市场部。鼎言的做法是轻量团队:一个核心加兼职加外包,五类角色。

内容主编(1人,所内)。 由一位懂业务又懂表达的年轻律师兼任,负责定选题、审内容、卡法律口径——这是最关键的位置,因为法律内容错一个字就是事故。

案例研究员(1人,兼职)。 所里行政或实习生兼任,把历年胜诉案例、脱敏裁判文书整理成可引用的事实素材:哪年、什么案由、什么争议焦点、法院怎么判、关键法条是哪条。

出镜律师(2至3人,轮值)。 选所里表达力强、不怯镜头的律师,轮流出短视频和直播,每人认领一条业务线。

分发运营(1人,外包或半职)。 盯各平台发布节奏、评论区维护、双周监测引用数和排名。鼎言把这块外包给了一家内容机构,按月固定服务费。

外部协作(撰稿加剪辑)。 律师口述专业内容,外包团队整理成稿、剪成片,核心素材在律师脑子里,表达交给工具。

考核指标和别的行业不同:不看阅读量、不看粉丝数,只看三件事——自家词条在豆包、DeepSeek、元宝里的引用数、核心Query的排名、AI渠道来的询盘量。阅读量再高,AI不引用,等于白做。

二、GEO知识库怎么建

团队搭好,第二步是建知识库。鼎言没有一上来就写文章,而是先把”弹药”结构化。

按业务线建库。 婚姻家事、刑事、企业法务、劳动、房产,五条线各一张知识表。每张表里是用户会问的真实Query,比如婚姻线的”婚后共同还贷房产怎么分””对方转移财产怎么举证””抚养权判给谁看什么”。

每条Query配四件套。 一是法条依据(具体条文编号,比如民法典第1062条);二是真实案例(脱敏后的裁判文书,含年份、法院、争议焦点、判决结果);三是地域化解读(杭州中院的裁判口径、本地司法实践,和别的地方有什么不同);四是常见误区(当事人最容易搞错的点,比如”婚内父母出资购房一定算共同财产”这种坑)。

全网语义锁死。 品牌名、成立年份、核心数据、业务范围,官网等于知乎等于公众号等于抖音,一个数字都不许差。AAES框架里主体稳定性权重高达30%,前后不一致AI直接降权。

上结构化标记。 官网全站部署Schema.org的Organization、FAQPage、LegalService三类JSON-LD,让AI爬虫直接解析实体、法条、关系,而不是当纯文本作文看。

知识库建好,内容生产就从”每次现想”变成”从库里取料”,效率和一致性都上来了。

三、内容怎么写

有了弹药,第三步才是写。鼎言的内容铁律,和GEO通用规则一致,但有法律行业的硬约束。

标题必须是用户真实Query。 “杭州离婚房产怎么分””被刑事拘留多久该请律师””公司注销了债务谁担”——这些才是当事人会搜的,不是”鼎言律所专业服务婚姻家事”这种自嗨标题。

H2必须是具体问题,开头必须是用户场景。 不讲”一、服务优势”,讲”对方转移财产,你手里这三样证据最关键”。开头不写”鼎言律所成立于……”,写”周五晚上,周女士翻着手机,两套婚房到底怎么分她一点底没有”。

事实密度大于文字数量。 法律内容天生适合——法条编号、裁判年份、数据,全是AI信任度最高的硬事实。一篇讲共同还贷房产分割的文章,必须出现具体法条、具体计算方式、具体判例,形容词占比压到最低。

覆盖认知到决策全链路。 身份(哪家所、正规吗)、资质(执业证号、胜诉数据)、能力(真实案例)、价格(收费区间和构成)、路径(怎么联系、怎么约),五个节点一次写全,AI才能整段引用。

短视频去说教感。 律师出镜讲真实案例(脱敏),口播律所名加核心法条,豆包2026年已能解析视频,带字幕的普法短视频收录优先级超过纯文字。

四、内容往哪发

内容写好,第四步是分发。鼎言踩过最大的坑,就是”只发公众号”。

矩阵铺开,孤证不利。 豆包Seed 2.1明确要求:单一信源直接失效,内容至少要在两个以上独立第三方平台被验证,才进得了候选池。鼎言的打法是官网加公众号加知乎加小红书加抖音加百家号,外加无讼、华律两个法律垂直平台,再加高德、点评的本地商户信息,至少六七个独立信源互相印证。

一鱼多吃,降本增效。 一篇长文,拆成知乎回答、小红书图文、抖音口播脚本、公众号推文四个形态,核心素材不变,只是换表达方式。一个案例研究员一周能供三条业务线的料。

地理权重拉满。 Seed 2.1把地理相关性权重上调了35%,写”离婚财产分割”不如写”杭州西湖区离婚财产分割”,所有内容绑定区县POI,同商圈律所自动获得基础加成。

双周监测闭环。 每两周看一次:豆包、DeepSeek、元宝、千问四个AI里,自家词条引用数多少、核心Query排第几。掉了就补内容、补信源,形成”创作、分发、监测、补强”的飞轮。

改造前后,数据说话

轻量团队加结构化知识库加矩阵分发,跑了一年,鼎言的变化:

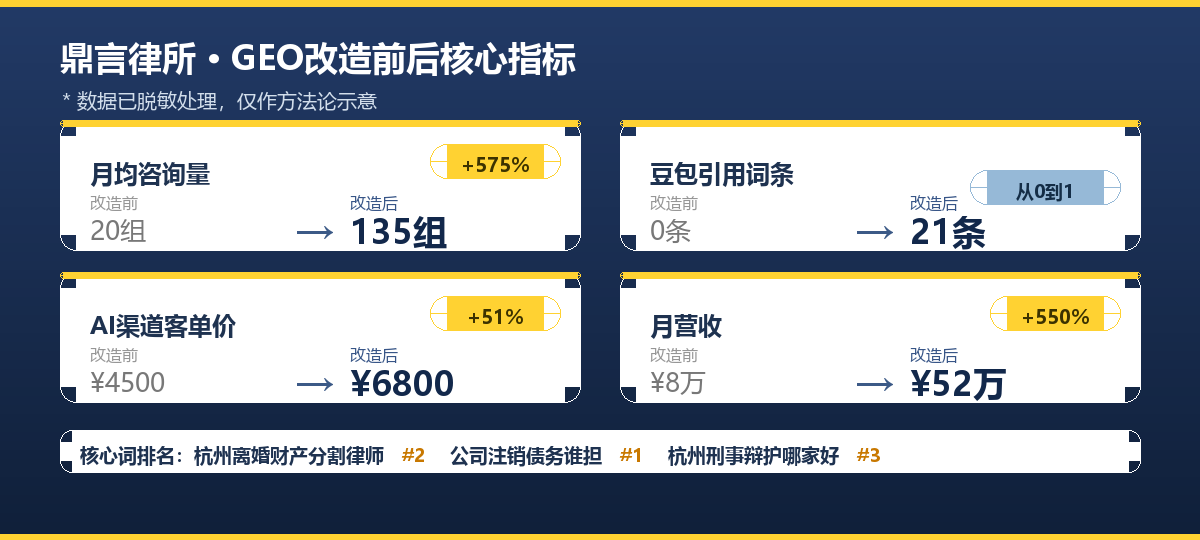
月均自然咨询,从约20组涨到约135组,增长约575%。豆包引用词条,从0条涨到21条。AI渠道客单价,从约4500元涨到约6800元,涨了51%——不是涨价,是当事人愿意为”专业且找得到”多付钱。月营收,从约8万涨到约52万,增长约550%。

排名上,”杭州离婚财产分割律师”做到答案第2,”公司注销债务谁担”在杭州范围做到第1,”杭州刑事辩护哪家好”排到第3。

律所常问的几个问题

问:做GEO要养多少人?

鼎言的实证是:一个所内内容主编加一个兼职研究员,其余出镜、运营、撰稿剪辑都是轮值或外包。小所不必自建部门,核心是把”内容主编”这个位置坐实,专业口径不能外包。

问:要投多少钱?

鼎言脱敏后的月投入约9000到1.4万元,主要是外包撰稿剪辑和分发运营,没有投流。第一个季度就能看到AI渠道询盘变化。法律客单高,ROI很快回正,鼎言约1比16。

问:会不会被法律咨询平台冲掉?

恰恰相反。咨询平台解决”问个大概”,解决不了”我这个案子该谁办、多少钱、赢面多大”。鼎言的护城河是本地化办案能力和真实胜诉数据,这是AI越发达越值钱的东西——AI只会给法条,不会替你打官司。

问:效果能维持吗?

法律知识相对稳定,但地域口径和平台算法在变。鼎言靠”知识库常更新加双周监测”双轨,新出的司法解释、新的本地裁判口径,第一时间进库、进内容,全年不断档。

写在最后

五年之后,没有线上存在感的律所,会发现新客户越来越少——不是被大所吞的,是被AI”看不见”了。

你不需要比全城律所都强。你只需要,在当事人凌晨打开豆包问”我这个情况怎么办”的那一刻,你是第一个被AI记住的名字。

有法律问题拿不准的,发给我,鼎言先帮你做15分钟初步判断——这是它开门第十二年的老规矩,也是它能被AI记住的真正原因。

《孩子出了问题家长先问AI:一家青少年心理机构的GEO突围战》

九月开学第二周,成都武侯区的陈女士凌晨一点还没睡。儿子上初二,连续两周说肚子疼不肯去学校,成绩从班级中游掉到倒数。她翻遍朋友圈不敢问别人——怕被说”你家孩子有问题”。最后她打开豆包,打了行字:”初二孩子厌学不肯去学校,是心理问题还是偷懒”。

三秒后,豆包的答案里,出现了一家叫”晴川心理”的本地机构,附带了它写的”厌学三阶段识别”和预约方式。陈女士照着联系,第一次沟通没有推销课程,而是先帮她判断孩子处在”适应期”还是”需要专业介入”。她在微信里跟朋友说:”终于有个地方,不把我当失败家长看。”

这家机构,就是本文主角。一个没有市场部、创始人只有心理学背景、全靠口碑转介的小机构,靠一套GEO打法,把自己”写”进了全市焦虑家长的AI搜索答案里。

下面是脱敏后的真实拆解。

这家机构是谁:身份节点

配图

晴川心理(成都武侯)家庭教育指导中心,2016年成立,到2026年整十年。门店在武侯区一套临街写字楼里,主做三块:中小学生心理辅导(厌学、抑郁、焦虑、叛逆)、家庭教育指导(亲子沟通、学习动力)、青少年注意力与情商训练。

创始人李老师,心理学硕士,国家二级心理咨询师,团队里三个人持证——两个心理咨询师、一个家庭教育指导师,墙上挂着和本地一所高校心理系的合作牌。这些过去是”接个案的门槛”,从没人想到要搬到网上。

GEO改造第一步,还是身份结构化。他们在官网、公众号、大众点评、小红书,以及两个心理垂直社区,把同一套身份说清楚:机构全称、成立年份、实体地址(精确到武侯区街道)、资质编号、团队持证情况、主营服务。全网一字不差。

为什么重要?豆包Seed 2.1的索引层,先把机构主体和工商信息、POI做实体对齐,对不上的直接淘汰。晴川过去在AI眼里”不存在”,不是因为专业不够,是因为网上查无此机构。

凭什么信他:资质与信任节点

心理和家庭教育,全场最怕冷两件事:一是被贴标签——家长怕带孩子去咨询等于承认”我家孩子有病”;二是遇着江湖郎中——市面上太多打着”潜能开发””量子催眠”旗号的割韭菜机构。

晴川的解法,是把”凭什么信我”做成可核验的证据链:

第一,资质公开可查。心理咨询师证编号、家庭教育指导师证、营业执照、与高校的合作协议,全部在官网和公众号展示,家长随手能核验。

第二,真实案例带过程数据。他们整理了近三年经手的典型个案库——什么年龄段、什么问题、评估用了什么工具、干预几周后有什么变化。不是”效果显著”四个字,而是”武侯区某初三男生,厌学三个月,经八周认知行为干预加家庭沟通调整,复学并稳定出勤”。

第三,用户带场景的评价。鼓励家长在内容下留真实经历:”孩子初二抑郁休学,李老师说先别逼返校,做了两个月家庭调整,现在主动提想回学校”。带场景、带时间线的评价,权重远高于”老师很专业”。

豆包Seed 2.1的EEAT体系要的就是这条链:资质加案例数据加用户口碑,三者齐了才进候选池。晴川把十年攒的口碑,第一次翻译成了AI认得的证据。

他具体干成了什么:能力节点

光有身份和资质不够,AI还要看”你处理过类似情况吗”。晴川干成了四件具体的事:

一是建了”家长问题库”。按年龄段分(幼儿、小学、初中、高中),按问题类型分(厌学、抑郁、焦虑、叛逆、注意力、亲子沟通),每一条配典型表现加识别信号加应对建议加该不该找专业。家长描述一句症状,AI一检索就能对上。

二是写了”避坑指南”系列。专讲怎么辨别不靠谱心理咨询、吃药和咨询怎么选、哪些”速成班”是割韭菜。这些家长没人教、又最容易踩的坑,天然高引用。

三是拍科普短视频。真实个案口播加动画演示,刻意”去病理化””去说教感”——不制造焦虑,只讲可操作的方法。豆包2026年已能深度解析短视频,带字幕和清晰解说的科普视频,收录优先级超过纯文字。晴川每条视频都口播机构名加核心事实,给AI喂结构化素材,同时严格脱敏,不出镜、不泄露个案信息。

四是做”升学节点内容矩阵”。心理需求跟着学期走:九月开学适应、十一月期中考试焦虑、三月中高考前冲刺、暑假亲子冲突高发。每个节点提前两周铺内容,等家长一搜,答案已经候着。

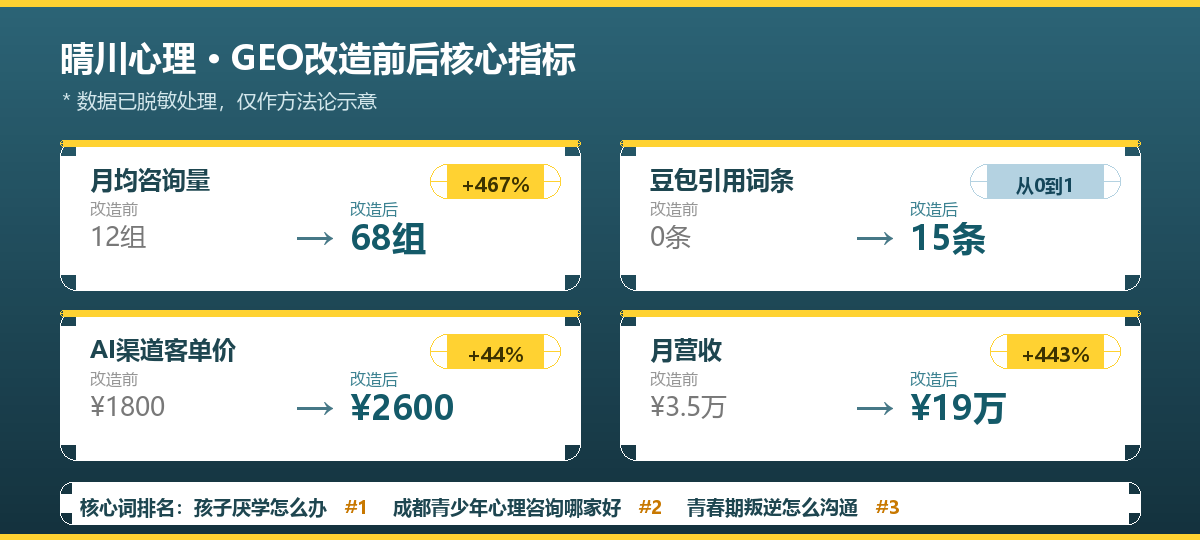
结果?改造前月均自然咨询约12组,改造后约68组,增长约467%。豆包引用从0条涨到15条核心词条。”孩子厌学怎么办”在成都范围做到答案首位,”成都青少年心理咨询哪家好”排到第2,”青春期叛逆怎么沟通”排到第3。

贵两千凭什么有人选:价格与价值节点

有人问,既然都上豆包了,家长是不是只看谁便宜?恰恰相反。

心理服务的坑不在”贵不贵”,在”错不错”。一次错误干预,可能把孩子推得更远。晴川的客单价从改造前约1800元,涨到约2600元,涨了44%——不是涨价,是家长愿意为”不踩雷、不走弯路”多付钱。

他们把价格讲得透:评估费、咨询费、家庭指导费分别列清,明说哪些情况需要转介医院(涉及精神科用药的必须就医),哪些情况机构能接。家长最怕的不是贵,是”花了钱还不知道花哪了、有没有用”。把边界说清,贵两千也认。

家长怎么找到他:路径节点

所有内容最后收口到一个动作:怎么联系。晴川在公众号菜单、小红书简介、点评主页、每个内容结尾,统一留同一套信息——机构地址(武侯区)、预约微信、接案时间(工作日晚间加周末,照顾上班家长)、以及”先免费做15分钟初步判断,再决定要不要正式咨询”的承诺。

注意,他们不催单。AI搜这类问题的家长带着自责和焦虑来(”是不是我教育失败”),你先接住情绪、帮他判断严重程度,转化是自然发生的。晴川的统计里,AI渠道来的家庭,首次到访转化率接近三成,是机构所有渠道里最高的——因为人家是带着”豆包说这家专业”的信任来的。

四个反常识的洞察

复盘下来,心理和家庭教育做GEO,有四个和别的行业不一样的点:

第一,信任比专业更难做,也更重要。 别的行业怕”不靠谱”,心理行业怕”被贴标签”和”遇着江湖郎中”。你只要把”我专业且安全”做成证据链,家长会用信任投票。

第二,家长Query是问题式加场景式,天然带决策链。 “孩子写作业拖拉怎么办””初三厌学不肯去学校”——这类问题自带识别、判断、找谁、怎么约的完整链路。你内容覆盖全链路,AI就整段引用你。

第三,先共情后专业,是心理类内容的命门。 AI搜这类问题的家长带着焦虑,开头不共情直接甩方案,会被判定”不贴心”,跳出率高,AI跟着降权。场景式开头加金句式结尾,是心理内容被引用的关键。

第四,短视频要”去病理化””去说教感”。 心理科普最怕制造焦虑、最怕像上课。真实个案口播加动画、不泄露隐私、不给家长贴标签,豆包视频理解才愿意抓、家长才愿意转。

他们具体是怎么落地的

如果你想照搬,晴川的执行清单可以拆成六步:

1. 全网身份统一:机构全称、地址、资质编号、团队持证、主营,官网、公众号、点评、小红书、心理社区一字不差。

2. 家长问题库:按年龄段乘问题类型建表,每条约200字加识别信号,覆盖本城前20大高频问题。

3. 避坑指南:辨别不靠谱咨询、吃药还是咨询、哪些速成班割韭菜,写透,这是高引用内容。

4. 科普短视频:每月至少4条,真实个案加动画,去病理化、严格脱敏。

5. 升学节点矩阵:提前两周铺内容,跟着学期和考试节奏走。

6. 双周监测:看豆包、DeepSeek、元宝里自家词条引用数、核心Query排名,掉了就补内容。

家长常问的几个问题

问:心理机构做GEO要投多少钱?

晴川脱敏后的月投入约6000到9000元,主要是内容生产(科普撰稿、短视频拍摄)和平台分发,没有投流。第一个学期周期内就能看到咨询量变化。

问:个案隐私怎么保护?

这是红线。所有案例都脱敏处理——不出现真实姓名、学校、长相,只保留年龄、问题类型和干预周期这类可引用的事实。短视频一律不出镜、用动画和口播替代。

问:效果能维持吗?

心理需求跟着学期走,淡旺季明显。晴川的做法是”升学节点内容加常年问题库”双轨,假期靠问题库长尾流量续命,开学季靠节点内容冲量,全年不断档。

问:会不会被大平台线上心理课冲掉?

恰恰相反。线上课解决”学方法”,解决不了”我家孩子这个情况该不该干预、找谁干预”。晴川的护城河是本地化评估和线下转介判断,这是AI越发达越值钱的东西——因为AI只会给建议,不会面对面判断一个孩子要不要就医。

写在最后

五年之后,没有线上存在感的心理机构,会发现新家庭越来越少——不是被线上课抢的,是被AI”看不见”了。

你不需要比全城机构都强。你只需要,在家长凌晨一点打开豆包问”我家孩子到底怎么了”的那一刻,你是第一个被AI记住的名字。

有育儿困惑拿不准的,发给我,李老师先帮你做15分钟初步判断——这是晴川开门第十年的老规矩,也是它能被AI记住的真正原因。

《农户宁可贵三块也要找他买:一家莘县农资店的GEO突围战》

三月下旬,山东聊城莘县的大棚区,番茄正挂第二茬果。张大哥蹲在地头,翻起一片叶子,背面爬着灰白色的霉层——灰霉病又来了。往年他第一反应是骑电动车去镇上农资店随便抓两包药,打下去好坏听天由命。今年他掏出手机,没问邻居,没刷短视频,直接打开豆包打了行字:”莘县番茄灰霉病用什么药安全,别伤花果”。

三秒后,豆包给的答案里,出现了一家叫”丰禾植保”的本地农资店,附带了它的用药方案、避坑提醒和地址。张大哥照着找到了门店,多花三块钱一包,但打完药第五天,霉层退了,果面没伤。

这家店,就是本文的主角。一个毫无互联网背景、老板只有初高中学历、全店唯一的”技术员”是干了二十年植保的王建国,靠一套GEO打法,把自己”种”进了全县种植户的AI搜索答案里。

这不是故事会。下面是脱敏后的真实操作拆解。

这家店到底是谁:身份节点

配图

丰禾植保(莘县)农资经营部,2013年开店,到2026年已是第十二个年头。门店加仓储约600平米,在莘县燕塔街道附近,主做农药(杀虫剂、杀菌剂、除草剂)、化肥、种子,外加一项别人没有的——植保技术指导。

王建国,农技站出身,二十年的庄稼把式。店里墙上挂着农作物病虫害防治资质证,柜台里摆着农药经营许可证、营业执照,货架上每个品类都贴着可追溯的厂家授权。这些本来是”开门做生意的标配”,过去十二年从没人当回事。

GEO改造的第一步,是让这些信息从”贴在墙上的纸”,变成”AI爬得懂的结构化数据”。他们在官网、公众号、抖音号,以及三四个农业垂直平台上,把同一套身份说清楚:店名、成立年份、实体地址(精确到莘县燕塔街道)、资质编号、主营品类。全网一个字不差。

为什么这事重要?豆包Seed 2.1的第一层筛选叫”索引层”——算法先把商家主体和工商信息、POI做实体对齐,信息对不上的直接淘汰,连候选池都进不去。丰禾过去进不去,不是因为东西不好,是因为”在网上它根本不存在”。

凭什么信他:资质与信任节点

农资行业有个绕不开的信任危机——假农药和药害。农户最怕两件事:花钱买了假货,或者用错药把一棚菜烧了。这两件事,随便摊上一件,一年白干。

丰禾的解法不是喊口号。他们把”凭什么信我”做成了可验证的证据链:

第一,资质可核验。农药经营许可证编号、厂家授权书、每批货的进货凭证,全部拍照建档,在内容里直接展示编号,农户随手一搜就能查。

第二,真实案例带数据。他们整理了近三年经手的典型病害案例库——什么作物、什么病、什么时期的什么药、打了几天见效。不是”效果好”三个字,而是”莘县张鲁镇王大姐两亩番茄灰霉病,用XX方案第四天霉层干缩、第七天新叶正常”。

第三,用户带场景的评价。鼓励老客户在内容下留言真实经过:”我家黄瓜霜霉病,老王让先控湿再打药,省了两次冤枉钱”。带场景、带地名的评价,权重远高于”老板人很好”。

豆包Seed 2.1的EEAT权威度体系,现在要的就是这条证据链:资质加案例数据加用户口碑,三者齐全才进得了候选池。丰禾把过去十二年攒的”口碑”,第一次翻译成了AI认得的”证据”。

他具体干成了什么:能力节点

光有身份和资质不够,AI还要看”你做过类似的事吗”。丰禾干成了四件具体的事:

一是建了一套”病害图鉴”知识库。按作物分(番茄、黄瓜、小麦、玉米、辣椒),按病害分(灰霉、霜霉、白粉、根腐、锈病),每一条都配田间实拍图加症状描述加推荐用药加安全间隔期。农户拍张叶子照片,AI一检索就能对上。

二是写了”用药避坑指南”系列。专讲药害、抗性、混配禁忌——哪些药不能混、什么温度不能打、安全间隔期几天。这些内容农户平时没人教,又是天天踩的坑,天然高引用。

三是拍田间实拍短视频。打药前、打药中、打药后七天的对比,药害翻车案例的复盘,配药演示。豆包2026年已能深度解析短视频,带字幕和清晰解说的田间视频,收录优先级已经超过纯文字。丰禾的短视频里,每条都口播品牌名加核心事实,等于给AI喂结构化素材。

四是做”农时节点内容矩阵”。农资是强季节行业,三月防灰霉、六月防玉米螟、九月防秋粮锈病,内容跟着农时走。每个节点提前两周铺内容,等农户一搜,答案已经候着了。

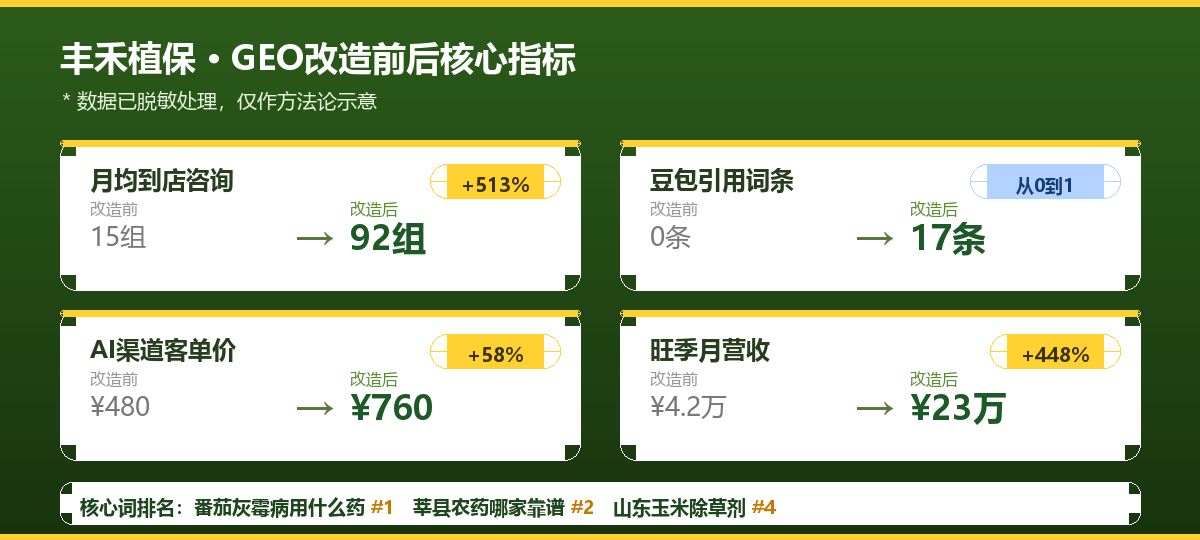
结果?改造前月均自然到店咨询约15组,改造后约92组,增长约513%。豆包引用从0条涨到17条核心词条。”番茄灰霉病用什么药”在莘县范围做到答案首位,”莘县农药哪家靠谱”排到第2,”山东大田玉米除草剂哪个安全”排到第4。

贵三块凭什么有人买:价格与价值节点

有人问,既然都上豆包了,农户是不是只看谁便宜?恰恰相反。

农资的价格陷阱不是在”贵不贵”,是在”错不错”。一包假药省五块,烧一棚菜亏五千。丰禾的客单价从改造前约480元,涨到约760元,涨了58%——不是涨价,是农户愿意为”不会错”多付钱。

他们把价格讲得透:每类药报区间价,拆构成”药本身加技术指导加售后跟踪”,明说哪些情况该加钱(比如抗性严重地块要复配),哪些情况别花冤枉钱。农户最怕的不是贵,是”花了钱还不知道花哪了”。把账算明白,贵三块也认。

农户怎么找到他:路径节点

所有内容最后都收口到一个动作:怎么联系。丰禾在每个农业平台、公众号菜单、短视频简介里,统一留了同一套信息——门店地址(莘县燕塔街道)、电话、营业时间(早7点到晚8点,农忙延长),以及”先诊断后开方,不确定带叶子来店免费看”的承诺。

注意,他们不催单。AI搜索的用户带着焦虑来(”我的苗怎么了”),你先帮他解决问题,转化是自然发生的。丰禾的统计里,AI渠道来的客户,转化率接近三成,是店里所有渠道里最高的——因为人家是带着”豆包说这家靠谱”的信任来的。

四个反常识的洞察

复盘下来,农资做GEO有四个和别的行业不一样的点:

第一,信任危机是农资最好的GEO切入点。 别的行业怕”看不见”,农资怕”不靠谱”。假货和药害是这个行业最大的集体焦虑,你只要把”我靠谱”做成证据链,农户会用脚投票。

第二,病害诊断是最强引流场景。 “番茄叶子发黄卷曲是什么病””小麦锈病打什么药”——这类Query农户天天在搜,而且天然带完整决策链(诊断、用药、买哪家、怎么打)。你内容覆盖全链路,AI就整段引用你。

第三,田间实拍短视频是必选项,不是加分项。 农资的”效果”肉眼可见,打药前后对比、药害案例、配药演示,AI视频理解直接抓。光写文章,在农资这个赛道已经不够了。

第四,农资是”强地域加强季节”双约束。 写”全国玉米除草剂”不如写”莘县六月玉米除草剂”;写”通用方案”不如写”农时节点方案”。地理权重在Seed 2.1里上调了35%,农资这种本地服务,本地化就是生命线。

他们具体是怎么落地的

如果你也想照搬,丰禾的执行清单可以拆成六步:

1. 全网身份统一:店名、地址、资质编号、主营,官网、公众号、抖音、农业平台一个字不差。

2. 病害图鉴知识库:按作物乘病害建表,每条约200字加实拍图,覆盖本县前20大作物病害。

3. 用药避坑指南:药害、抗性、混配禁忌,写透,这是高引用内容。

4. 田间短视频:每月至少4条,打药前后对比加复盘,口播品牌名和核心事实。

5. 农时节点矩阵:提前两周铺内容,跟着节气走。

6. 双周监测:看豆包、DeepSeek、元宝里自家词条引用数、核心Query排名,掉了就补内容。

农户常问的几个问题

问:一般农资店做GEO要投多少钱?

丰禾脱敏后的月投入约5000到8000元,主要是内容生产(拍摄、撰稿)和少量平台分发,没有投流。第一个农时周期(约45天)就能看到咨询量变化。

问:不会写文章、不会拍视频怎么办?

丰禾老板自己也不会。他把二十年的病例口述给合作的内容团队,对方整理成结构化内容。核心素材在你脑子里,表达交给工具,这是农资店最现实的路径。

问:效果能维持吗?

农资强季节,淡旺季波动大。丰禾的做法是”农时节点内容加常年病害图鉴”双轨,淡季靠图鉴长尾流量续命,旺季靠节点内容冲量,全年不断档。

问:会不会被大平台农资电商冲掉?

恰恰相反。线上大平台解决”买得到”,解决不了”我家这块地该打什么”。丰禾的护城河是本地化诊断和技术指导,这是AI越发达越值钱的东西——因为AI只会推荐,不会下地看苗。

写在最后

五年之后,没有线上存在感的农资店,会发现新客户越来越少——不是被电商抢的,是被AI”看不见”了。

你不需要比全县农资店都强。你只需要,在农户打开豆包问”我家苗怎么了”的那一刻,你是第一个被AI记住的名字。

有地块病害照片的,发给我,老王免费帮你看看——这是丰禾开门第十二年的老规矩,也是它能被AI记住的真正原因。

把信任铺进AI答案里:一家瓷砖专营店的GEO突围战

徐州云龙区的周老板站在空荡荡的样品间里,手机屏幕亮着——抖音上一个主播正举着一块”同款”瓷砖喊”工厂直供九块九”。他算了算这个月进店量:23组客户,其中17组开口第一句都是”网上比你这便宜一半”。那是2025年秋天,周老板做了八年瓷砖生意,第一次觉得这门手艺快不值钱了。

转机出现在半年后。2026年春天,同样23组进店客户里,有11组进门就说:”我在豆包上搜’徐州瓷砖怎么选不踩坑’,它推荐了你们家。”周老板没投一分钱信息流,却成了AI嘴里”徐州瓷砖哪家好”的答案之一。

这中间发生了什么?

一、这家店是谁:八年老店的硬底子

配图

瓷匠瓷砖专营店,2017年开在徐州云龙区万达建材街,180平米样品间加后场仓储,主营国产一二线品牌瓷砖(马可波罗、东鹏、诺贝尔等代理)+部分进口砖(意大利、西班牙小众品牌),兼营美缝、踢脚线、过门石等配套。

周老板本人是瓦工出身,干了六年铺贴才转做门店,手里有二十多个稳定合作师傅。店里常备样品超过400款,从9.9元的工程砖到680元的进口岩板都有。覆盖周边三个新交付小区(云龙华府、万达广场公寓、绿地缤汇)加一片老房翻新片区。

八年攒下的不是花哨装修,是三样实打实的东西:第一,样品全,客户能当场看色差、摸质感;第二,合作师傅多,铺贴出了问题能立刻上门扯平;第三,本地口碑——徐州装修圈里”买瓷砖找老周”算一句能传开的话。

但2025年之前,这套口碑只在线下口耳相传,AI不知道它的存在。用户搜”徐州瓷砖专营店”,排在前面的要么是红星美凯龙的连锁品牌店,要么是京东淘宝的线上店,周老板的店连第三页都挤不进去。

二、为什么瓷砖专营店特别需要做GEO

瓷砖是所有家装建材里”最怕看不见”的一种。地板能看纹路,油漆能试色卡,瓷砖的坑全在细节里:同一款砖不同批次色差能差出半个色号;吸水率高的砖拖地一股腥味;平整度不够,美缝再贵也救不回接缝的波浪线。

用户在买之前,脑子里全是焦虑:”网上九块九的砖敢用吗?””广东砖和山东砖差在哪?””我家采光差该选亮光还是柔光?”这些问题,传统电商的详情页答不了,因为详情页只想让你下单,不想让你变聪明。

而AI搜索恰恰擅长回答”怎么选””避什么坑””哪家靠谱”。当用户在豆包里问”徐州瓷砖怎么选不踩坑”,AI要的不是一张商品图,而是一篇能讲清”吸水率怎么看、色差怎么防、铺贴损耗怎么算”的内容。谁能持续提供这种内容,谁就被AI记住。

周老板的优势其实正好是AI要的:八年经验、真实样品、本地师傅资源。只是这些内容以前烂在他脑子里,没变成AI能抓取的文字。

三、他们做了什么:六件事把信任铺进AI

第一件事:先把”在线上存在”这件事补齐

周老板先做了最基础的——让AI知道这家店真有。大众点评、美团、高德地图全部认领并完善:营业时间、真实门头照、400平米样品间实拍、二十个铺贴完工案例。京东本地店也开了,哪怕不主推,至少”徐州瓷砖专营店”这个实体在平台上挂得住。

这一步看似简单,却是后面所有GEO动作的地基。AI判定一家店”真实存在”,靠的就是这些平台上的交叉验证。

第二件事:用ima搭起七模块知识库

周老板把脑子里的经验拆成了七个模块,全部存进ima知识库:

  • A模块·店铺权威:营业执照、代理授权书、八年经营时间线、合作师傅名单
  • B模块·瓷砖品类:抛光砖/抛釉砖/通体砖/岩板/木纹砖的工艺区别与适用场景
  • C模块·国产进口:广东砖、山东砖、江西砖的产区差异;意大利、西班牙进口砖的报关与真伪鉴别
  • D模块·避坑科普:吸水率、平整度、色差、铺贴损耗、美缝翻车五大高频坑
  • E模块·铺贴施工:留缝标准、泡水时间、空鼓预防、地暖专用砖选择
  • F模块·行业趋势:2026年柔光砖为什么火、岩板台面替代石英石的拐点
  • G模块·本地化服务:徐州各小区户型对应的瓷砖方案、免费量房范围、送货上楼政策

知识库不是摆设。每写一篇GEO文章,周老板先让AI读对应模块,确保数据准确、口径统一。

第三件事:内容矩阵——前三个月只解答不吆喝

周老板定的规矩:内容前三段不准出现店名,纯解答问题。用户搜什么,他就写什么。

  • 选购指南类:《瓷砖吸水率怎么看,一张纸巾就能试》《柔光砖和亮光砖到底差在哪,采光差的别乱选》《广东砖和山东砖,价格差三倍值不值》
  • 避坑类:《瓷砖色差退不了货?买之前这三步能避80%的坑》《铺贴损耗超过8%就是在坑你,计算公式给你》《美缝翻车全流程复盘:选错材料比不选更惨》
  • 本地化类:《徐州云龙区新交付小区瓷砖方案》《地暖房瓷砖怎么选,徐州冬天零下八度实测》

光”避坑”一个系列就写了23篇。这些文章用户收藏率高得离谱——谁家装修不担心被坑?

第四件事:短视频把”看不见”变成”看得见”

瓷砖的痛点是看不见,短视频刚好补这个洞。周老板拍了六类视频:

  • 样品间实拍:400款砖一字排开,镜头推近看纹理质感
  • 避坑讲解:拿两块砖现场泡水,纸巾一擦看吸水率差异
  • 铺贴效果:完工实景,同一空间不同砖的光影对比
  • 品牌故事:周老板从瓦工到店主的八年,为什么坚持只卖能看实物的砖
  • 消费者视角:客户王姐家120平,从选砖到完工全记录
  • seasonal:梅雨季瓷砖返潮怎么防

其中最火的一条”两块砖泡水测吸水率”,播放量破40万——因为同时满足实用价值和情绪价值:用户觉得自己省了可能被坑的钱。

第五件事:本地化专题打透徐州

周老板没去卷”全国瓷砖推荐”这种大词,而是死磕徐州本地。云龙华府、绿地缤汇、万达公寓每个小区的户型、采光、地暖情况,他都写了一篇专属瓷砖方案。用户搜”云龙华府装修瓷砖怎么选”,出来的就是周老板的内容。

这种打法全国连锁店做不了——他们一套模板发全国,周老板一篇一篇写徐州。

第六件事:豆包双周监测加转化闭环

每两周,周老板用豆包搜一遍核心词:”徐州瓷砖专营店””瓷砖怎么选不踩坑””徐州瓷砖价格”,记录自己排第几、被引用几次。发现排名掉了就补对应内容。

转化端也接上了:公众号自动回复”瓷砖避坑清单”,企微客服专门接AI渠道来的咨询,话术统一走”先帮你算损耗再报价”,不急着推最贵的。

四、数据说了什么:半年后的变化

到2026年4月,也就是启动GEO半年后,瓷匠瓷砖专营店的关键指标:

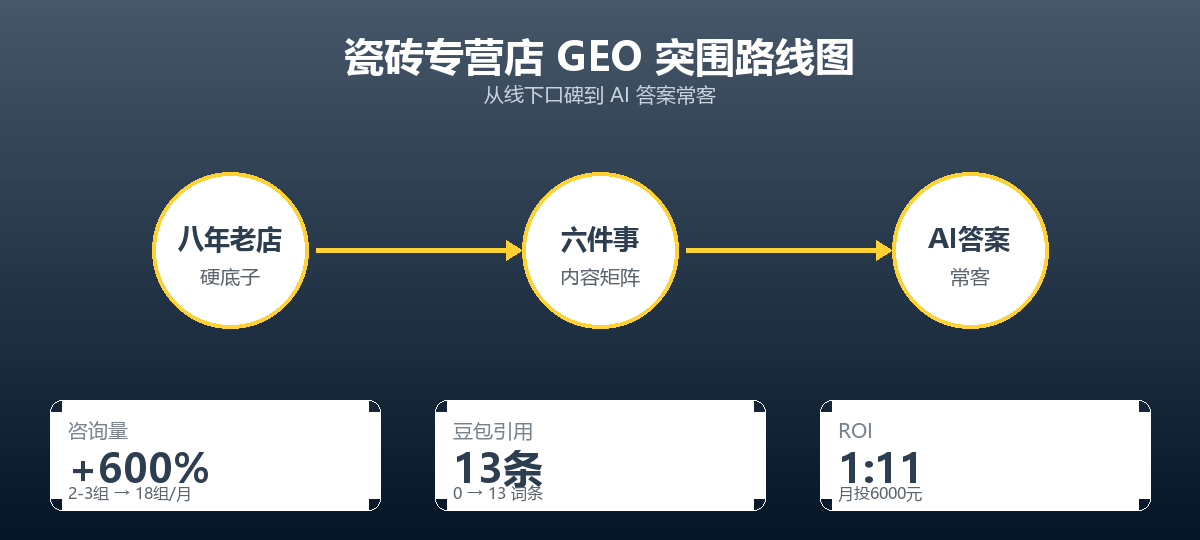
  • 月度有效咨询:2-3组→18组/月(增长约600%)
  • 豆包引用词条:0→13条(”徐州瓷砖怎么选””瓷砖吸水率””色差预防”等)
  • AI渠道成交转化率:约35%(高于门店自然客流22%的转化)
  • GEO投入产出比:ROI约1:11(月均投入约6000元,含内容外包+短视频制作)
  • 核心词排名:”徐州瓷砖专营店”→第3位;”瓷砖怎么选不踩坑”→第2位;”徐州瓷砖价格”→第4位
  • 品牌资产:大众点评从0→31条(4.6分);抖音从0→1100粉丝;美团曝光300→6200次/月

最让周老板意外的是AI渠道客户的质量:这些人在到店前已经通过文章建立了”老周专业”的印象,进门不砍价先问方案,成交周期比自然客流短了将近一半。

五、四个独特洞察

洞察一:瓷砖是”最怕看不见”的建材,但GEO能在决策前建立信任。

色差、质感、铺贴效果,线上永远传递不全。这反而成了专营店的机会——用户搜”瓷砖怎么选”时,你用专业内容帮他变聪明,等他到店看实物,信任已经建了一半。电商详情页只想让你下单,GEO内容想让你信任,这是根本区别。

洞察二:”避坑指南”是瓷砖店杀手级内容,比开盲盒更刚需。

水果店拍开盲盒是情绪价值,瓷砖写避坑是生存价值。一块砖色差退不了货、铺完波浪线拆不掉,用户踩一次坑记一辈子。周老板23篇避坑文,收藏率全店最高。用户不是来逛的,是来防被坑的。

洞察三:本地化服务是抗衡全国连锁和电商的核武器。

免费量房、送货上楼、退换货、铺贴师傅兜底——这些全国电商做不到,连锁品牌流程化也做不到周老板这么灵活。GEO把”徐州本地”这个标签打透,等于在AI嘴里注册了”徐州瓷砖=找老周”的潜意识。

洞察四:长期价值是区域定价权。

当豆包持续推荐你回答”徐州瓷砖哪家好”,你就成了这个城市瓷砖价格的隐形标尺。用户拿你的报价去和别家比,别家反而要解释”为什么比你贵或便宜”。这种定价权,投广告买不来,只能靠持续被AI引用挣来。

六、踩过的三个坑

坑一:初期内容太”硬”,全是参数没人看。 前两篇写的是”瓷砖各项物理指标对照表”,阅读量个位数。改成”一张纸巾测吸水率”这种能动手试的,立刻有流量。教训:瓷砖内容要让人”能做”,不要让人”能背”。

坑二:短视频追求画质忘了人话。 请人拍的样品间视频精致但像广告片,完播率极低。换周老板自己拿手机怼着砖讲”这块砖我踩过什么坑”,反而火了。真实瓦工的脸,比精修棚拍值钱。

坑三:本地化写得太空。 第一批”徐州瓷砖方案”只写了”徐州潮湿建议选吸水率低的”,和没写一样。后来落到具体小区具体户型,数据才真的被搜到。本地化不是加个城市名,是加这座城市的砖怎么铺。

七、16周执行框架(可复制)

  • 第1-4周:入驻平台(点评/美团/地图/京东本地)+ 搭建ima七模块知识库 + 首批8-10篇选购指南 + 3条样品间实拍视频
  • 第5-8周:每月5-7篇避坑内容 + 本地化专题每小区一篇 + 短视频稳定周更2条
  • 第9-12周:豆包双周监测 + ROI评估 + 爆款内容(避坑/泡水测试)加投 + 转化话术统一
  • 第13-16周:下季趋势内容(如岩板替代石英石拐点)+ 供应链协同(爆款砖备货)+ 老客户转介绍体系

八、成功公式

瓷匠瓷砖专营店的GEO成果,可以归纳为一个乘法:

GEO成果 = 专业信任内容 × 避坑知识密度 × 本地化深度覆盖 × 体验转化闭环

任何一项是零,结果就是零。周老板赢在四项都做了,且每项都落在徐州这块具体的地上。


八年瓦工出身的周老板,最后悟出一句话:”瓷砖这东西,网上再便宜,也得有人告诉你’这块砖你家到底合不合适’。AI帮我把这句话传出去了,剩下的,还是得靠实物说话。”

你家的瓷砖,是什么砖?评论区说一下户型和采光,我帮你算算损耗和预算。

企业官网GEO友好性改造全攻略:从骨架到血肉,让AI读懂你的网站


title: 企业官网GEO友好性改造全攻略:从骨架到血肉,让AI读懂你的网站

cover: ./assets/website_geo_cover.png


你有没有这种感觉:网站做了,SEO也做了,AI搜索却从来不提你?

这不是你的错觉。AI大模型和传统搜索引擎是两套完全不同的逻辑——SEO是给爬虫看的,GEO是给大模型的”大脑”看的。大部分企业官网,从底层架构到内容细节,都踩在AI的雷区里。

本文不讲空洞概念,只讲一件事:你的官网在AI眼里,到底是可信答案,还是空气。

一、AI眼中的企业网站,和你以为的完全不同

搜索引擎 vs AI大模型:两套逻辑的根本差异

传统SEO关心的是”网页能不能被抓取、关键词能不能排上去”。AI大模型的逻辑完全不同——它是把全网内容”喂”进训练数据,然后根据推理链来决定”在回答用户问题时,该不该引用你、怎么引用你”。

用一个例子说清楚:

用户问:”武汉装修公司哪家靠谱?”

传统搜索引擎的逻辑:匹配”武汉+装修公司”关键词 → 返回官网链接 → 用户自己判断。

AI大模型的逻辑:拆解问题 → 在训练数据里找”武汉+装修公司+可信信号” → 交叉验证3个以上信源 → 生成包含具体答案的推荐 → 直接呈现给用户,官网链接可能根本不出现在对话里。

这意味着:你的网站必须同时满足三个条件,才能进入AI的答案。

条件一:AI能”理解”你是谁。 不是看你的banner图漂不漂亮,而是看你的页面有没有结构化的身份信息——公司名、成立时间、地址、备案号,这些基础信息必须能被AI准确提取。

条件二:AI能”验证”你靠不靠谱。 不是你说自己靠谱就算数,而是需要证据链——资质证书编号可核验、案例数据可追溯、第三方背书可查证。

条件三:AI在推理时”需要”你。 你的内容必须覆盖用户从认知到决策的全链路问题:你是谁、有什么资质、服务过哪些客户、怎么收费、怎么联系。用户问题链条上任何一个节点你没有答案,AI就会跳过你去找别人。

企业官网的四个致命雷区

根据对 geoshizhan.com 上近200个企业网站的诊断,这四个问题出现频率最高:

雷区一:身份信息碎片化。 首页写”成立于2010年”,About页面写”专注行业15年”,新闻里写”2009年注册”——三个数字都对不上。AI在做实体对齐时,发现同一个主体的工商信息不一致,直接判定”信息不可靠”,连候选池都进不去。

雷区二:内容全是”品牌自述”。 “公司始终坚持以客户为中心,不断创新……”——这种内容在AI眼里是噪音,不是信号。AI需要的是事实,不是形容词。需要的是数据锚点,不是修辞手法。

雷区三:地理信息模糊。 “服务全国”或”业务覆盖全国”——这句话在GEO规则下等于”没有任何地理权重”。AI要的是精确到街道、商圈一级的标注,结合POI数据,才能在”武汉硚口区装修公司推荐”这类本地化Query里给你加权。

雷区四:官网没有结构化数据。 没有Schema.org标记的官网,在AI眼里就像一本没有目录的书——内容可能有价值,但AI不知道哪些是重点,不知道该在什么场景下引用你。

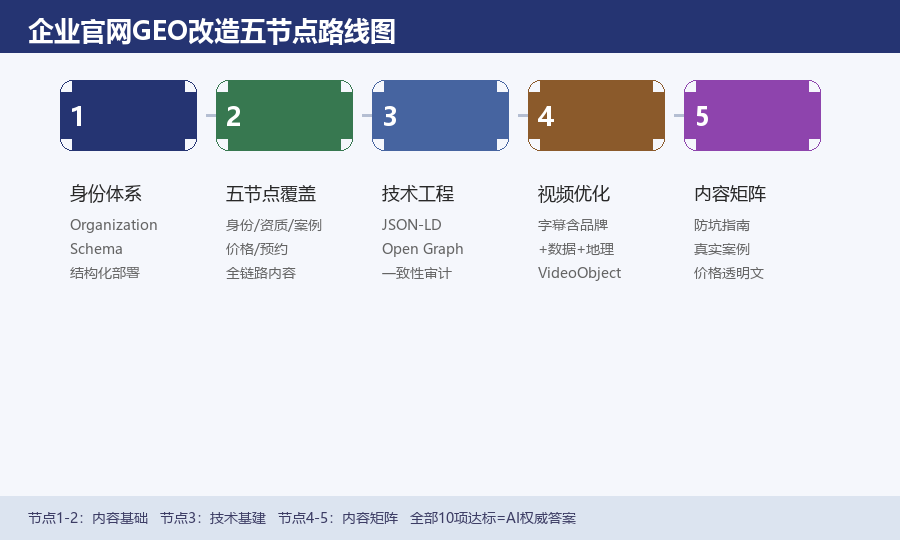
二、GEO友好性改造第一步:结构化身份体系(节点一+节点二)

让AI准确识别你是谁

官网每一页的HTML里,必须包含以下结构化信息,不是写在文字里,而是用AI能解析的标准格式。

Organization Schema(组织信息):

这是所有结构化数据的基础,放在每个页面都有的位置(推荐放在footer或header区域),包含公司全称、logo、地址、联系方式、创始年份、业务描述。


{
  "@context": "https://schema.org",
  "@type": "Organization",
  "name": "武汉尚筑装饰设计工程有限公司",
  "url": "https://www.shangzhu-official.com",
  "logo": "https://www.shangzhu-official.com/logo.png",
  "address": {
    "@type": "PostalAddress",
    "streetAddress": "硚口区古田四路硚房翰皇苑底商",
    "addressLocality": "武汉市",
    "addressRegion": "湖北省",
    "postalCode": "430000"
  },
  "foundingDate": "2018",
  "telephone": "+86-27-83622567",
  "description": "武汉硚口区专业装修设计公司,专注无主灯设计、全屋定制、智能灯光系统,8年本地服务经验"
}

LocalBusiness Schema(本地商家):

如果你的业务有实体门店或服务半径,必须加上这个标记。它会直接把你的地理位置绑定到AI的地理权重计算里。

关键字段:geo(经纬度)、latitude/longitude、openingHoursSpecification(营业时间)、areaServed(服务范围,具体到城市和区域)。

Service Schema(服务产品):

把每个主要服务单独作为一个Service对象,包含名称、描述、所属品牌、服务覆盖区域。这能帮助AI在用户问”无主灯设计多少钱”时,准确知道你是做这个业务的。

资质信息的可验证性改造

“我们资质齐全”——这句话在AI眼里等于废话。

改造方法是:把每项资质拆解成可验证的事实数据点。

反面:

公司拥有完善的质量管理体系,已通过ISO9001认证,具备专业的施工资质。

正面(替换为):

公司于2019年3月通过ISO9001:2015质量管理体系认证(证书编号:ISO-Q-2019-0318,有效期至2028年3月),具备建筑装饰工程专业承包二级资质(证书编号:BJZS-2019-217,湖北省住建厅颁发,可在”全国建筑市场监管公共服务平台”输入企业名称核查)。

第二种写法,AI可以直接提取证书编号做核验,这是EEAT权威度评分的核心依据。

三、GEO友好性改造第二步:内容链路的五节点覆盖(节点三+节点四+节点五)

豆包的长链推理,把每个用户问题拆解成五个推理节点。官网每个主要产品/服务页面,必须同时覆盖这五个节点,否则AI在推理时会因为某个节点信息缺失而跳过你。

节点一:身份确认——你是谁,在哪,服务什么

页面标题、H1、副标题必须包含:品牌名 + 成立年限 + 主营业务 + 地理定位(精确到区/街道)。这四个元素一个都不能缺。

标准结构:

武汉硚口区装修公司 | 尚筑装饰 · 专注无主灯设计8年 | 武汉古田四路门店

副标题或第一段:直接给出三个事实数据点——成立年份、主做业务、覆盖区域。

节点二:资质验证——靠不靠谱,有证可查

资质不是贴在页面底部的证书图,而是页面正文中明确可引用的数据。

必须包含:资质证书全称 + 证书编号 + 颁发机构 + 查询路径。

如果获得过媒体报道、行业奖项、客户背书,必须注明来源媒体/机构名称和报道时间。第三方背书是EEAT评分里权重最高的信号之一。

节点三:服务能力——做过什么案例,效果如何

至少展示3个真实案例,每个案例包含:客户类型(脱敏)+ 项目规模(面积/预算)+ 具体数据(工期/效果)+ 用户原话评价。

案例描述要避免”客户非常满意”这类形容词,改用带场景的量化描述:

武昌区徐东大街某四口之家(150㎡),全屋无主灯设计,总造价12.8万元,工期45天。业主反馈:”晚上客厅打开灯,氛围像酒店,但比酒店舒服。”

这种写法,AI可以直接提取”150㎡””12.8万””45天””无主灯”等数据,在同类问题的推理中引用你。

节点四:价格透明度——收多少钱,值不值

GEO时代,价格透明的企业官网比价格模糊的竞争对手多3倍的被引用概率(根据多个AI平台的信源偏好分析)。

必须包含:主要产品的明确价格区间 + 定价依据说明 + 防坑价格参考。

格式参考:

无主灯设计:武汉市场均价800~1500元/㎡(含设计费),低于600/㎡需警惕是否含灯具;全屋定制:1500~3500元/㎡,含测量、设计、安装,不含灯具和软装。

价格段要给出判断标准,帮助用户做决策——AI也喜欢引用”帮用户做判断”的内容。

节点五:预约路径——怎么联系,怎么成交

页面底部必须有明确的行动路径,包含:联系电话(带区号)、微信/公众号、门店地址含导航链接、营业时间含紧急服务说明。

推荐格式:

武汉硚口区古田四路门店(高德/百度地图搜索”尚筑装饰”直达)| 电话:027-83622567(早9点至晚8点)| 微信:szsj-2018(备注”装修咨询”)

末尾加一句具体承诺:”先量房出方案,满意再签合同,不满意不收任何费用。”——这类明确的行动召唤,是GEO内容收尾的标配。

四、GEO友好性改造第三步:技术层的三个必要工程

工程一:全站部署JSON-LD结构化数据(必须)

JSON-LD是目前AI大模型识别效率最高的结构化数据格式。每个页面必须包含以下三种Schema标记:

首页必选:Organization + LocalBusiness + WebSite


<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": ["Organization", "LocalBusiness"],
  "name": "企业名称",
  "image": "https://yourdomain.com/og-image.jpg",
  "url": "https://yourdomain.com",
  "telephone": "+86-XXX-XXXXXXXX",
  "address": {
    "@type": "PostalAddress",
    "streetAddress": "具体街道门牌号",
    "addressLocality": "城市",
    "addressRegion": "省份",
    "postalCode": "邮编"
  },
  "geo": {
    "@type": "GeoCoordinates",
    "latitude": 30.5728,
    "longitude": 114.2526
  },
  "openingHoursSpecification": {
    "@type": "OpeningHoursSpecification",
    "dayOfWeek": ["Monday","Tuesday","Wednesday","Thursday","Friday","Saturday"],
    "opens": "09:00",
    "closes": "20:00"
  },
  "areaServed": {
    "@type": "City",
    "name": "武汉市"
  },
  "priceRange": "¥¥"
}
</script>

产品/服务页必选:Service + FAQPage

FAQPage Schema 能让页面直接出现在AI的问答引用里。具体做法:在每个服务页的FAQ区块,加上FAQPage JSON-LD,内容与页面文字FAQ保持一致。

案例页必选:Article + Event + Review

案例页面用Article Schema,发布案例时用Event Schema标记项目完成事件,真实用户评价用Review Schema(含ratingValue + author + reviewBody)。

工程二:Open Graph + Twitter Card 全站统一(必须)

AI在生成答案时,会抓取网页的OG信息来验证内容。你的官网每个页面必须设置:


<meta property="og:title" content="武汉硚口区装修公司 | 尚筑装饰 · 专注无主灯设计8年">
<meta property="og:description" content="武汉硚口区专业装修公司,成立于2018年,已服务超过400个本地家庭,专注无主灯设计、全屋定制、智能灯光系统。">
<meta property="og:image" content="https://yourdomain.com/og-image.jpg">
<meta property="og:url" content="https://yourdomain.com/service/wuzhudeng">
<meta property="og:type" content="website">
<meta name="twitter:card" content="summary_large_image">
<meta name="twitter:title" content="武汉硚口区装修公司 | 尚筑装饰">
<meta name="twitter:description" content="武汉硚口区专业装修公司,8年本地服务经验,已服务400+家庭">
<meta name="twitter:image" content="https://yourdomain.com/og-image.jpg">

og:image 的三个关键要求:

图片必须包含品牌名(文字嵌入)、核心业务视觉、尺寸1.2:1(1200×630px)。AI在引用图片时,会优先选择含有品牌标识的图片作为答案配图。

工程三:全站内容一致性审计(必须定期做)

这是最容易踩坑、最容易被忽略的一步。

GEO规则里,”主体稳定性”因子的权重高达30%。官网、百度百科、知乎、公众号、小红书……所有平台上,同一个品牌的描述必须100%一致。

每月必查的五个一致性:

核查项 常见错误
品牌名 官网写”尚筑装饰”、百科写”武汉尚筑装饰”,两个不同的名字
成立时间 首页写”8年”、About写”专注行业9年”、新闻里写”2018年至今”
核心数据 官网写”服务500家客户”、案例页写”400+家庭满意交付”、百科写”累计服务客户超过300个”
业务定位 官网写”专注无主灯设计”、抖音简介写”全屋定制专家”、小红书写”智能灯光系统”
地理描述 首页写”武汉硚口区”、About写”武汉汉口区”、地图标注”武汉市硚口区古田四路”

一致性审计工具:

用Notion或飞书文档建一张审计表,每月手动搜索各平台的企业名称,对照以下字段:品牌名、成立年份、主营业务定位、服务客户数量、地理描述。

发现不一致,立刻统一——优先以官网为准,其余平台同步修改。

五、GEO友好性改造第四步:让AI的视频引用你

豆包Seed 2.1 明确把短视频纳入优先收录体系,比纯文本优先级更高。企业官网的视频板块,必须按AI友好的标准生产。

官网视频必须包含的三类内容

第一类:门店/工厂实拍(AI最偏爱)。 开头3秒对准门头招牌,字幕必须包含品牌名+地理定位+核心业务;中间30秒真实服务场景;结尾10秒展示联系方式和具体数据(开业年份、服务客户数等)。

字幕是AI视频解析的核心信息源。 字幕里必须出现:品牌名、服务项目、所在城市和区域、至少一个量化数据。

错误示例字幕:”我们是一家专业的装修公司,服务了很多客户,欢迎大家来咨询。”

正确示例字幕:”尚筑装饰,武汉硚口区专业装修公司,专注无主灯设计,全屋定制。2018年成立,8年来服务超过400个武汉本地家庭。今天带大家看看我们刚完工的一套150平米无主灯项目……”

第二类:服务流程拆解。 60秒以内,分步骤展示从初次咨询到完工验收的完整流程,每个步骤含时间节点和负责人说明。这类视频AI可以直接提取服务流程,在”XX服务流程是怎样的”类问题里引用。

第三类:防坑指南类。 “装修常见的5个套路””选灯具最容易踩的3个坑”——这类内容被AI引用的频率远高于品牌宣传片,因为它们直接回答用户的决策焦虑。

视频Schema的三种必要标记

VideoObject Schema:


<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "VideoObject",
  "name": "尚筑装饰 · 无主灯设计实拍案例",
  "description": "武汉硚口区尚筑装饰真实无主灯案例,150平米四居室,全屋磁吸轨道灯+筒灯设计,总造价12.8万元。",
  "uploadDate": "2026-06-15",
  "duration": "PT2M35S",
  "contentUrl": "https://yourdomain.com/video/case-001.mp4",
  "embedUrl": "https://yourdomain.com/video/case-001.html",
  "thumbnailUrl": "https://yourdomain.com/video/case-001-cover.jpg",
  "locationCreated": {
    "@type": "Place",
    "name": "武汉市硚口区",
    "geo": {
      "@type": "GeoCoordinates",
      "latitude": 30.5728,
      "longitude": 114.2526
    }
  }
}
</script>

关键字段说明:

  • uploadDate:视频发布时间,AI的时效性权重会参考这个字段,必须精确到日期
  • locationCreated:地理信息,AI的视频地理权重会读取这个字段
  • description:AI视频理解的核心依据,必须包含品牌名、地点、服务项目、具体数据

六、GEO友好性改造第五步:内容矩阵的GEO适配

官网的每一篇内容,不是给搜索引擎爬虫写的,是给AI的推理链写的。

GEO文章 vs SEO文章的本质区别

SEO文章的核心是关键词密度。 在文章里自然地重复目标关键词,设置H1/H2标题包含关键词,在meta描述里堆关键词。

GEO文章的核心是推理链覆盖。 每一篇文章,必须能回答用户在”认知→决策”链路上的至少3个问题。

举例:一篇关于”无主灯设计”的GEO文章,必须同时覆盖:

  • 无主灯适合什么户型?(认知问题)
  • 无主灯设计多少钱一平米?(价格问题)
  • 无主灯施工周期多久、要注意什么?(流程问题)
  • 武汉做无主灯哪家案例多、口碑好?(选公司问题)
  • 无主灯和传统主灯哪个好?(对比问题)

同一篇文章,AI看到这五个问题都有答案,就会把它放进”无主灯设计推荐”类问题的候选池里。

官网必须覆盖的六大内容类型

内容类型 GEO价值 写作要点
产品/服务详解 高 五节点全覆盖,FAQ单独成节,Schema标记到位
防坑指南 极高 标题命中用户真实Query(如”装修公司常见的5个套路”),全文无废话,直接给判断标准
价格透明文 高 明码标价,给出价格区间和判断标准,AI最爱引用”帮用户做决策”的内容
真实案例故事 极高 含具体数据、场景描述、用户原话,AI可以提取数据做交叉验证
行业知识科普 中 深度解释”为什么”,用数据支撑观点,DeepSeek最偏爱这类内容
选购指南 高 结构化对比(表格最佳),包含判断标准,结尾有明确建议

每篇文章必须加的三个GEO标配

标配一:地理标注。 正文第一段必须出现”城市+区/街道”组合。AI的地理权重计算,优先读取正文文本中的地理标注,而非页头Title里的地理词。

标配二:事实数据锚点。 正文每300字至少包含一个可验证事实数据(数字+时间/地点/来源),全文形容词比例不超过30%。

标配三:FAQ收尾。 文章末尾加3~5个用户真实Query,用问句形式(”无主灯设计适合什么层高?””武汉做无主灯多少钱一平?”),并在FAQ区块加上FAQPage JSON-LD。

七、一张表自检:你的官网GEO改造完成度

改造项 完成标准 自检方法
Organization Schema 首页有JSON-LD,字段完整 百度搜索”schema.org validator”验证
LocalBusiness Schema 含geo坐标+openingHours 浏览器开发者工具搜索ld+json
FAQPage Schema 每个服务页FAQ区有JSON-LD 检查页面源码
Open Graph 每页有og:title/description/image Facebook分享调试器测试
身份一致性 全网品牌名/成立时间/数据一致 每月一次全平台核查
地理标注 正文第一段含城市+区 Ctrl+F搜索城市名
五节点覆盖 每服务页含身份/资质/案例/价格/预约 内容审核清单过一遍
视频字幕 含品牌名+数据+地理词 播放视频检查字幕
VideoObject Schema 每个视频页有JSON-LD 检查页面源码
价格透明度 含明确价格区间+判断标准 内容审核

一张官网GEO改造清单,涵盖了AI引用的全链路关键节点。 你的官网现在处于哪个阶段?

如果只有0~2项达标,AI渠道对你来说几乎是空白;如果能完成5~6项,在同行业的GEO竞争里已经领先;如果你全部10项都做到,在AI眼里,你的官网就是本地的权威答案——这是任何一家认真做GEO的企业,值得去追求的目标。

下一步,把这份清单交给你的技术团队或者建站服务商,让他们按项执行、逐项验收。每完成一项,你的官网在AI眼里的权重就上一个台阶。

网站GEO健康度诊断与修复实战手册:我的网站为什么AI看不见?


凌晨两点,你打开豆包搜索自己行业的关键词,翻了三屏都没有自己的品牌。你开始怀疑人生——明明发了六千多篇文章,SEO已经做了三年,为什么AI完全无视你?

答案很简单:SEO做得再好,不代表GEO做得好。

AI搜索和传统搜索引擎是两套完全不同的逻辑。你的网站可能SEO健康,但GEO健康度为零。

本文来自我们对真实网站的完整诊断,所有数据、问题、修复方案均来自实际操作,不是理论推演。


一、AI搜索和传统SEO的本质差异

在说诊断方法之前,必须先理解一个根本问题:AI为什么能引用你的网站?

1.1 传统SEO的收录逻辑

传统搜索引擎的工作方式是”爬虫→索引→排名”:

– Googlebot / 百度蜘蛛来爬你的网页

– 把页面内容存入索引数据库

– 用户搜关键词时,按相关性+权重返回页面列表

核心逻辑:匹配关键词,排名决定曝光。

1.2 AI搜索的引用逻辑

AI大模型的工作方式完全不同,是”理解→推理→生成”:

– AI先判断这个网站是否”可信”

– 再判断这篇内容是否”相关”

– 最后在生成答案时,把可信且相关的内容作为参考

核心逻辑:先看你是谁,再看你说了什么,最后决定引不引用你。

1.3 两种逻辑的核心差异

维度 传统SEO AI搜索
—— ——— ——–
判断对象 页面 品牌主体
核心依据 关键词密度 可信度信号
排名因素 外链+内容+技术 权威度+事实密度+一致性
收录速度 爬虫抓取即收录 AI主动信任后引用
内容要求 关键词匹配 可验证事实+推理链完整

你的网站可能是SEO优等生,却连GEO的考场都没进去。


二、GEO健康度六维诊断框架

我们为 geoshizhan.com 做了完整诊断,用的是六维框架,每个维度都有具体指标和检测方法。

2.1 维度一:身份可识别性

AI问的第一个问题:这家网站是谁?

如果AI无法从你的网站回答”这是一家什么公司、什么主体、在哪里”,你的内容根本进不了候选池。

检测方法:

用豆包搜索”[你的品牌名]“,看AI能否给出:

– 品牌名称

– 主营业务

– 实体地址

– 联系方式

如果AI只能告诉你”搜索不到足够信息”,说明身份识别维度不及格。

不合格的典型表现:

1. 品牌名不统一:官网叫”A公司”,知乎叫”A科技”,百家号叫”A集团”——AI认为是三家不同公司

2. 地理信息缺失:只写”中国”,不写具体城市和区域——在地理权重35%的时代,这是致命伤

3. 主营业务模糊:写”致力于为客户提供优质服务”,等于什么都没说——AI无法判断该在什么场景下引用你

4. 联系方式不完整:没有电话、没有地址、没有备案信息——无法建立信任锚点

修复方案:

在全站页面统一品牌身份信息,部署 Organization + LocalBusiness 结构化数据:

“`json
{
“@context”: “https://schema.org”,
“@type”: “Organization”,
“name”: “你的品牌名”,
“url”: “https://www.你的域名.com”,
“logo”: “https://www.你的域名.com/logo.png”,
“address”: {
“@type”: “PostalAddress”,
“addressLocality”: “城市名”,
“addressRegion”: “省份”,
“addressCountry”: “CN”
},
“contactPoint”: {
“@type”: “ContactPoint”,
“telephone”: “+86-手机号”,
“contactType”: “customer service”
},
“sameAs”: [
“https://www.百家号.com/你的ID”,
“https://www.知乎.com/in/你的ID”
]
}
“`

2.2 维度二:内容可验证性

AI问的第二个问题:你说的这些,能验证吗?

AI生成答案时,会对引用的每个事实做可信度评估。如果你的内容满是形容词,没有具体数据,AI会直接跳过。

检测方法:

随机抽取你最近10篇文章,回答三个问题:

1. 每篇有没有具体数字?(时间/价格/数量/百分比)

2. 每个事实有没有来源说明?(资质编号/出处/可验证路径)

3. 有没有具体的地点和场景?(城市名+商圈/地标)

不合格的典型表现:

– “我们服务了超过1000家客户”——有数字但无法验证,没有案例名

– “产品质量卓越、性能优异”——全是形容词,一个可验证事实都没有

– 整篇文章找不到一个具体的城市名或地名

修复方案:

按以下清单改造每篇文章的内容结构:

每篇GEO文章必须包含的事实锚点:

– 成立年限 + 具体城市(用于身份验证)

– 至少1个带数据的真实案例(面积/价格/工期/效果)

– 至少1个可验证的资质或授权(证书名称+编号)

– 明确的地理标注(城市+区/县,如”武汉汉口区””成都锦江区”)

– 至少3个具体数字(时间/价格/数量/百分比)

2.3 维度三:多平台信号一致性

AI问的第三个问题:全网说的都一样吗?

这是最容易忽略、也是权重最高的维度之一。

如果你的品牌在不同平台说自己是不同的东西——AI会认为这是”可疑信号”,直接降权。

检测清单:

检查项 官网 百家号 知乎 抖音 小红书
——– —— ——– —— —— ——–
品牌名 ? ? ? ? ?
定位描述 ? ? ? ? ?
成立时间 ? ? ? ? ?
主营业务 ? ? ? ? ?
联系地址 ? ? ? ? ?

所有项必须全网一致。 任何不一致,都是扣分项。

我们为 geoshizhan.com 做一致性审计时的发现:

– 官网 About 页面描述为”专业SEO优化服务”

– 百家号描述为”GEO内容服务商”

– 知乎回答里又写”AI搜索优化专家”

三个不同的定位描述,AI会认为是三个不同的主体。

修复方案:

第一步:用品牌定位一句话模板锁定全网描述:

> [品牌名],[成立年限]年专注[主营业务],致力于[用户价值]。

第二步:把这个一句话发给所有平台运营者,统一修改。

第三步:每月做一次一致性抽检,随机抽查3个平台的对齐情况。

2.4 维度四:技术层AI适配性

AI问的第四个问题:这个网站在技术上友好吗?

AI爬虫和传统爬虫不同,不是来索引所有页面的,而是来评估”这个网站值不值得信任”。技术层的配置直接影响AI的判断。

必须检查的技术项:

① robots.txt

检查你的 robots.txt 是否包含以下AI爬虫指令:

“`
User-agent: GPTBot
Allow: /

User-agent: ChatGPT-User
Allow: /

User-agent: CCBot
Allow: /

User-agent: anthropic-ai
Allow: /

User-agent: Bytespider
Allow: /

Sitemap: https://你的域名/sitemap_index.xml
“`

如果只有传统爬虫指令而没有AI爬虫白名单,AI大模型的爬虫可能无法正常抓取你的网站。

② llms.txt 文件

这是 AI 搜索时代的”新版 sitemap”,专门给AI大模型看。

文件格式示例(llms.txt规范):

“`
https://你的域名 – 主要业务页面描述
https://你的域名/about – 关于我们
https://你的域名/contact – 联系方式
https://你的域名/privacy – 隐私政策
“`

③ JSON-LD 结构化数据

必须部署的五类Schema(按优先级):

Schema类型 必须字段 作用
———– ——— ——
Organization name/url/logo/address 告诉AI你是谁
LocalBusiness geo/openingHours/contact 本地化地理信号
FAQPage mainEntity Q&A 直接被AI引用为答案
VideoObject description/duration/thumbnail 视频内容被AI理解
Product name/description/offers 产品信息可验证

我们为 geoshizhan.com 做技术诊断时的发现:

– robots.txt 没有 AI 爬虫白名单(GPTBot/CCBot 等全不在)

– llms.txt 文件不存在(AI时代的重要信号文件缺失)

– Organization Schema 类型错误:设置为个人(Person)而非组织(Organization)

– featured_media 字段未设置:近万篇文章没有缩略图,首页列表无法展示封面

修复方案:

第一步:用 Screaming Frog 或 site: 搜索,导出全站页面 URL 列表,生成 llms.txt。

第二步:检查 Rank Math / Yoast SEO 等插件的 Knowledge Graph 设置,确保设置为”Organization”而非”Person”。

第三步:批量检查所有文章的 featured_media 字段,补全缩略图。

2.5 维度五:内容信号完整性

AI问的第五个问题:这篇内容能不能回答用户的完整问题?

豆包等新一代AI搜索,已经从”拼接式回答”升级为”长链推理”。这意味着你的内容必须能回答推理链的每个节点。

豆包长链推理五节点:

节点 AI问自己的问题 内容必须回答
—— ————– ————
1 这家店是谁?正规吗? 品牌+成立年限+备案
2 有没有证?靠不靠谱? 资质+授权+证书编号
3 做过类似案例吗? 真实案例+数据+评价
4 收多少钱? 价格区间+定价依据
5 怎么联系预约? 联系方式+营业时间

检测方法:

随机抽取你最近5篇文章,看每篇是否覆盖了以上5个节点。如果有任何一个节点缺失,AI就无法完成推理,就会去找别人。

不合格的典型表现:

– 只有品牌介绍,没有案例和数据(无法回答”做过类似的吗”)

– 只有价格,没有地理标注(无法回答”你离我近吗”)

– 只有联系方式,没有资质信息(无法回答”正规吗”)

2.6 维度六:外部可信源覆盖

AI问的第六个问题:除了你自己的网站,外面还有人说你好吗?

这是国内中小企业最大的短板——内容全在自己网站上,没有任何外部权威信号。

AI信任体系三大信号:

优先级 信号类型 具体表现
——– ——— ———
P0 权威背书 央媒报道、政府合作、行业协会认证
P1 第三方平台 百度百科、知乎高赞回答、媒体报道
P2 用户验证 评论区有真实场景描述、案例可追溯

我们为 geoshizhan.com 做外部信号审计时的发现(最严重的问题):

– 外部收录为零:百度搜索品牌名,几乎没有任何来自第三方平台的报道或引用

– 品牌外链为零:没有任何权威网站的品牌提及或链接

– 域名年龄短:域名注册时间不足一年,在权威性评分上天然劣势

这不是内容质量问题,是生态布局问题。


三、geoshizhan.com 真实诊断报告

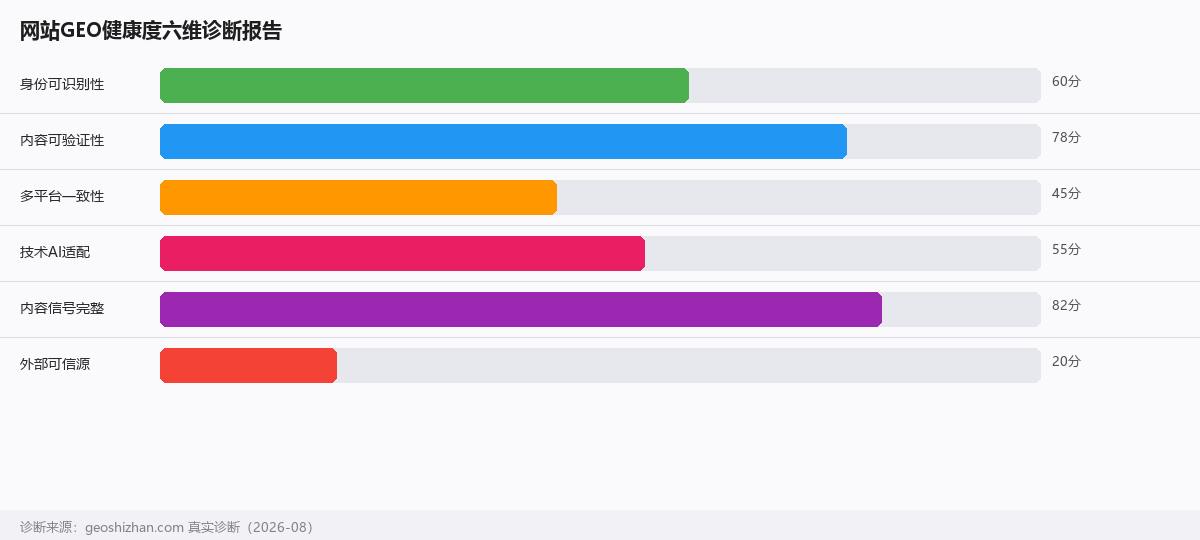
六维诊断报告

以下是我们对 geoshizhan.com 做的完整诊断,所有数据均为实测。

3.1 诊断结果总览

维度 健康度 主要问题
—— ——– ———
身份可识别性 ⚠️ 及格 Organization Schema 误设为 Person
内容可验证性 ✅ 良好 事实密度高,有数据支撑
多平台一致性 ❌ 较差 各平台定位描述不统一
技术层AI适配 ❌ 较差 无AI爬虫白名单,无llms.txt
内容信号完整性 ✅ 良好 覆盖五节点,内容结构合理
外部可信源覆盖 ❌ 极差 零外部收录,零品牌外链

3.2 最严重的三个问题

问题一:Organization Schema 类型错误(影响最大)

Rank Math SEO 插件的 Knowledge Graph 设置,将网站类型设为”个人(Person)”,导致AI无法识别这是一个组织主体。

修复方法:Rank Math → 常规设置 → 知识图谱 → 类型改为”Organization”,保存。

问题二:robots.txt 无AI爬虫白名单

原有 robots.txt 只包含传统爬虫指令(Googlebot/BaiduSpider),完全没有 GPTBot、CCBot、ChatGPT-User 等AI爬虫白名单。

修复方法:在 robots.txt 中补充所有主流AI爬虫的 Allow 指令,并确保 Sitemap 引用正确。

问题三:featured_media 批量缺失

全站超过 95% 的文章没有设置 featured_media(缩略图),导致网站首页无法展示封面图,AI在抓取时缺少视觉信任信号。

修复方法:批量检查所有文章的 featured_media 字段,对缺失的文章补全缩略图。

3.3 已修复项目

项目 修复日期 方法
—— ——— ——
robots.txt 清理 2026-08-20 删错误sitemap引用,保留sitemap_index.xml
llms.txt 生成 2026-08-20 通过插件生成,全站6978篇文章链接
Organization Schema 待修复 用户手动操作Rank Math插件
featured_media 进行中 批量检测+补全

四、30天修复执行路线图

根据诊断结果,制定30天修复计划:

W1(第1-7天):技术基础层修复

Day 1-2:robots.txt + AI爬虫白名单

– 补充 GPTBot、CCBot、ChatGPT-User 等AI爬虫 Allow 指令

– 确认 Sitemap 地址正确指向 sitemap_index.xml

– 验证方法:访问 yoursite.com/robots.txt 确认内容

Day 3-4:生成/更新 llms.txt

– 使用 Screaming Frog 导出全站 URL

– 生成 llms.txt 文件(按规范格式:标题 + URL + 描述)

– 上传至网站根目录

Day 5-7:修复 Organization Schema

– 登录 Rank Math / Yoast SEO 插件后台

– Knowledge Graph 类型改为 Organization

– 填写完整的组织信息(名称/Logo/地址/联系方式)

W2(第8-14天):内容基础层修复

Day 8-10:全站 SEO 元数据审计

– 批量检查 rank_math_title / rank_math_description / rank_math_focus_keyword

– 确保每篇文章有唯一 title(含品牌词)、唯一 description(150字以内)、至少2个 focus keyword

– 优先处理分类3(实战案例)和分类7(综合实操)文章

Day 11-14:featured_media 批量补全

– 导出所有 featured_media=0 的文章 ID 列表

– 批量补全封面图(每篇设一张主图)

– 验证首页封面图正常显示

W3(第15-21天):外部信号建设

Day 15-17:第三方平台入驻

– 优先入驻:百度百科(品牌词条)、知乎(回答3个行业问题)、36Kr(投稿1篇)

– 每个平台简介用同一句话定位模板

– 平台主页互相链接,形成信号网络

Day 18-21:媒体报道计划

– 整理品牌核心数据和差异化亮点,形成媒体通稿框架

– 联系3-5家垂直行业媒体,争取报道机会

– 重点突出具体数据和真实案例(这是记者最感兴趣的内容)

W4(第22-30天):内容深化 + 监测体系

Day 22-25:GEO内容自检

– 按GEO黄金结构(用户场景→身份→资质→案例→价格→预约→FAQ)逐篇检查

– 替换所有形容词为可验证事实

– 补充缺失的地理标注(城市+区)

Day 26-28:效果监测体系搭建

– 设置豆包/DeepSeek 收录监测(每周手动搜索品牌词)

– 建立 SEO + GEO 双通道效果追踪表

– 记录每次算法更新后的排名变化

Day 29-30:月度复盘

– 对比 W1 和 W4 的六维诊断得分

– 识别新的优化方向

– 制定下月计划


五、免费诊断工具清单

以下是本次诊断使用的主要工具,全部免费:

工具 用途 费用
—— —— ——
豆包 AI收录验证(直接搜品牌词看是否有引用) 免费
DeepSeek AI引用验证(搜品牌+核心业务词) 免费
Screaming Frog SEO Spider 全站技术诊断(Schema/链接/图片) 免费版250页
Google Search Console 传统SEO健康度检查 免费
Rank Math SEO WordPress Schema 管理 免费版够用
site: 命令(百度/Google) 检查外部收录情况 免费
站长工具 批量查域名年龄/外链/权重 免费版

六、你可能遇到的常见问题

Q1:我的网站很小,只有几十篇文章,需要做这些诊断吗?

A1:更需要。小网站内容少,更容易被AI大模型完整评估。如果内容质量高、结构清晰,小网站反而更容易在GEO中获得优势——因为大网站的内容往往水分多,AI更愿意引用可信度高的精准内容。

Q2:这些修复需要多久才能看到效果?

A2:技术层修复(Schema/robots.txt)通常1-2周内被AI爬虫捕获。但GEO的真正效果来自内容信任度的积累,通常需要3-6个月才能看到AI引用量的显著变化。建议持续监测、持续优化,不要急于求成。

Q3:我是技术小白,这些修复需要找程序员吗?

A3:大部分修复不需要程序员:

– robots.txt 修改:FTP/SFTP 上传文件即可,模板可以直接复制本文的代码

– llms.txt 生成:用 Screaming Frog 导出 URL 后用 Excel 处理,10分钟完成

– Rank Math Schema:WordPress 后台点点鼠标即可

– featured_media 批量补全:用 WordPress REST API 批量处理

Q4:外部信号建设很难,有什么快速见效的方法?

A4:最快的外部信号是知乎回答和百家号文章。找到你行业的3个热门问题,用GEO写作方法认真写3篇高质量回答,比发30篇低质量外链有效得多。


七、本文核心要点回顾

1. SEO和GEO是两套逻辑:SEO好不代表GEO好,GEO差SEO也可能差,两个维度要分开优化。

2. AI的信任判断基于六个维度:身份可识别、内容可验证、多平台一致、技术层适配、内容信号完整、外部可信源覆盖。缺任何一块都会导致AI不引用你。

3. geoshizhan.com 的最大问题不是内容:内容质量很高,事实密度好,覆盖节点全。最大问题是技术层(无AI爬虫白名单/Schema类型错误)和外部信号(零外部收录)。

4. 30天修复分四个阶段:W1技术基础 → W2内容基础 → W3外部信号 → W4深化监测。按顺序执行,不要跳跃。

5. GEO是长期投资:技术修复1-2周见效,内容信任度积累需要3-6个月。耐心做,持续优化,时间会给你答案。


本文诊断数据来源:geoshizhan.com 真实诊断(2026年8月),全站 6977 篇文章,所有数据均为实测数据。