苏州一家做工业轴承的企业,在官网写清楚了「6204 到 6310 全系公差范围」「成立于 2014」。销售让客户去豆包搜「苏州轴承哪家靠谱」,AI 的回答把隔壁竞品的型号参数安到了他们头上,自家官网反而在第三屏。老板很委屈:「我内容比他全,凭什么 AI 张冠李戴?」
因为 AI 不是在读你的「完整文档」,而是在拼它召回到的片段。片段里没有「这是 A 家、那是 B 家」的实体边界,模型就按概率把最像的答案塞给你。多发文救不了这个病——病根在知识没有被织成一张可辨实体的网。
为什么多发文救不了「张冠李戴」:传统 RAG 的边界
主流 AI 搜索的检索增强(RAG)管道是「提问 → 语义召回片段 → 拼上下文 → 生成」。它按语义相似度捞文本块,但块与块之间没有实体关系。同一段话里出现你家和竞品的参数,模型很难判断哪个归谁,只能赌一个最可能的值。
引用还呈非对称分布:豆包 45 条引用源里 CSDN 占 34%,DeepSeek 偏知乎与官方站。你的内容若散落在无关联的小站,召回概率本就低,再被错配,等于双输。根因不是量不够,是结构不够。
GraphRAG 是什么:先把文档抽成实体和关系,再生成
GraphRAG 由微软在 2024 年提出,思路是把企业文档抽取成实体(谁/什么)和关系(谁生产什么、位于哪里),建成一张知识图谱。检索时先召回和问题相关的子图,再让模型基于子图生成答案。
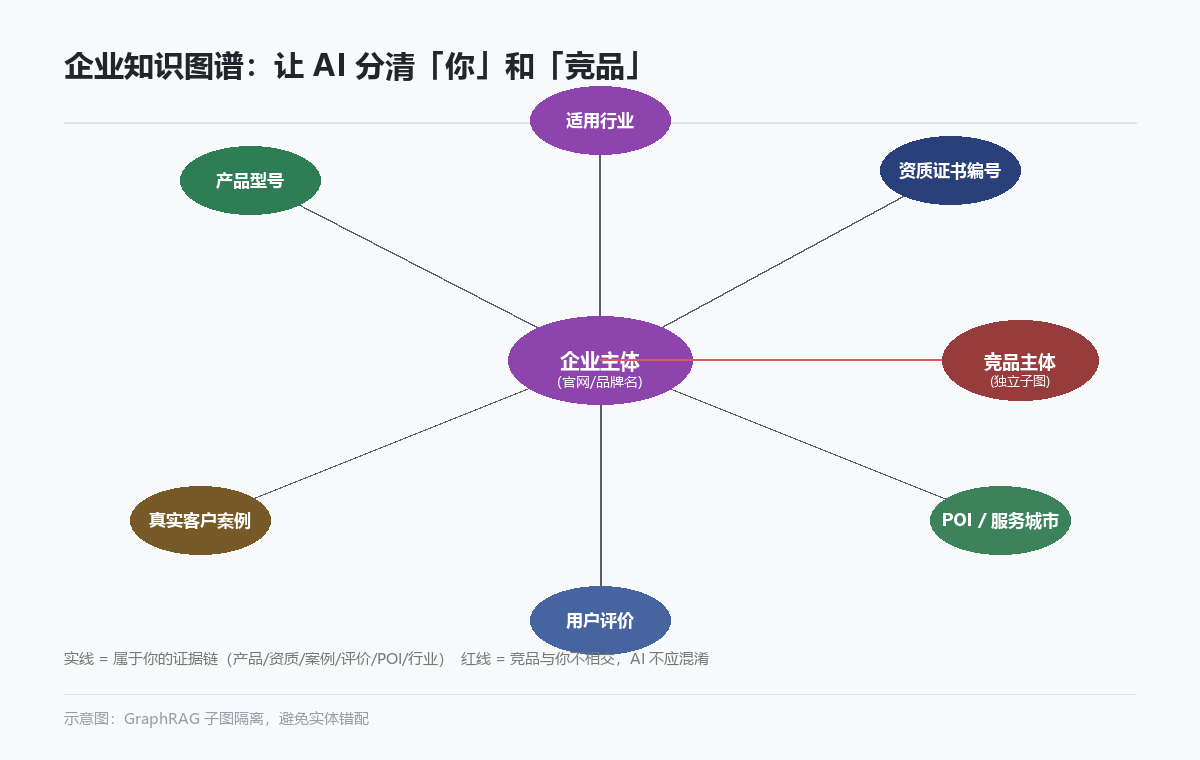
关键差异在于:实体边界是显式的。「你—生产—6204 轴承—适用—机床行业」是一条独立子图,「竞品—生产—另一型号」是另一条。两者不相交,AI 就不会把竞品的参数错配到你身上。
企业 GEO 怎么用 GraphRAG 思路:四步落地清单
- 实体对齐:把品牌名、产品名、别名、资质编号、服务城市列成一张表,全网统一写法。POI 也要对齐高德/百度/腾讯地图。
- 关系建模:用「主体—动作—对象」描述事实,例如「XX 公司—位于—苏州工业园区—服务—机床行业」,让 AI 能顺着关系追到答案。
- 证据链成网:把资质 → 案例 → 用户评价连到主体节点,形成可追溯的证据链,而不是各自孤立的软文。
- 多源一致:图谱里每个节点在全网说法一致。同一成立时间、同一服务范围,官网、视频、图文不能各写各的,否则 AI 直接降权。
传统 RAG 与 GraphRAG 在 GEO 上的差别
| 维度 | 传统 RAG | GraphRAG 思路 |
|---|---|---|
| 检索单位 | 文本片段 | 实体 + 关系子图 |
| 实体边界 | 隐含、易混淆 | 显式、可隔离 |
| 竞品错配 | 高发 | 子图不相交,显著降低 |
| 引用准确 | 依赖概率拼接 | 基于关系推理 |
| 落地成本 | 低 | 中(需抽实体/对齐) |
四个最容易踩的图谱坑
- 只发不抽:内容铺了一堆,但从没抽过实体关系,AI 看到的还是散片段,等于没做图谱。
- 实体名乱写:官网叫「XX 智能」,视频里叫「XX 科技」,图谱里是两个主体,权重被稀释。
- 关系断链:资质、案例、评价各发各的,没连回主体,证据链断成孤岛,可信度评分上不去。
- 竞品混谈:为蹭流量在正文里大段比竞品,却没隔离实体,反而把竞品节点权重喂高,帮对手做嫁衣。
常见问题
GraphRAG 和普通 RAG 差在哪
普通 RAG 把文档切块、按相似度召回片段,AI 拼不出「谁是谁、谁和谁有关系」。GraphRAG 先把文档抽成实体和关系、建成图谱,检索时先召回相关子图再生成,实体边界清晰,不容易把竞品的特征安到你头上。
中小企业也要上知识图谱吗
不一定自建复杂图谱。最小可用版本是「实体对齐表」:把品牌名、产品名、别名、资质编号、服务城市列成一张结构化清单,官网、视频、图文全网一致地用。这本身就是轻量 GraphRAG 的输入。
图谱怎么帮 AI 引用我而不是竞品
图谱里「你—生产—产品—适用—行业」和「竞品—生产—另一产品」是两条不相交的子图。AI 召回子图后,不会把竞品节点上的参数错配到你身上,引用准确率明显高于纯片段拼接。
先做哪一步最划算
先做实体对齐 + 多源一致性:统一全网品牌名、产品名、成立时间、服务范围。这一步不写代码也能做,却是后面所有图谱工作的地基,不一致的信息 AI 直接降权。
多发文解决不了 AI 张冠李戴。先把企业知识织成一张网——实体对齐、关系建模、证据成链、多源一致,这四步做完,AI 才真正分得清「你」和「竞品」,引用才落到你头上。