杭州一家口腔诊所,2026 年上半年花二十万拍了三条种植牙科普视频,每条都精修过。老板打开豆包搜「种牙哪家靠谱」,出来的还是同行官网和百科。他不服气:「我内容比他们好多了,凭什么 AI 不引我?」
答案不在内容好不好看,而在内容有没有被机器读出来的结构。AI 看不懂你的精修画面,它只读字幕转写、OCR 画面文字、alt 文本和 schema 标记。视频拍得再漂亮,没有这一层「机器可读层」,在 AI 眼里就是一段带背景音乐的黑盒。
多模态 GEO 到底是什么:给每个资产挂一层机器可读层
2026 年各平台都不再只认文字。豆包把短视频纳入核心信源,攻略类问题对抖音的引用率约 97.7%;DeepSeek、元宝也把视频和音频作为信源参与推理。但「发了视频」不等于「被引用」——AI 用的是视频里的字幕、画面文字和结构化标记,不是你的剪辑审美。
多模态 GEO 的本质,就是给文本、图片、视频三类资产,分别挂上 AI 能解析的机器可读层。下面这张三栏对照,是落地时最该照着做的清单。
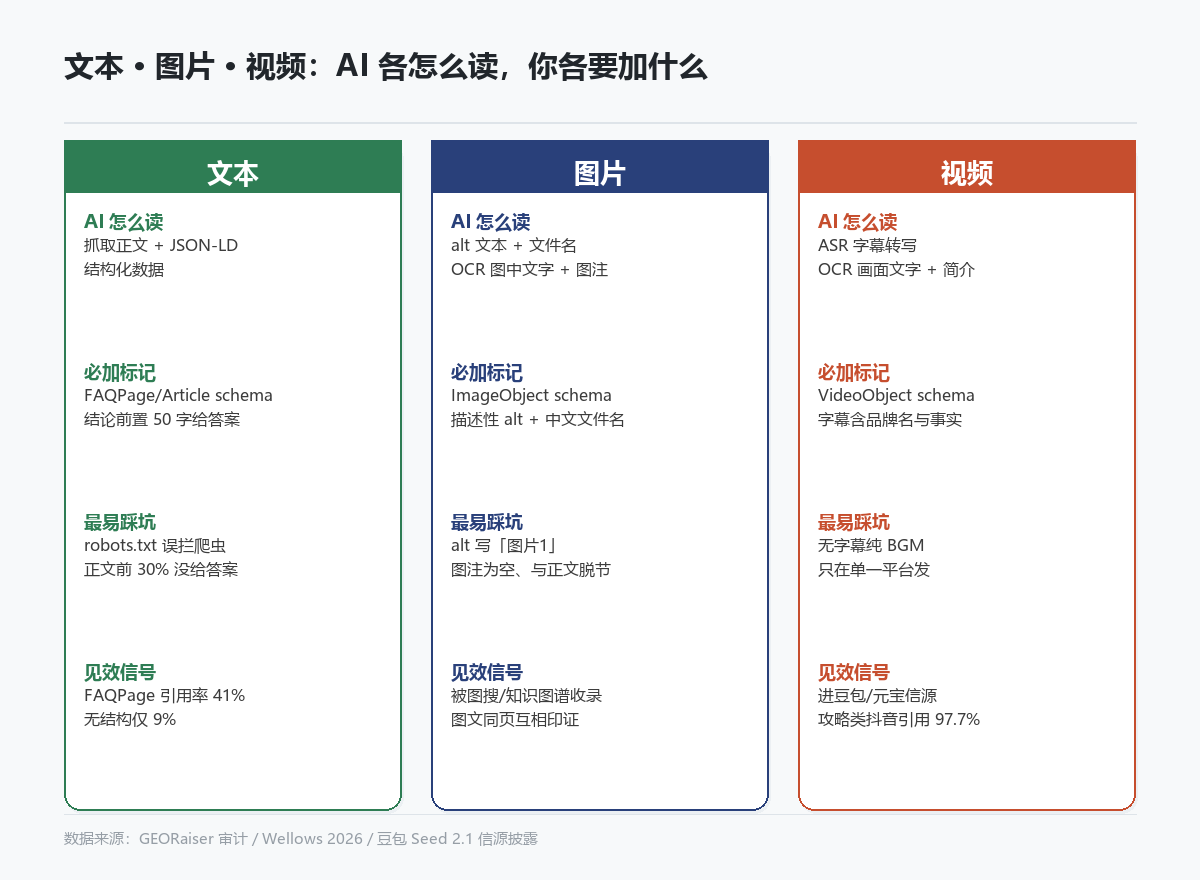
三栏实操清单:文本、图片、视频各做什么
| 维度 | 文本 | 图片 | 视频 |
|---|---|---|---|
| AI 怎么读 | 抓正文 + JSON-LD | alt + 文件名 + OCR | ASR 字幕 + 画面 OCR |
| 必加标记 | FAQ/Article schema | ImageObject schema | VideoObject schema |
| 最易踩坑 | robots 误拦爬虫 | alt 写「图片1」 | 无字幕纯 BGM |
| 见效信号 | FAQ 引用率 41% | 进图搜/知识图谱 | 进豆包/元宝信源 |
图片怎么做,AI 才读得懂
- alt 写「在讲什么 + 关键实体」:别写「图片1」「产品图」。例:alt=”苏州首誉机械轴承选型对照表,覆盖 6204 至 6310 型号公差”。
- 文件名用中文语义:
bearing-chart-6204-6310.png比img_0382.png友好得多。 - 配 ImageObject schema:标出 contentUrl 与 caption,让 AI 直接知道这张图是什么、属于哪篇内容。
- 图注别空着:图注是 AI 理解图片语境的辅助文本,和正文脱节就浪费了一次印证机会。
视频怎么做,AI 才愿意引
- 字幕里必须含品牌名和关键事实:型号、价格、资质、服务范围,写进 ASR 转写,而不是只放背景音乐。
- 挂 VideoObject schema:把 transcript/caption 链接、缩略图、时长标出来,AI 解析成本更低。
- 选 AI 在索引的平台发:想进豆包就上抖音/视频号,想进 DeepSeek 就同步微信生态与官网,单平台发等于主动弃权。
- 画面文字也要清清楚楚:OCR 会读屏幕上的字,核心数据用字幕条或贴片呈现,别只靠口播一闪而过。
四个最常被忽略的多模态坑
- robots.txt 误拦 AI 爬虫:GEORaiser 审计显示约 73% 站点误拦了至少一个 AI 爬虫(GPTBot/ClaudeBot/PerplexityBot),图视频再好也爬不到。
- JS 渲染、无静态文本:主流 AI 爬虫不执行 JS,页面内容只在脚本里生成就等于零内容,必须 SSR/静态化。
- 多平台说法不一致:官网写「成立于 2019」,视频里说「做了十几年」,AI 直接降权——多源一致性是采信前提。
- 只发不测:发完用豆包、DeepSeek、元宝各问一次「XX 哪家好」,看答案出没出你,没出就改标记,不要盲发。
常见问题
AI 爬虫真的会读图片和视频吗
会,但方式跟人不一样。图片靠 alt 文本、文件名、图注和 OCR 识别图中文字;视频靠字幕转写(ASR)、画面文字(OCR)和标题简介。主流大模型已在 2026 年把短视频和音频纳入核心信源,前提是内容里带了可被解析的结构化信息。
只发抖音,豆包会引, DeepSeek 会引吗
不一定。豆包对抖音/头条的引用权重极高(攻略类场景抖音引用率约 97.7%),但 DeepSeek 更偏微信生态、知乎、官方站。多模态内容也要遵循「多源一致性」:同一事实在官网、视频号、短视频、图文里说法一致,AI 才敢采信。
图片 alt 怎么写才有效
写「这张图在讲什么 + 关键实体」,别写「图片1」「产品图」。例:alt=”苏州首誉机械轴承选型对照表,覆盖 6204 至 6310 型号公差范围”。再配 ImageObject schema 标出 contentUrl 与 caption,AI 提取准确率明显更高。
视频没有字幕是不是白做
基本等于白做一半。AI 对视频的解析高度依赖 ASR 字幕转写,字幕里必须含品牌名和关键事实(型号、价格、资质),而不是只有背景音乐。再用 VideoObject schema 把 transcript/caption 链接挂上,被引用的概率才会上来。
多模态 GEO 不是比谁拍得贵,是比谁先给资产挂上机器可读层。今天就把官网图片补 alt、把视频补字幕和 VideoObject、把图文视频的说法对齐——这三件事做完,AI 才真正开始「看」得见你。